
人工智能技术文章
-
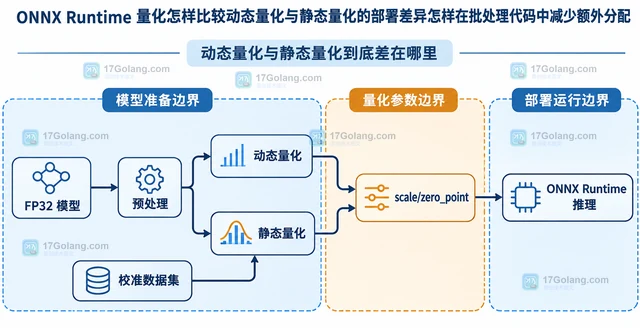 用同一份 ONNX 模型比较 ONNX Runtime 动态量化与静态量化的部署差异,说明校准数据、批处理、缓冲区复用、精度和硬件选择之间的关系。139 收藏
-
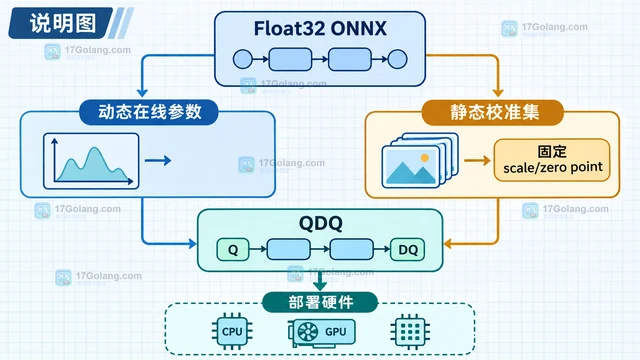 用同一份 ONNX 模型比较 ONNX Runtime 动态量化与静态量化,说明校准数据、输入契约、量化格式和中间激活如何造成空输出或结果偏差,并给出可复用的排查清单。242 收藏
-
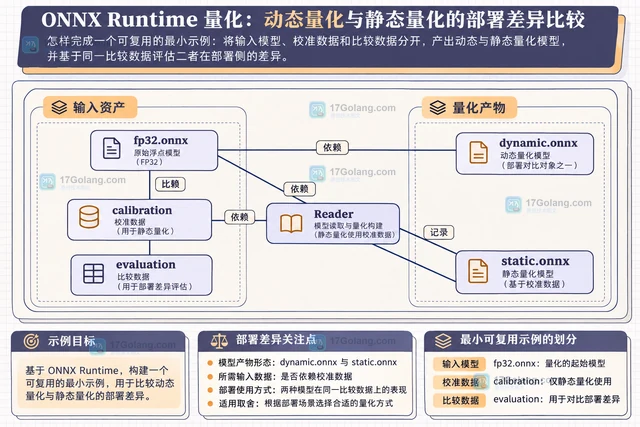 用自造 MatMul 模型演示 ONNX Runtime 动态与静态量化,分列产物大小、输出误差和热推理延迟,并说明校准数据、目标硬件、记录与回退的部署边界。374 收藏
-
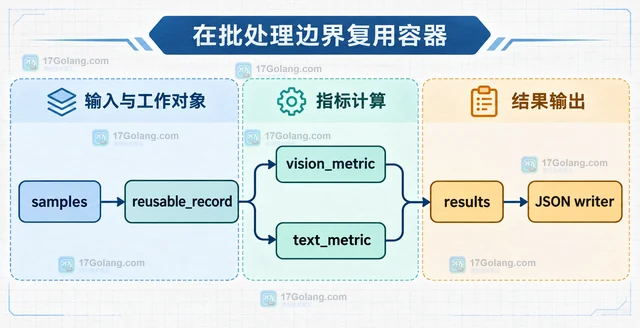 多模态评测同时包含图像理解和文本生成时,不要把所有分数塞进同一个字段。本文用 Hugging Face Evaluate 的指标分类思路设计分区结果对象,并通过复用容器、批量计算和一次序列化减少批处理中的额外分配。442 收藏
-
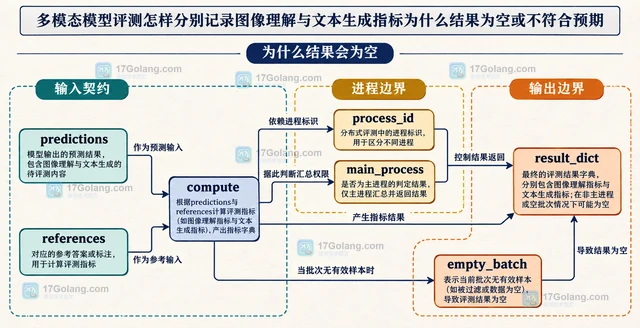 多模态模型评测不要把图像理解和文本生成塞进同一个指标调用。本文用统一样本记录、分离指标计算和结果命名空间,说明如何分别保存图像理解与文本生成指标,并从空数据、字段契约、分布式主进程和指标依赖四层排查结果为空或不符合预期。383 收藏
-
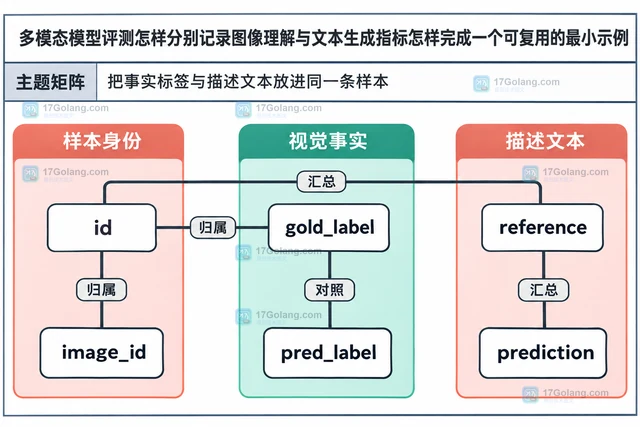 通过一份标准库离线评分示例,把视觉事实正确率与文本字符 F1 分开记录,保留逐条样本和版本信息,解释文本相似掩盖视觉错误的原因与真实评测的适用边界。289 收藏
-
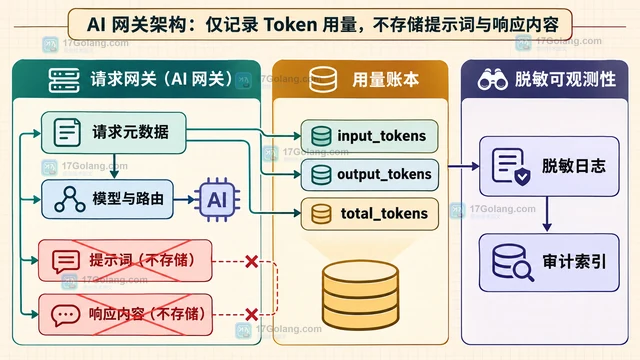 AI 网关可以在模型响应边界读取 input_tokens、output_tokens 和 total_tokens,只把请求标识、模型、延迟、状态与用量写入脱敏事件;本文说明如何拆分模型请求路径、观测路径和聚合账本,并处理流式、重试、缓存、权限与保留期边界。158 收藏
-
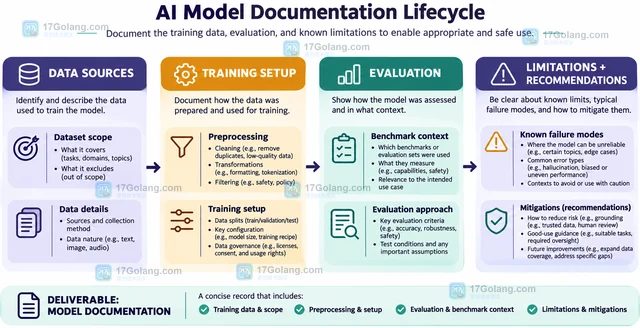 模型卡不只是模型简介,而是把用途、训练数据、训练过程、评估结果和已知限制放在同一份可维护文档中。本文以 Hugging Face Hub 的 README.md 模型卡为例,说明 YAML 元数据与正文怎样分工,以及未知信息如何如实标记。400 收藏
-
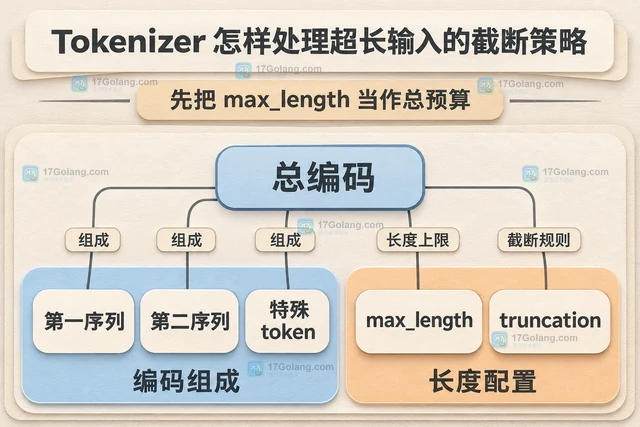 Tokenizer处理超长输入应明确token总预算、截断序列与保留方向。本文介绍Transformers的truncation策略、成对输入的only_second,以及用重叠窗口保留长材料的方法和限制。500 收藏
-
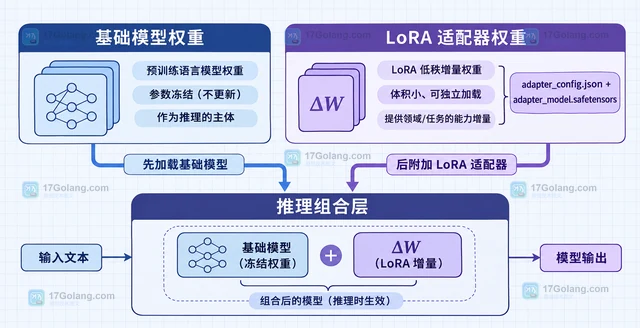 LoRA 适配器不是完整基础模型,通常应先加载兼容的基础模型,再用 PeftModel.from_pretrained 或 Transformers 的 load_adapter 挂载。本文说明多个适配器的命名与切换、unload 和 delete_adapter 的区别,以及保持分离和 merge_and_unload 合并部署的取舍。102 收藏
-
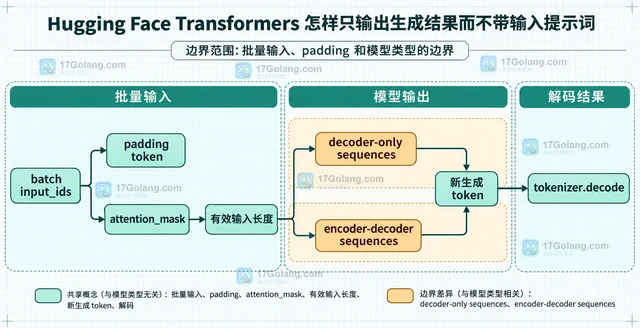 Hugging Face Transformers 的 generate 返回序列可能同时包含输入提示词和新生成 token。本文按 decoder-only、encoder-decoder、批量 padding 三种边界说明如何只解码新增内容,并解释 max_new_tokens、return_dict_in_generate 与 pipeline 输出的区别。145 收藏
-
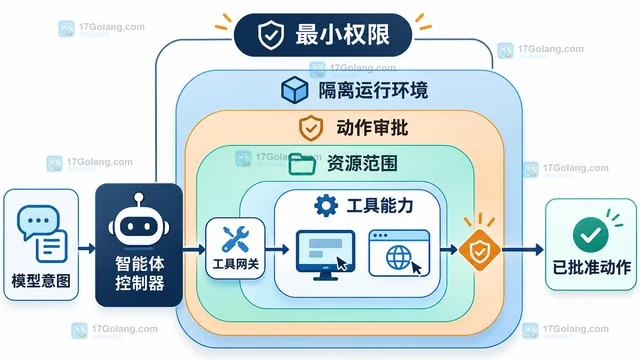 Holo4 这类计算机使用代理可以跨桌面、网页和移动端执行长流程任务,但不应该只用一个总开关管理权限。本文按工具能力、资源范围、动作审批和隔离运行环境四层拆解权限,并给出浏览器、文件系统与 Shell 的策略示例。212 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · vLLM KV Cache gpu-memory-utilization max-num-batched-tokens max-num-seqs 批处理显存
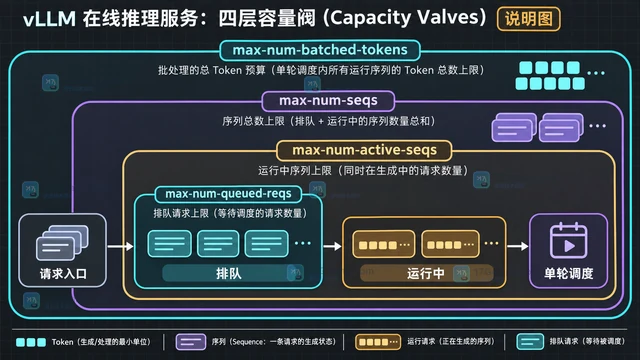 vLLM 的 gpu-memory-utilization 只划定单实例显存预算,不直接限制批处理条数。本文用 max-num-batched-tokens、max-num-seqs、max-num-active-seqs 和排队上限拆开说明显存、单轮批量与入口容量的配置边界。265 收藏
-
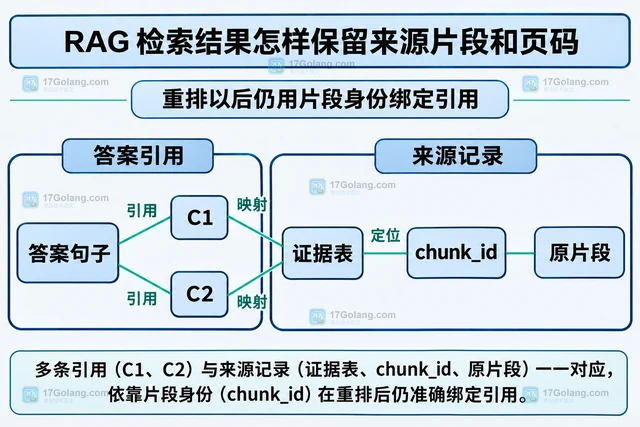 RAG应在解析和切分时保留文档版本、页位置及原文区间,并在检索重排后维持片段身份。本文给出来源字段设计、证据表绑定、旧索引迁移与页码缺失的处理方法。307 收藏
-
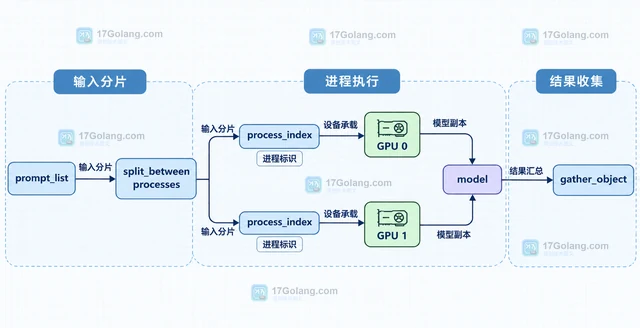 用 CUDA_VISIBLE_DEVICES 和 accelerate launch 明确可见 GPU 与进程数量,再通过 PartialState 读取每个进程的设备,给出多进程推理时的绑定、分片和排错方法。444 收藏