
人工智能技术文章
-
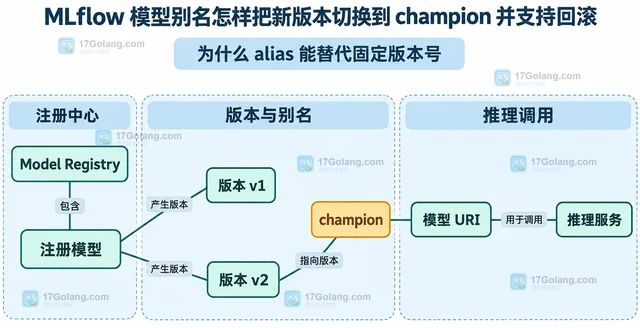 用 MLflow Model Registry 的 champion alias 解耦推理代码与模型版本:切换时指向新版本,出现问题时用同一接口回指旧版本。296 收藏
-
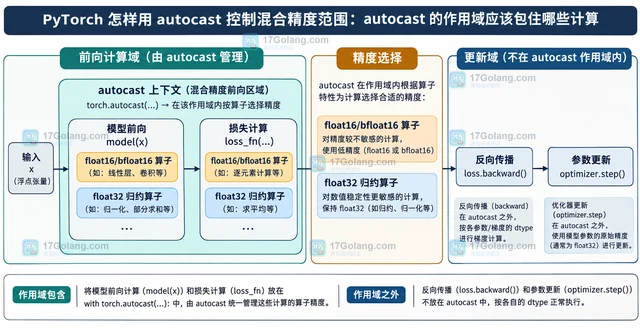 用 PyTorch 的 torch.autocast 控制混合精度范围:明确前向与损失计算的作用域,演示局部关闭 autocast 保留 float32,并说明 GradScaler、推理和常见边界。248 收藏
-
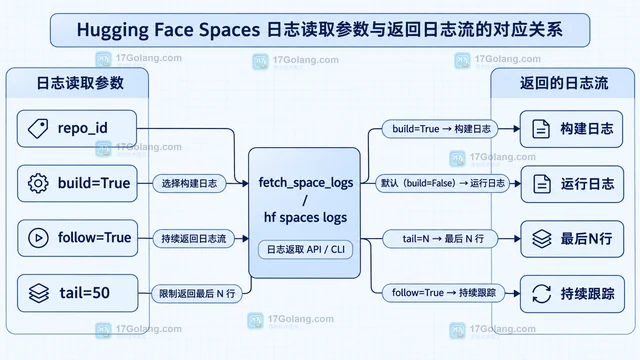 Hugging Face Spaces 排查失败时,先区分构建日志和运行日志,再用 hf spaces logs 或 fetch_space_logs 读取、截取和持续跟踪输出。322 收藏
-
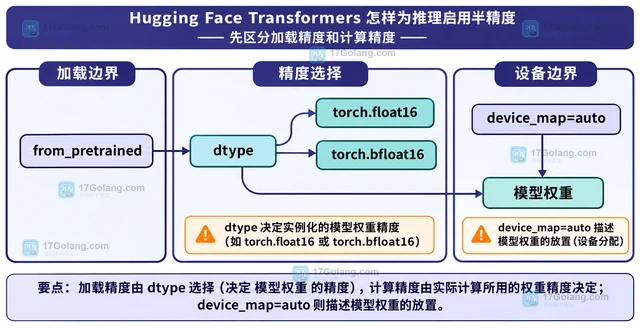 用 Transformers 做推理时,dtype 负责权重加载精度,autocast 负责前向计算精度。本文给出 float16、bfloat16 与 float32 的选择方法、代码示例和兼容性检查清单。212 收藏
-
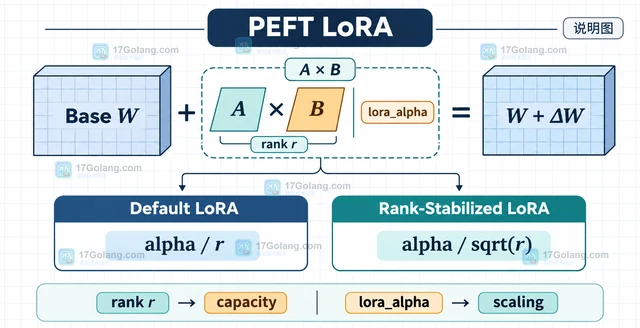 解释 PEFT LoRA 中 rank、lora_alpha 与适配器缩放因子的关系,比较默认 LoRA 和 rsLoRA 的公式,并给出可复查的 LoraConfig 配置与参数检查方法。441 收藏
-
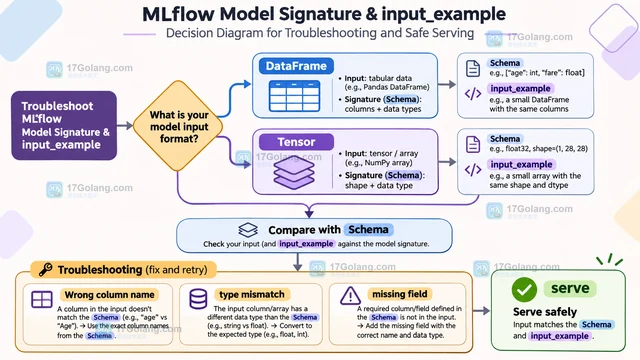 用一个 scikit-learn 分类小项目说明 MLflow 如何通过 input_example 自动记录模型签名,并从输入输出 schema 排查列名、类型和必填字段不匹配。428 收藏
-
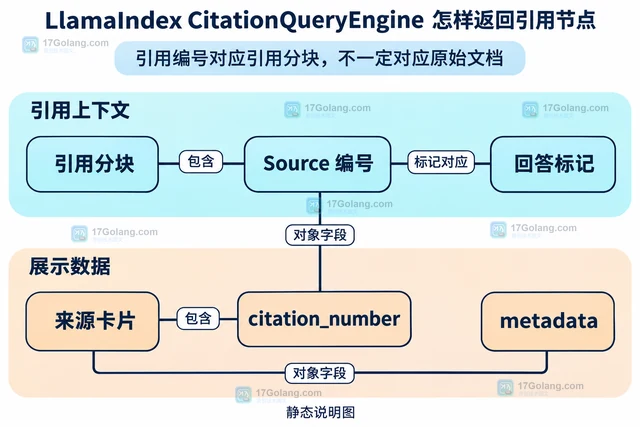 保留 CitationQueryEngine 的响应对象即可读取 source_nodes。通过示例整理引用节点、编号和来源卡片,说明分块粒度、元数据缺失、响应类型与前端展示的适用边界。111 收藏
-
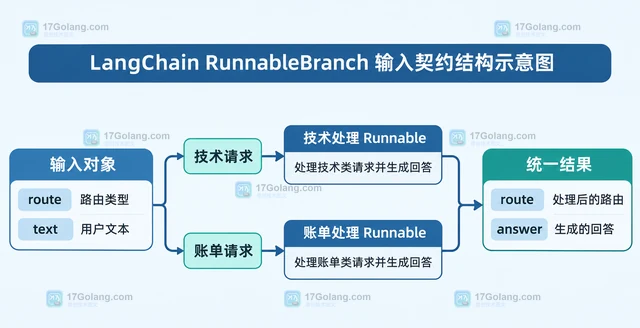 LangChain RunnableBranch 通过条件与 Runnable 对组成输入路由,按条件顺序选择第一个匹配分支,并用默认 Runnable 兜底。本文用统一输入输出契约演示如何构造、串接和控制它。160 收藏
-
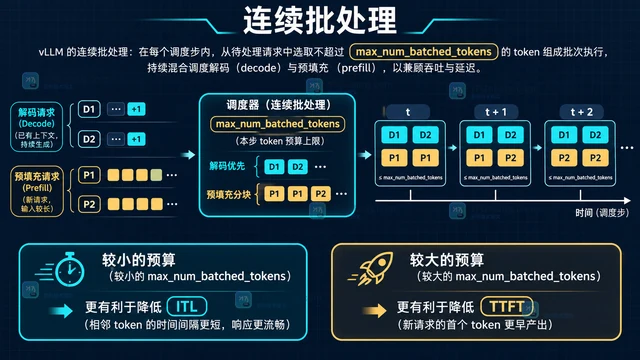 vLLM 的连续批处理 token 上限由 max_num_batched_tokens 控制。本文说明 Python 和 vllm serve 两种配置方式,并结合 ITL、TTFT、吞吐量、chunked prefill 与 KV Cache 给出调参边界。408 收藏
-
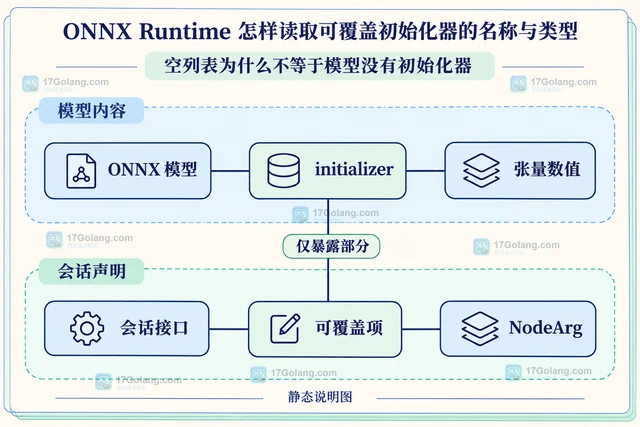 使用 ONNX Runtime get_overridable_initializers 读取可覆盖初始化器的名称、类型和形状,整理元数据报告,并区分空列表、加载异常、权重数值与性能结论。259 收藏
-
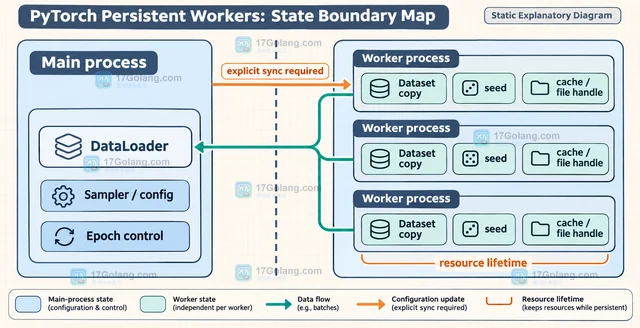 通过 persistent_workers=True 复用 PyTorch DataLoader 的多进程 worker,本文说明 DataLoader 的放置位置、Dataset 状态边界、参数取舍和关闭条件。440 收藏
-
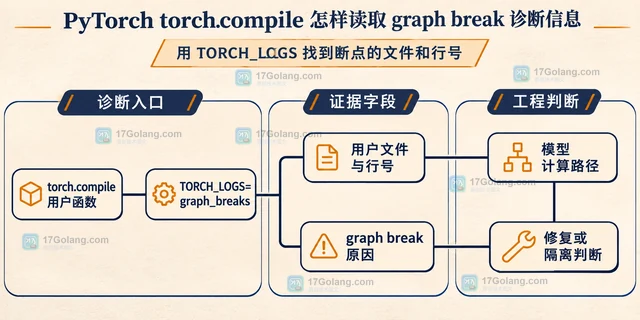 PyTorch torch.compile 遇到 graph break 时,先用 eager 基线确认问题,再通过 TORCH_LOGS=graph_breaks 和 torch._dynamo.explain 读取位置、原因与断点数量,最后根据代码错误、暂不支持行为或函数隔离选择修复方向。426 收藏
-
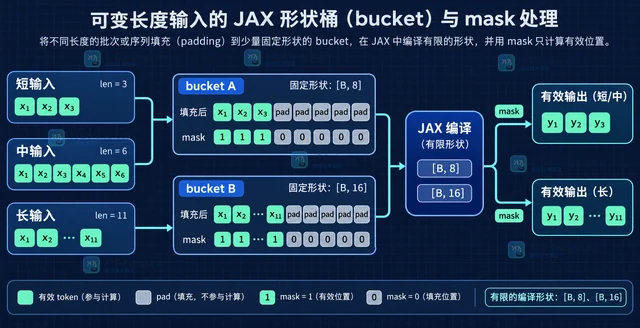 JAX jit 的缓存键包含输入的 shape 和 dtype,动态批次、可变序列长度或静态参数变化都可能触发重新编译。本文从日志定位入手,用 padding、分桶和稳定函数定义减少重复编译,并说明持久化编译缓存的适用边界。177 收藏
-
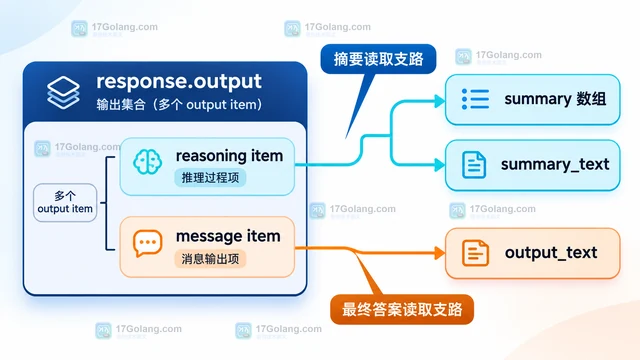 Responses API 不会默认返回 reasoning summary。本文用 reasoning.summary 开启摘要,遍历 reasoning output item 读取 summary_text,并说明 effort、output_text 与模型支持差异。123 收藏
-
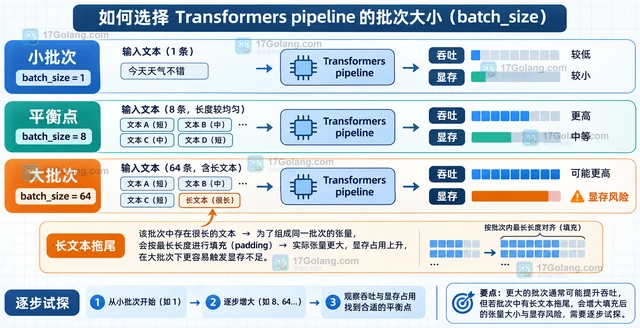 Transformers pipeline 支持列表、Dataset 和生成器输入。本文用文本分类场景说明如何设置 batch_size,解释 padding 与长文本造成的显存风险,并给出从小批次开始、同时记录吞吐和峰值显存的可回退配置方法。218 收藏