
人工智能技术文章
-
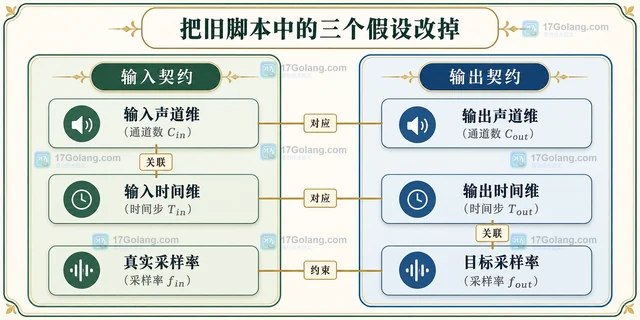 torchaudio多声道重采样应保留声道维并沿最后一维处理。结合48kHz到16kHz的张量示例,说明旧脚本迁移、采样率标签、核缓存及设备精度的配套修改。210 收藏
-
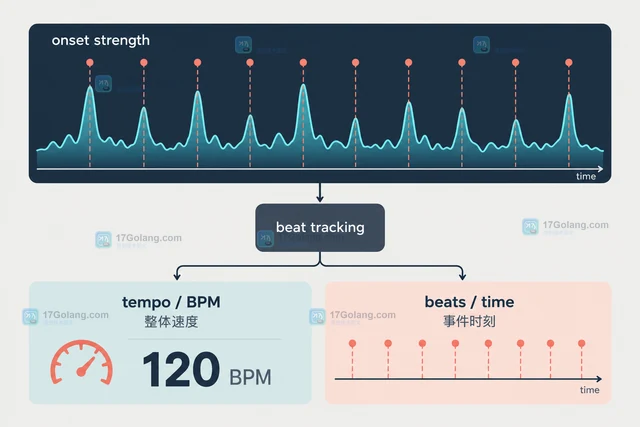 librosa beat_track 返回的 tempo 是速度估计,beats 是节拍事件位置。本文用实际调用拆解两者的单位、稀疏表示、时变 BPM 和常见误判,帮助你把节拍正确对齐到秒或帧。467 收藏
-
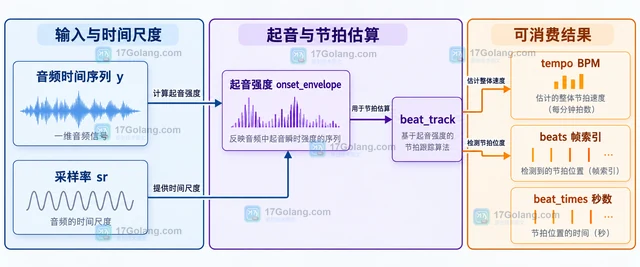 用 librosa.beat.beat_track 从音频的起音强度中估算 BPM 和节拍位置,并把帧索引稳定转换为秒;同时说明空结果、BPM 为 0 和 hop_length 不一致时怎样排查。444 收藏
-
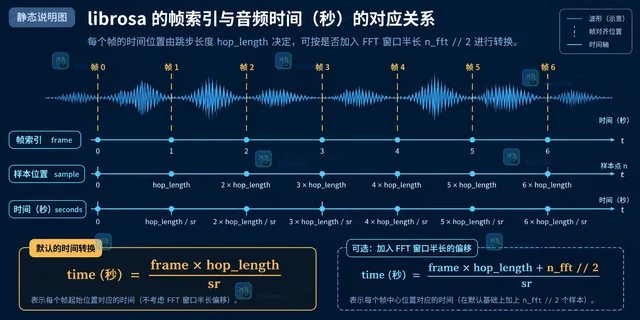 librosa 的 onset_detect 默认返回帧编号,可用 frames_to_time 按 sr 和 hop_length 换算成秒,也可以直接设置 units="time"。本文说明参数一致性、n_fft 偏移和回溯检测的时间边界。306 收藏
-
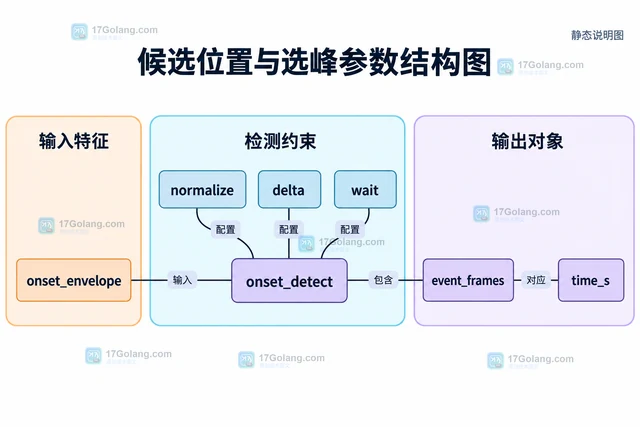 librosa可通过起音强度包络与选峰提取起音位置。本文给出短音频检测函数,说明采样参数、阈值、回溯和空结果处理,帮助区分起音候选、节拍与实际切割边界。484 收藏
-
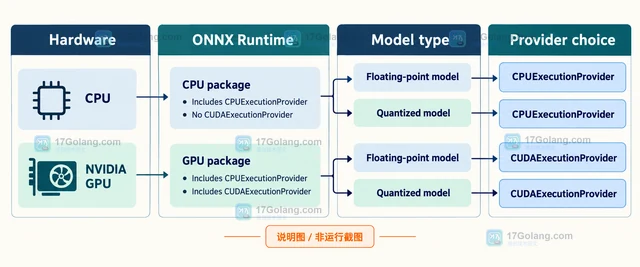 从 provider 能力检查、单一后端加载到 providers 优先级回退,说明 Optimum ONNX Runtime 如何选择执行提供程序,以及 CUDA、TensorRT、量化模型的常见边界。136 收藏
-
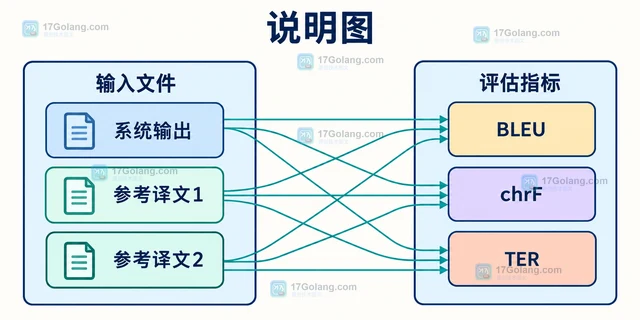 SacreBLEU 评估同一批机器翻译输出时,可以把多条参考译文作为多个位置参数传入,也可以按行合并为制表符文件并使用 --num-refs 声明参考数量。本文说明两种输入维度、常见误区和 BLEU、chrF、TER 的选择。131 收藏
-
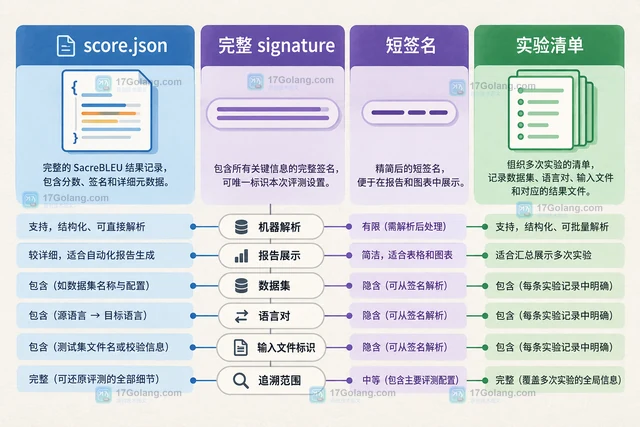 SacreBLEU 的分数不能脱离 tokenizer、大小写、平滑方式和版本单独保存。本文比较 JSON 完整记录、短签名和自有清单三种归档方式,给出可复用的命令与选择建议。230 收藏
-
 JiWER 计算语音识别误差时,参考文本与识别文本必须经过相同的正规化规则。本文用 Compose 组合清理与替换步骤,并将同一个变换对象同时传给两侧,说明 WER、CER 和自定义词替换的写法。413 收藏
-
 JiWER 不只返回 WER 数字,还能通过 process_words 得到逐句的 AlignmentChunk 对齐对象。本文说明 WordOutput.alignments 的结构、四类词位操作、四个索引字段,以及如何用 visualize_alignment 输出可读的对齐文本。392 收藏
-
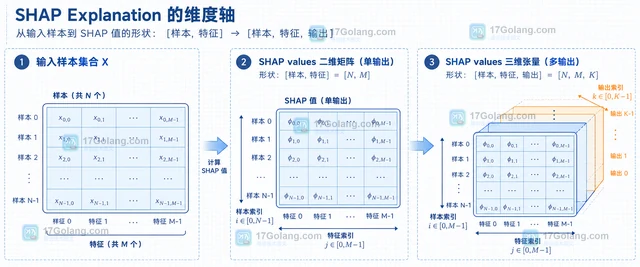 SHAP Explanation 的 values 形状需要结合样本、特征和模型输出一起读取。本文用单输出与多输出示例说明 shape、feature_names、output_names 的对应关系,以及如何按样本和输出安全切片。438 收藏
-
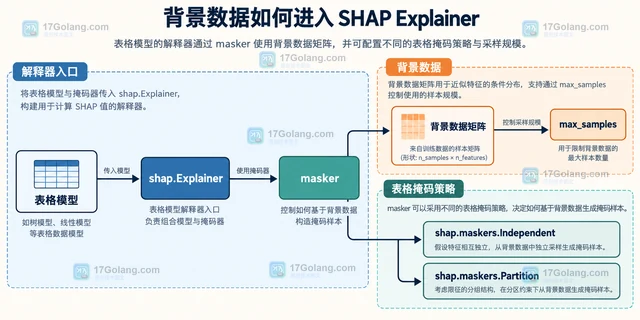 SHAP Explainer 可以用 NumPy 数组或 pandas DataFrame 作为表格背景数据。本文比较 Independent 与 Partition 的遮罩假设,说明 max_samples、特征相关性和字段一致性如何影响解释基线,并给出可直接改造的初始化代码。455 收藏
-
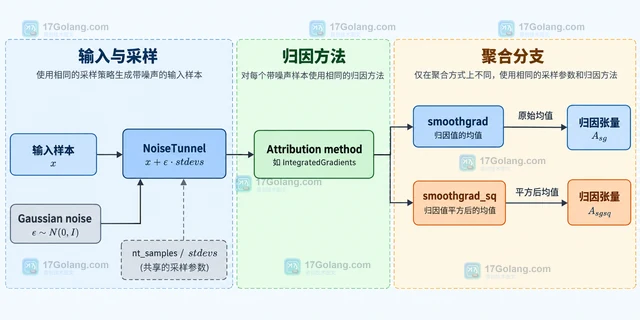 Captum NoiseTunnel 的 SmoothGrad 与 SmoothGradSquared 都会对加噪输入重复计算归因,但前者聚合原始归因均值,后者聚合平方后的归因均值。本文用公式、代码和选型表说明符号、强度与参数边界。450 收藏
-
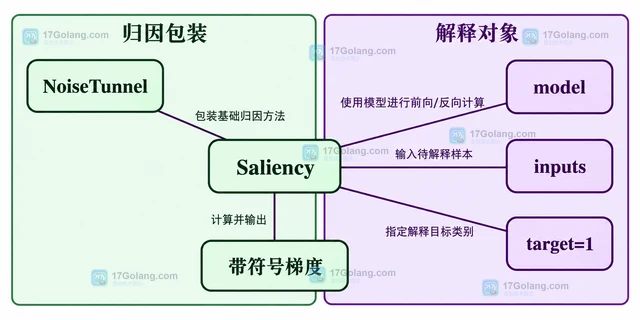 通过固定权重示例说明Captum NoiseTunnel如何包装Saliency完成多次加噪归因,介绍采样数、噪声幅度、分批处理,以及解释服务的资源限制与配置记录。500 收藏
-
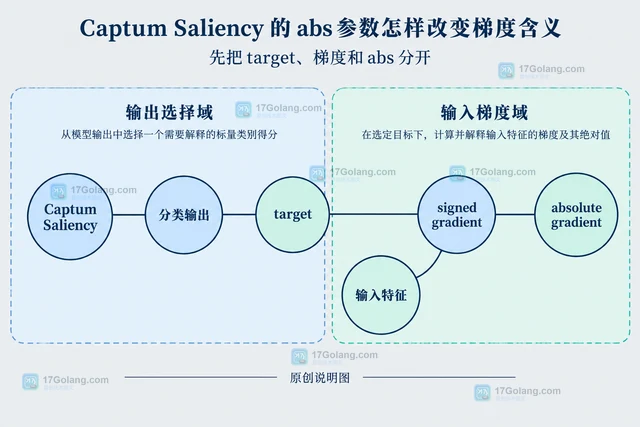 Captum Saliency 的 abs 默认会把输入梯度取绝对值。本文用固定线性分类器对比 abs=True 与 abs=False,说明方向、幅度、target 和输入形状各自代表什么,以及如何避免把梯度误当成概率或因果结论。303 收藏