
人工智能技术文章
-
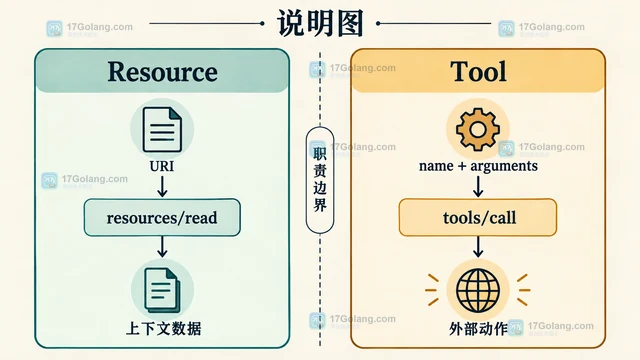 MCP 中 Resource 负责按 URI 提供可读取的上下文,Tool 负责按名称和参数执行能力。本文从发现消息、调用边界、权限审计和错误分层说明两者的实现方法。359 收藏
-
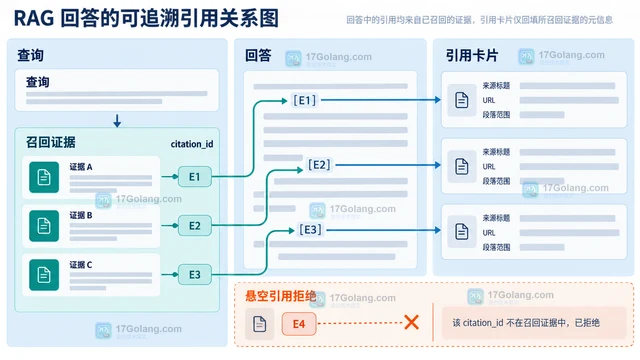 RAG回答要可追溯,关键不是把链接拼到末尾,而是让每个检索片段从入库开始就带有稳定来源身份、位置和引用编号。本文给出证据记录、提示词传递、引用渲染与回归检查的实现方法。171 收藏
-
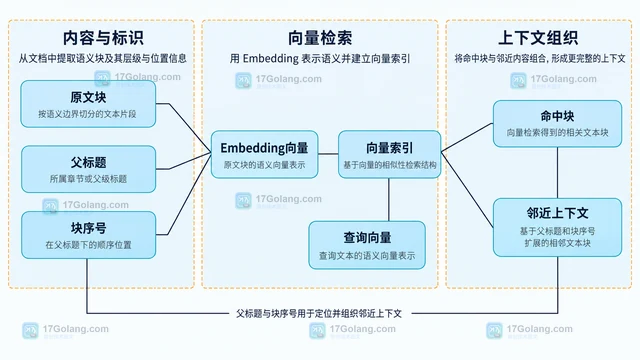 长文档切分不应只看字符数。本文用标题、段落、代码块和 token 预算建立语义分块,为每块保存章节元数据,再通过 Embedding 建索引并在召回时补回邻近上下文。234 收藏
-
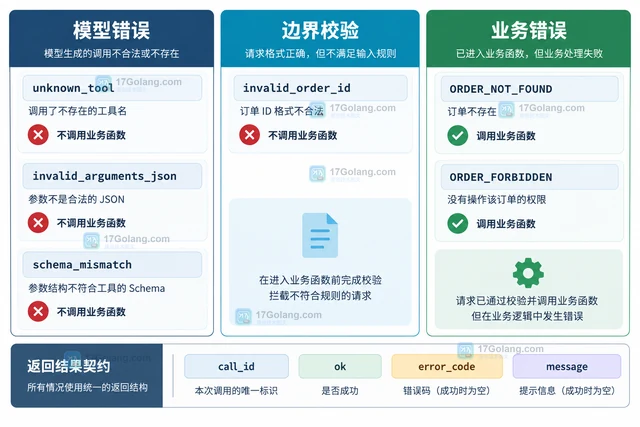 Tool calling 接入业务工具时,先用 JSON Schema 和应用层校验拦截模型参数问题,再把订单不存在、无权限等领域失败转换为稳定的工具结果。本文给出错误分层、Python 示例和重试边界。380 收藏
-
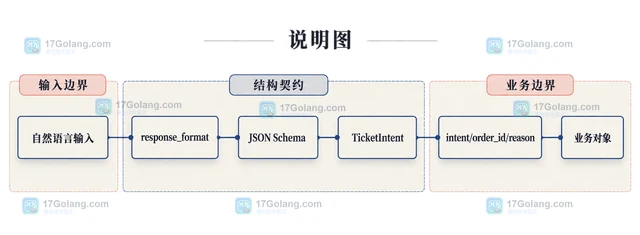 用 Structured Outputs 和 Pydantic 固定模型字段、类型与枚举,并区分正常解析、明确拒答、截断响应和业务校验失败,建立可落地的 JSON Schema 结果兜底方案。191 收藏
-
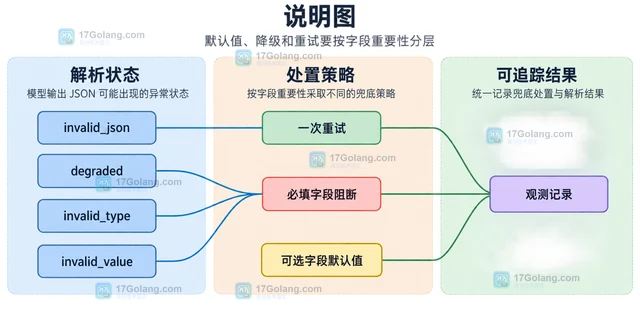 模型返回 JSON 时,缺字段不等于所有异常都能用默认值修复。本文用解析、归一化、验证三层设计兜底策略,区分可选字段、必填字段、类型错误和无法恢复的响应,并给出 Python 示例。272 收藏
-
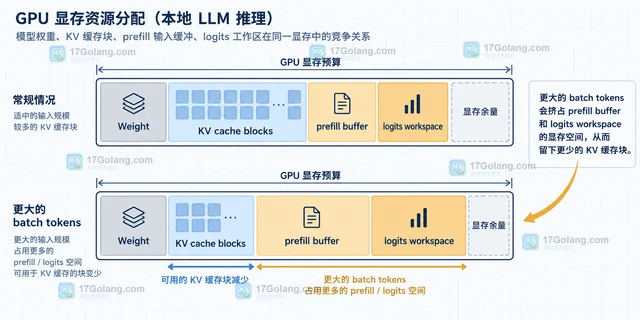 本地大模型推理中,KV cache 容量和 batch size 共享显存预算。本文从输入长度、并发、TTFT、TPOT 与长尾延迟出发,给出可落地的配置起点、压测矩阵和超限回退策略。251 收藏
-
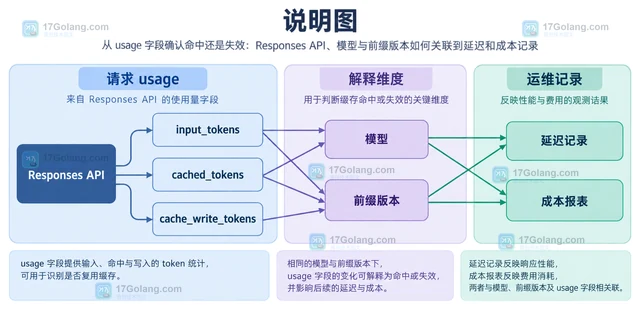 围绕 AI 提示词缓存的稳定前缀组织请求,说明固定指令、工具 schema 与动态问题的排列方法,并用 cached_tokens、cache_write_tokens 和版本化回滚定位缓存失效。357 收藏
-
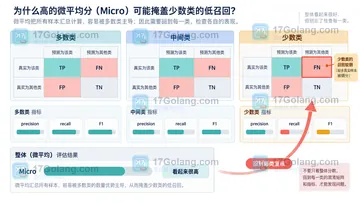 分类评测集不均衡时,macro 与 micro 不是谁更高级的问题,而是按类别平均还是按样本汇总。本文用统一口径、混淆矩阵和复核清单解释两者差异。473 收藏
-
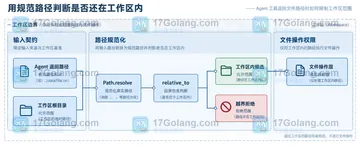 Agent 工具返回的文件路径不能直接信任。本文用工作区根目录、Path.resolve 和 relative_to 组成边界检查,处理绝对路径、目录穿越、符号链接与读写权限分离。381 收藏
-
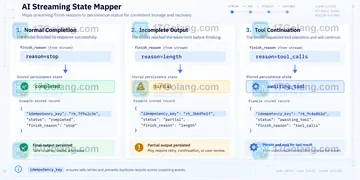 流式 AI 输出不应在最后一段文字到达时直接入库。本文用 finish_reason、状态机和幂等键说明何时保存正式结果,何时保留 partial 草稿或等待工具调用。195 收藏
-
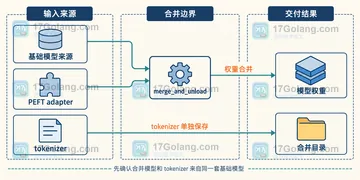 LoRA 合并只处理 adapter 权重,不会自动替你保存正确的 tokenizer。本文用一套可复用的核对脚本检查词表、特殊 token、长度配置和嵌入尺寸,避免合并模型上线后出现输入映射不一致。162 收藏
-
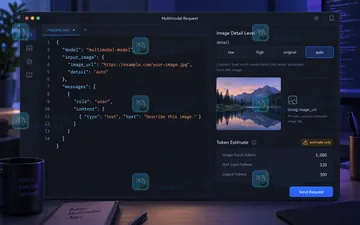 多模态请求的图片细节等级会改变视觉输入 token,但成本不能只看 low 或 high。本文比较 low、high、original、auto 的适用场景,并给出请求写法、成本拆分和质量复核方法。246 收藏
-
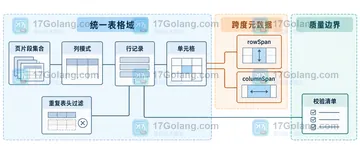 OCR 表格跨页合并不能简单拼接文本。本文从页级表格、重复表头、列位归一化和跨页断行四个边界入手,给出可落地的合并伪代码与结果检查清单。145 收藏
-
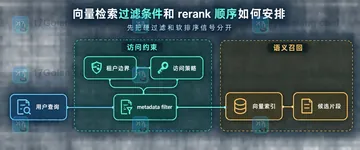 向量检索通常应先执行租户、权限、状态和时间等硬过滤,再做向量或混合召回与 rerank,最后应用阈值、去重和多样性检查,本文给出可落地的判断顺序。409 收藏