
人工智能技术文章
-
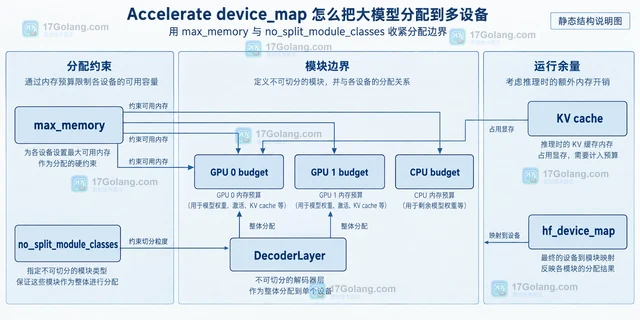 通过 Transformers 与 Accelerate 的 device_map=auto、max_memory 和 no_split_module_classes,把大模型稳妥分配到多张 GPU,并检查 CPU 或磁盘卸载边界。150 收藏
-
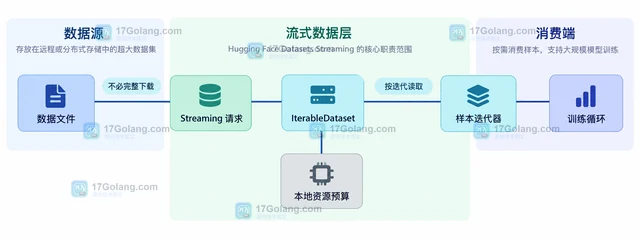 Hugging Face Datasets Streaming 通过 IterableDataset 边迭代边读取超大数据集。本文给出加载、抽样、缓冲打乱、在线变换、分片与训练观测的完整用法和适用边界。148 收藏
-
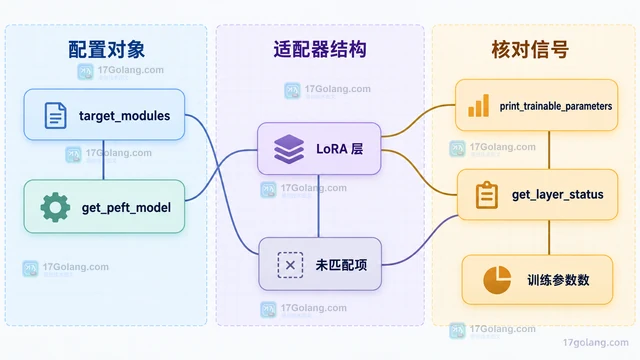 说明 PEFT LoRA 的 target_modules 如何按模型模块树、任务范围和参数预算选择,并给出默认目标、all-linear、MoE 特例与命中检查方法。251 收藏
-
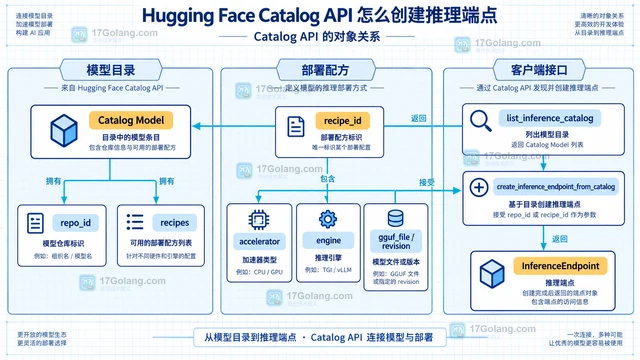 讲清 Hugging Face Catalog API 的模型与配方关系,并用 huggingface_hub 完成目录筛选、精确创建、状态等待和成本控制。333 收藏
-
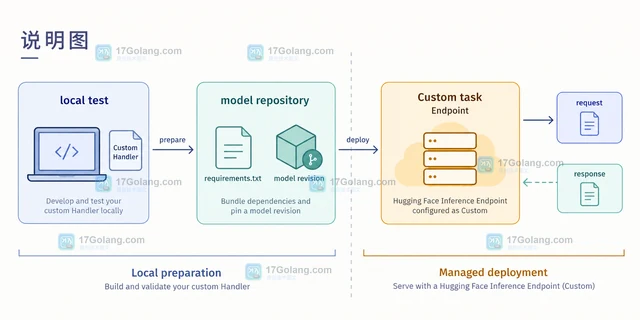 从 handler.py 的 EndpointHandler 结构、依赖管理、本地测试到 Custom 任务部署,说明 Hugging Face Inference Endpoint 编写自定义 Handler 的完整边界。145 收藏
-
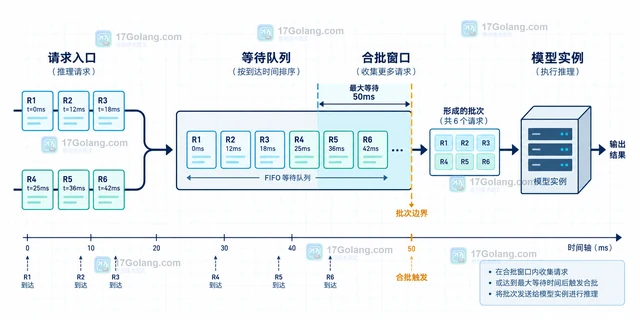 模型服务的批处理不是把 batch size 调大就结束。本文用 Triton 动态批处理和 TGI 连续批处理说明如何设置排队等待上限、批量或令牌预算,并用队列长度、prefill/decode 时长与端到端 p95 验证吞吐收益。479 收藏
-
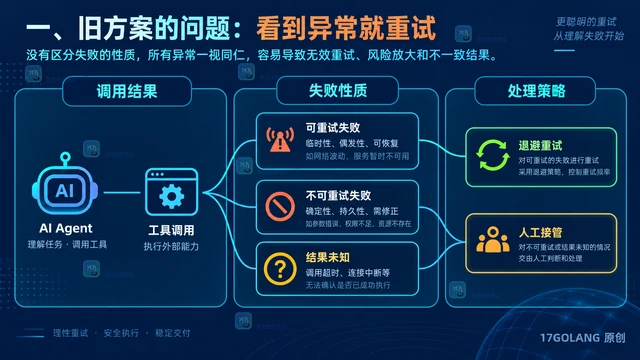 AI Agent 的工具调用失败可能是拒绝、超时或结果未知。本文给出失败分类、稳定幂等键、结果复用、指数退避与人工接管的完整设计,避免重复副作用。236 收藏
-
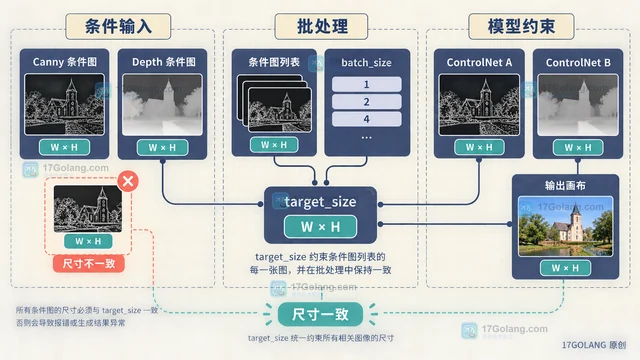 讲清 Diffusers ControlNet 条件图与生成画布的尺寸匹配方法,覆盖等比补边、居中裁切、多 ControlNet 和批量输入检查。314 收藏
-
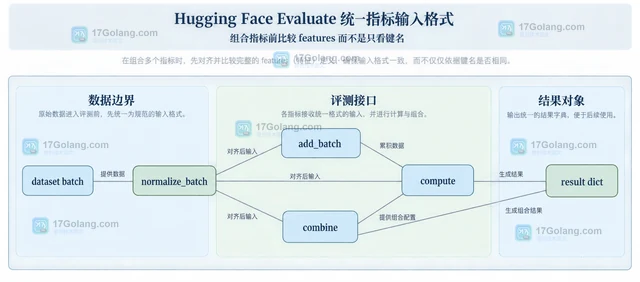 统一 Hugging Face Evaluate 输入时,应该统一 predictions 和 references 的批次外壳,同时以 metric.features 保留每个指标的元素类型与嵌套边界。本文给出适配器写法、compute 与 add_batch 共用方式,以及组合指标前必须检查的兼容条件。134 收藏
-
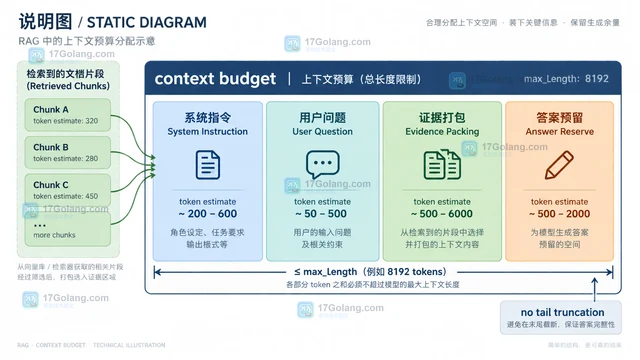 RAG 检索结果不要直接按 top_k 全量送入模型。本文用文档身份、规范化文本和语义多样性三层策略去重,再按系统指令、问题、证据与回答余量分配上下文预算,给出可迁移的 Python 实现与参数调优指标。357 收藏
-
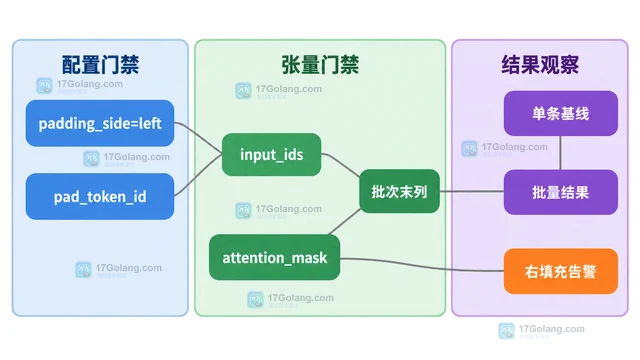 说明 decoder-only 模型批量生成时 padding_side 为什么应设为 left,并结合 input_ids、attention_mask 和生成起点排查对齐问题。206 收藏
-
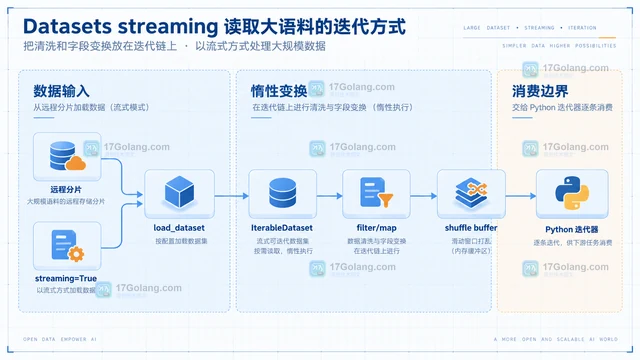 Hugging Face Datasets 的 streaming 模式会返回 IterableDataset,按迭代按需读取远程或本地分片。本文给出变换、缓冲区打乱、多 worker、训练轮次和检查点恢复的生产写法。337 收藏
-
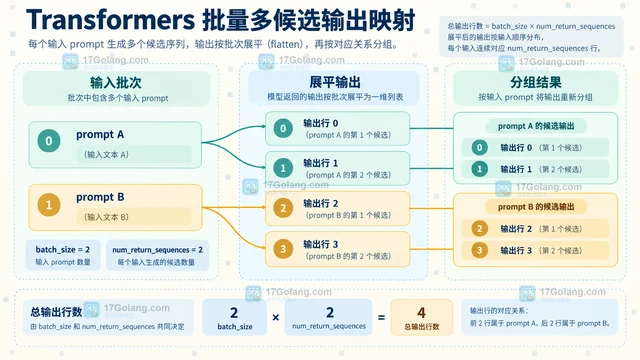 梳理 Transformers generate 的 EOS、max_new_tokens、stop_strings 与自定义 StoppingCriteria,演示批量提示词、多候选返回、纯新增 token 解码和输出分组。133 收藏
-
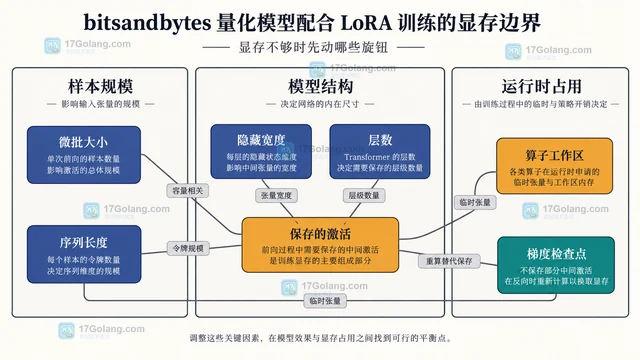 bitsandbytes 4-bit 量化只压缩冻结基座权重,LoRA 参数、梯度、优化器状态、激活与 CUDA 工作区仍会占用显存。本文给出 NF4 配置、峰值测量方法和 OOM 调整顺序,说明 QLoRA 单卡训练的真实边界。249 收藏
-
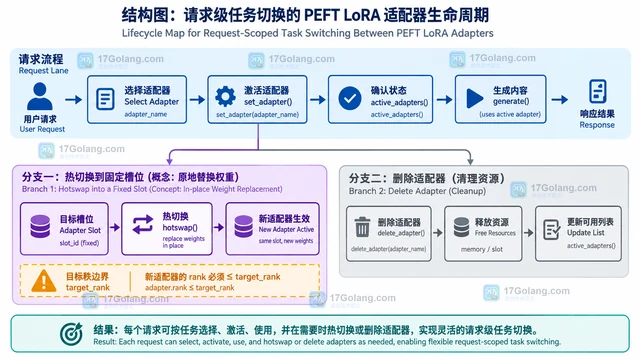 在同一个基础模型上预加载多个 PEFT LoRA 适配器,使用唯一名称和 set_adapter 按任务切换,并说明 delete_adapter、unload 与 hotswap 的生命周期边界。268 收藏