
人工智能技术文章
-
科技周边 · 人工智能 | 2星期前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
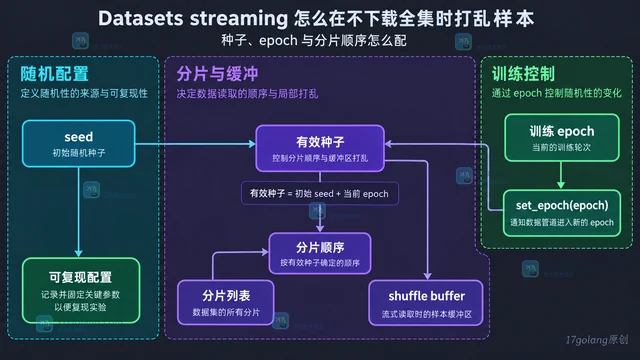 Hugging Face Datasets 的 streaming 模式可用 IterableDataset.shuffle 在有限缓冲区内随机采样,无需下载完整数据集。本文说明 buffer_size、seed、set_epoch、分片顺序以及 take/skip 的调用边界。470 收藏
-
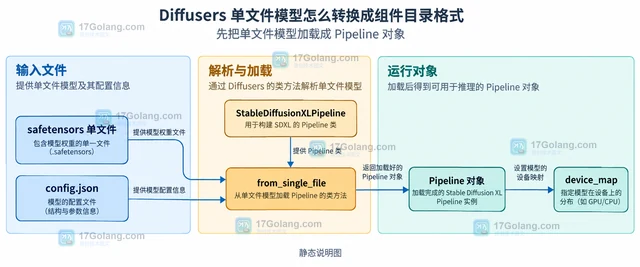 Diffusers 单文件模型不能靠改后缀变成组件目录。正确做法是用匹配的 Pipeline.from_single_file() 读取权重,再用 save_pretrained() 保存配置、组件子目录和权重文件;配置推断失败时显式提供 config。308 收藏
-
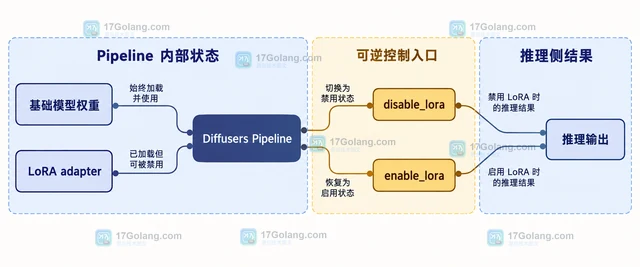 Diffusers 临时禁用 LoRA 不需要卸载权重,调用 disable_lora() 可回到基础模型推理,随后用 enable_lora() 恢复;本文同时区分卸载、删除和多适配器场景。309 收藏
-
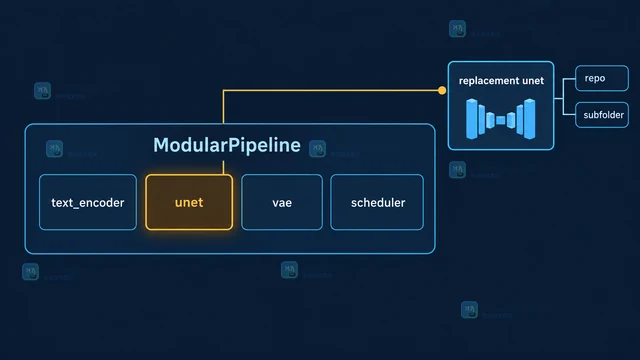 Diffusers ModularPipeline 替换单个模型组件时,应先取得组件规格并加载兼容对象,再用 update_components 更新同名槽位。本文说明两种替换写法、加载顺序、配置型组件区别和排错清单。175 收藏
-
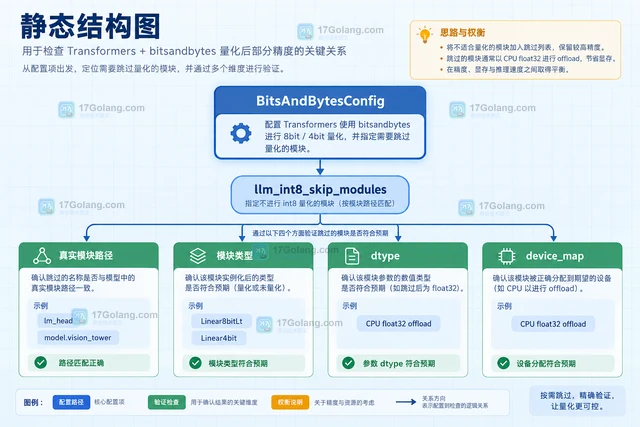 讲清 Transformers 使用 bitsandbytes 进行 8-bit/4-bit 量化时,如何用 llm_int8_skip_modules 保留指定模块,并区分跳过量化、dtype 与 CPU float32 offload。359 收藏
-
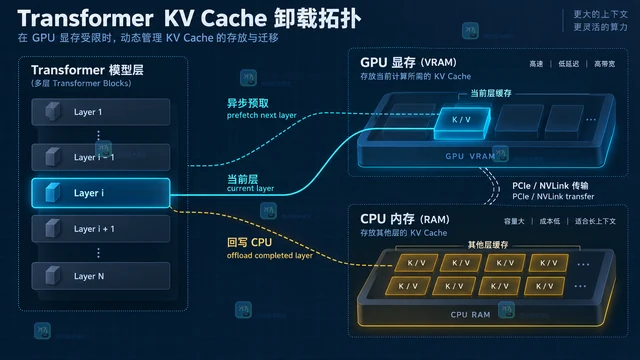 本文说明 Transformers 在显存不足时如何启用 KV cache 卸载,并给出直接配置、OOM 回退、方案选择与风险检查清单。499 收藏
-
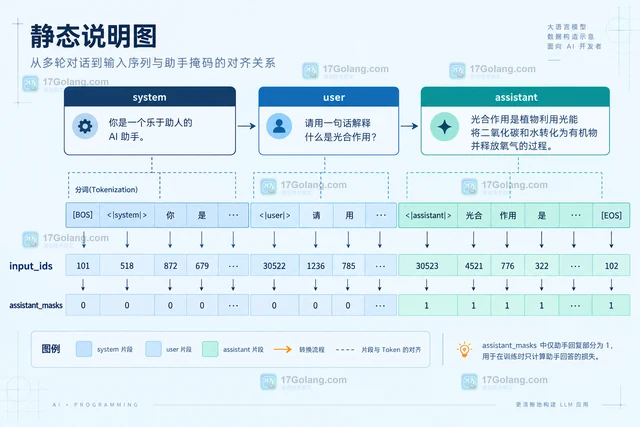 Transformers 的 apply_chat_template 可以通过 generation 块记录 assistant 内容,并返回与 input_ids 对齐的 assistant_masks。本文说明参数组合、模板写法、训练标签转换和全零掩码排查边界。164 收藏
-
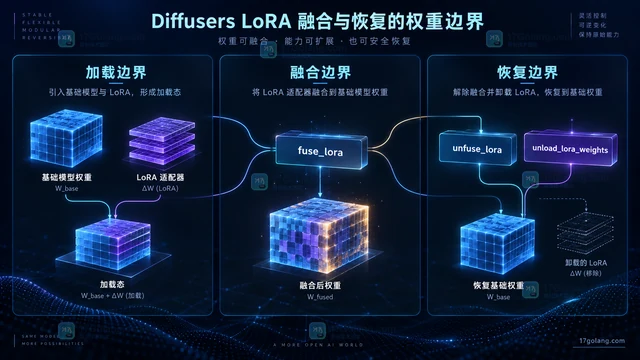 Diffusers 单个 LoRA 融合后可先 unfuse_lora 恢复基础权重,再卸载适配器;多 LoRA 或已保存重载的融合模型应重新加载原始基础模型。291 收藏
-
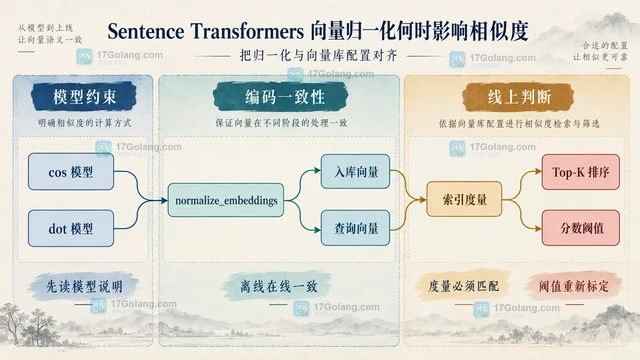 Sentence Transformers 的 L2 归一化不会改变余弦方向,但会改变原始点积和部分距离。本文用对照实验说明何时开启 normalize_embeddings。372 收藏
-
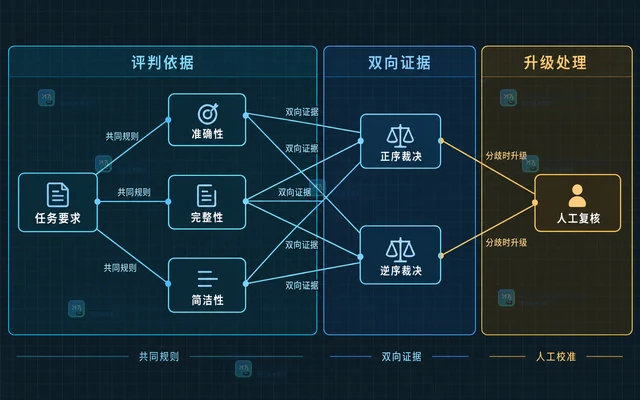 减少大模型裁判的位置偏差,不能只在提示词里要求公平,而应对同一回答对同时运行 A-B 与 B-A 两种顺序,统一还原答案身份,只合并一致判定,并把翻转样本升级为不确定或人工复核。314 收藏
-
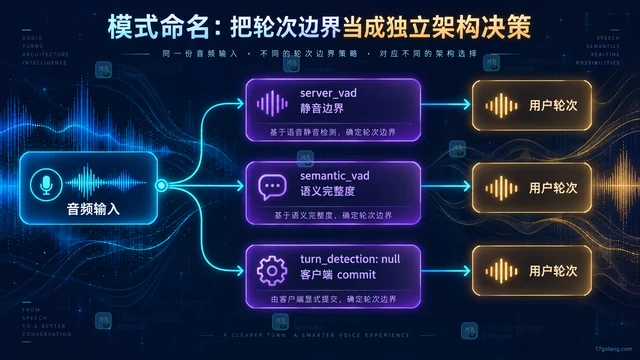 OpenAI Realtime API 可通过 session.audio.input.turn_detection 配置 server_vad、semantic_vad 或关闭 VAD。本文讲清阈值、静音时长、eagerness、自动响应与手动提交的取舍。293 收藏
-
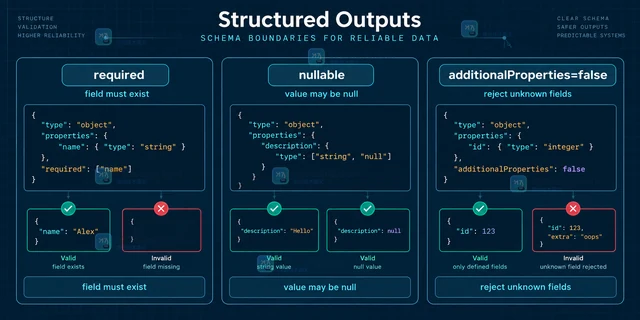 用 OpenAI Structured Outputs 约束嵌套 JSON 时,关键是逐层声明 required,并在每个 object 节点关闭 additionalProperties,再用 nullable 表达业务可选值。247 收藏
-
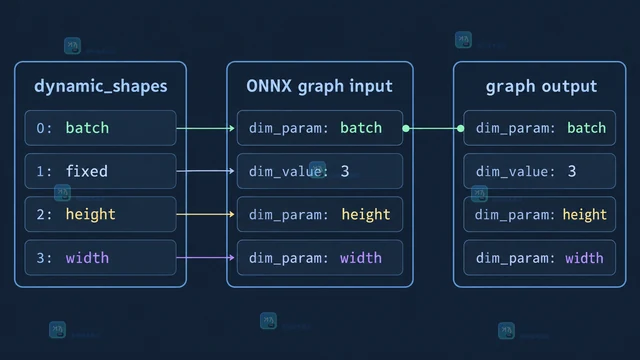 PyTorch 当前 ONNX 导出器应优先用 dynamic_shapes 声明动态输入轴,旧导出路径才使用 dynamic_axes。本文给出 batch、高宽动态的最小写法、元数据检查与常见误区。194 收藏
-
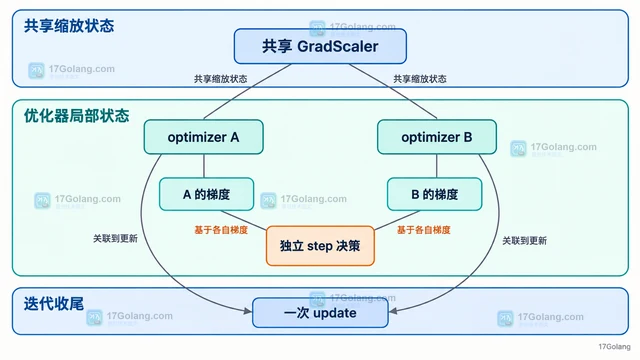 GradScaler 会在反缩放后的梯度含 inf 或 NaN 时跳过对应优化器的 step。本文说明单优化器、多优化器、scale 回退与学习率调度器的判断边界。268 收藏
-
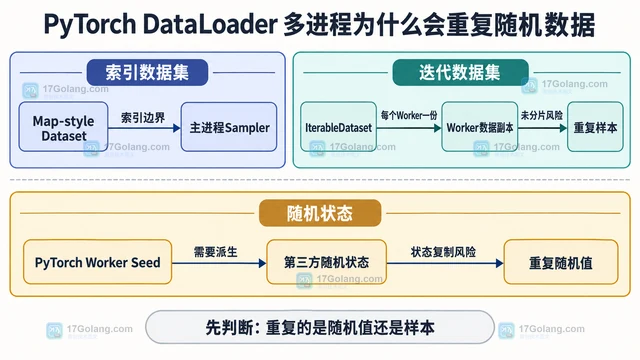 排查 PyTorch DataLoader 多进程中的重复随机值与重复样本,说明 worker seed、第三方随机库、IterableDataset 分片和 generator 的正确配置。316 收藏