
Go语言技术文章
-
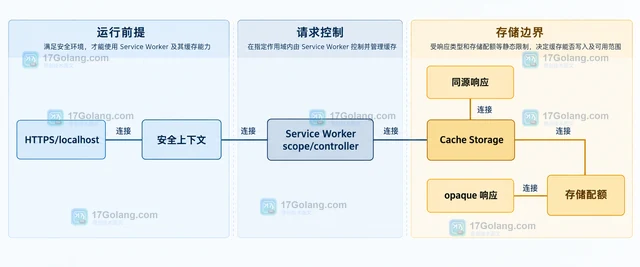 Service Worker 缓存策略突然不生效时,不要先把现象归结为统一的新限制。本文按安全上下文、控制权、响应类型、存储配额、请求匹配和缓存生命周期给出一套可执行的排查顺序。361 收藏
-
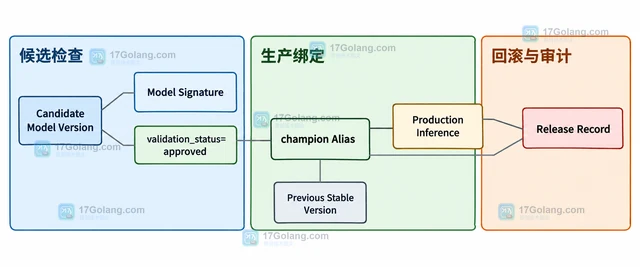 MLflow Model Alias 可以把生产代码从固定模型版本号解耦出来。本文用 champion 别名串起模型注册、加载、发布切换和回滚边界,说明 Alias URI 的写法以及不能忽略的版本验证与审计记录。360 收藏
-
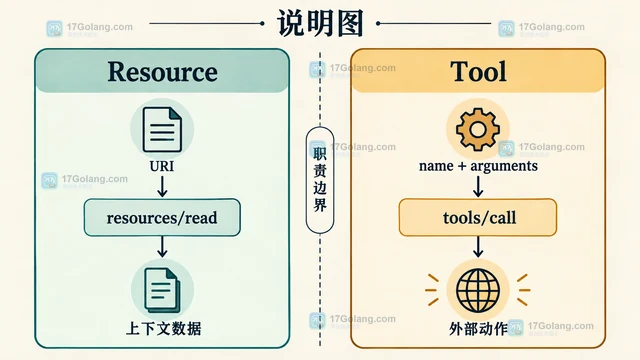 MCP 中 Resource 负责按 URI 提供可读取的上下文,Tool 负责按名称和参数执行能力。本文从发现消息、调用边界、权限审计和错误分层说明两者的实现方法。359 收藏
-
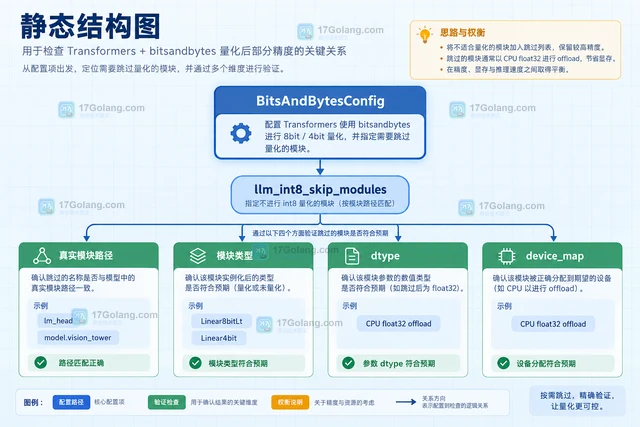 讲清 Transformers 使用 bitsandbytes 进行 8-bit/4-bit 量化时,如何用 llm_int8_skip_modules 保留指定模块,并区分跳过量化、dtype 与 CPU float32 offload。359 收藏
-
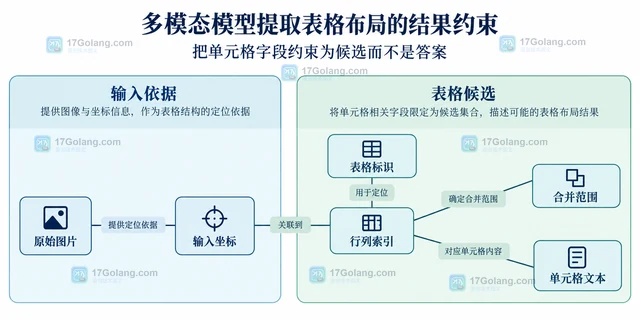 多模态模型提取表格布局需固定行列索引、合并范围与坐标含义,通过字段约束暴露结构冲突,并保留不确定内容与人工复核记录,避免把格式正确当成识别正确。359 收藏
-
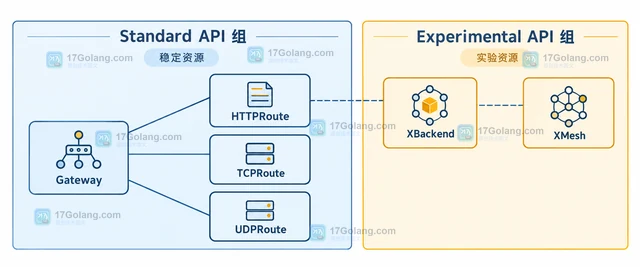 Gateway API v1.6 将实验资源迁移到 gateway.networking.x-k8s.io,并用 X 前缀标记实验类型。本文说明这一变化解决了什么治理问题,以及升级 CRD、清单和控制器时应该检查哪些边界。359 收藏
-
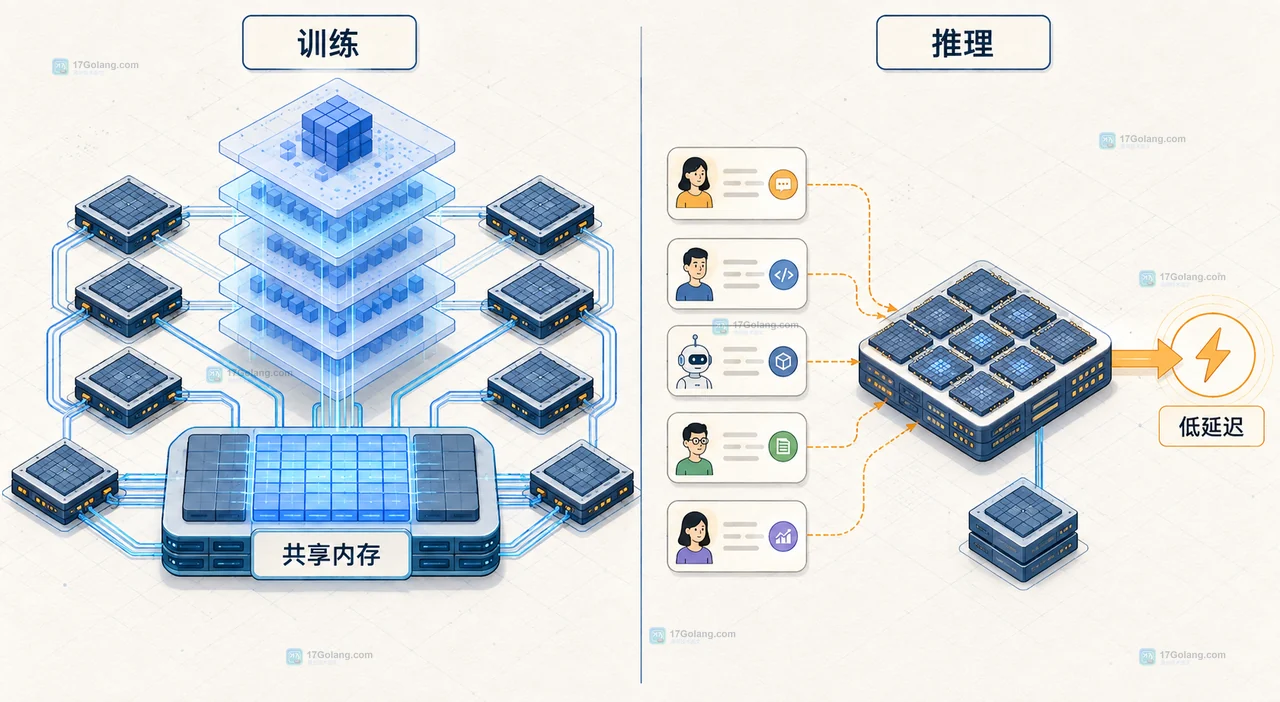 Google Cloud Next 2026 公布第八代 TPU:TPU 8t 面向大规模训练,TPU 8i 面向低延迟推理和多智能体协作。本文按工作负载、通信、延迟、成本与可用时间说明开发团队如何做初步评估。358 收藏
-
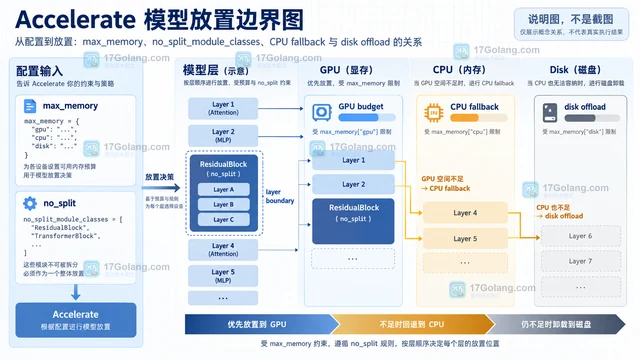 本文说明 Accelerate 如何用 device_map=auto 将大模型按显存分配到多块 GPU,并讲清 max_memory、不可拆分层、CPU 与磁盘回退以及多卡推理的性能边界。358 收藏
-
 OpenAI Responses API 的推理项不是普通文本,手动管理多轮上下文时要保留完整 reasoning item。本文拆解 reasoning.encrypted_content、include 参数和函数调用续接的验收边界,避免第二轮请求丢上下文。357 收藏
-
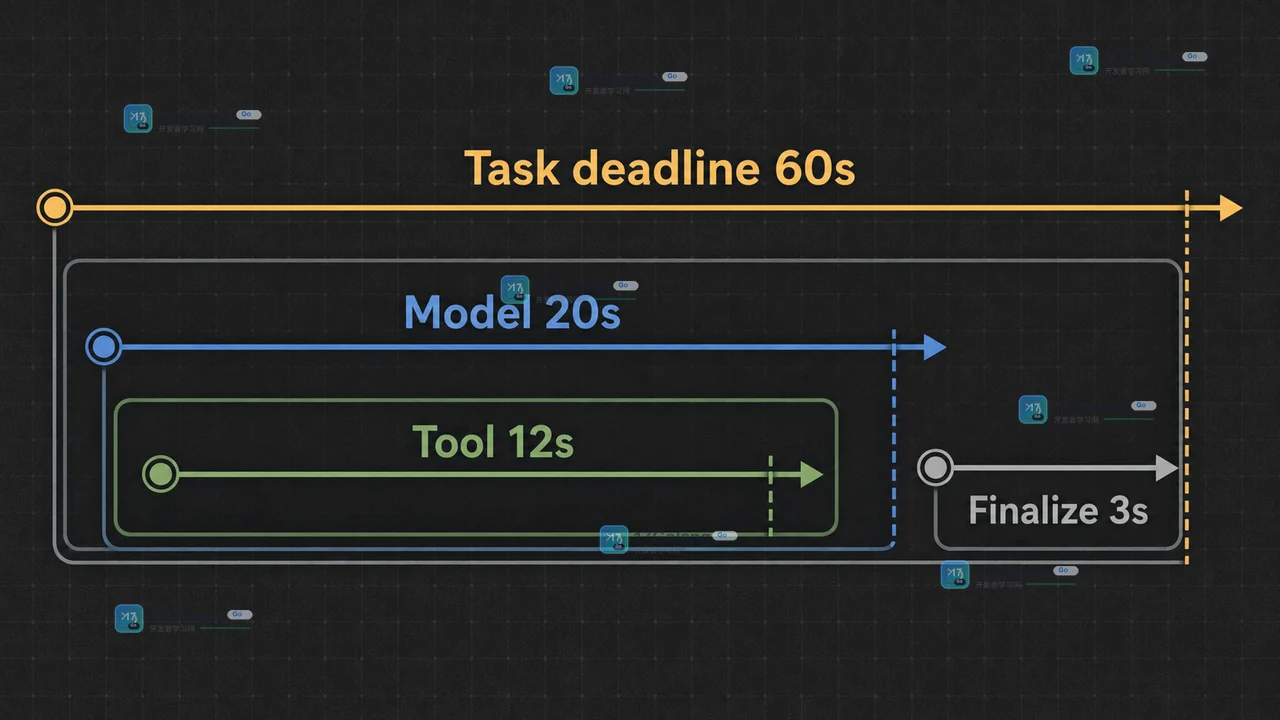 AI Agent 的超时不能只设一个总秒数。把模型等待、工具调用和整条任务预算分开,才能区分慢在哪里、及时停止无效工作,并在重试与回退时保留可核对的状态。357 收藏
-
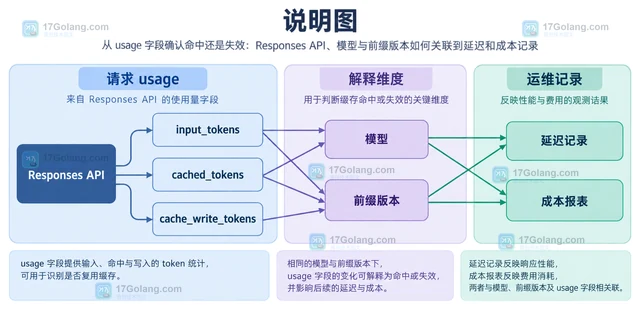 围绕 AI 提示词缓存的稳定前缀组织请求,说明固定指令、工具 schema 与动态问题的排列方法,并用 cached_tokens、cache_write_tokens 和版本化回滚定位缓存失效。357 收藏
-
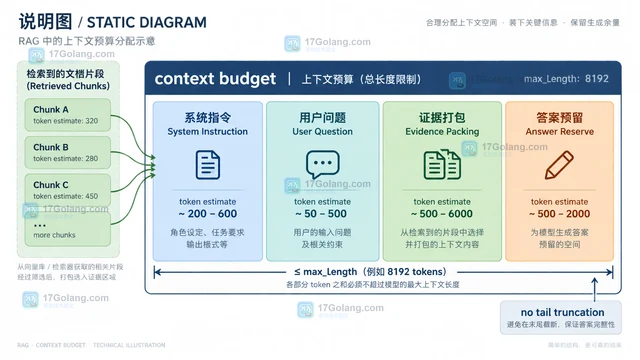 RAG 检索结果不要直接按 top_k 全量送入模型。本文用文档身份、规范化文本和语义多样性三层策略去重,再按系统指令、问题、证据与回答余量分配上下文预算,给出可迁移的 Python 实现与参数调优指标。357 收藏
-
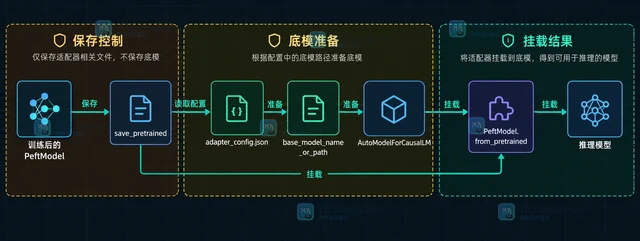 用 Hugging Face PEFT 训练 LoRA 后,怎样只保存 adapter_model.safetensors 与 adapter_config.json,而不把底模权重打进交付包?本文按资产、风险路径、保存加载代码和文件审计说明适配器交付边界。357 收藏
-
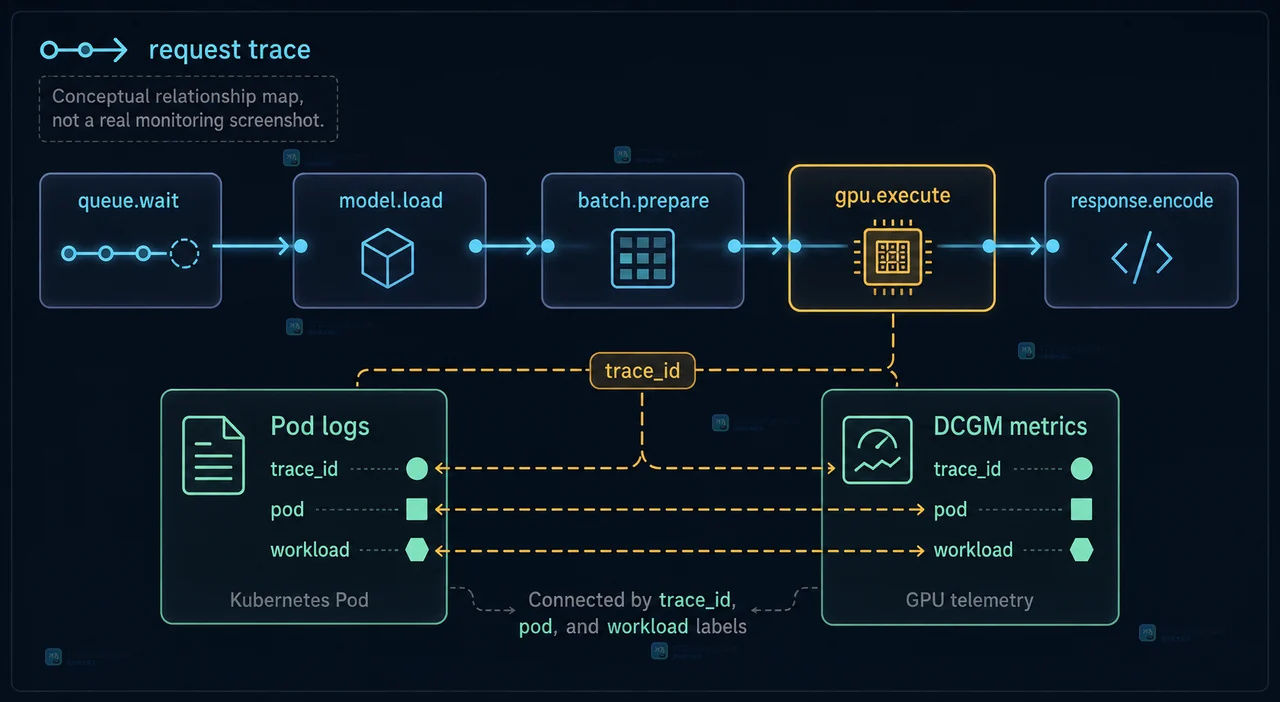 GPU 集群扩展后,单看显卡利用率很难解释任务变慢。本文按设备、工作负载和请求链路三层设计可观测性,并给出指标、Trace、告警与回滚检查清单。356 收藏
-
 vLLM Prefix Caching 适合重复长前缀、长文档和多轮会话,但收益集中在 prefill。本文从前缀稳定性、开启配置、测量方法、缓存容量和多租户隔离几个方面判断是否值得使用。356 收藏