
Go语言技术文章
-
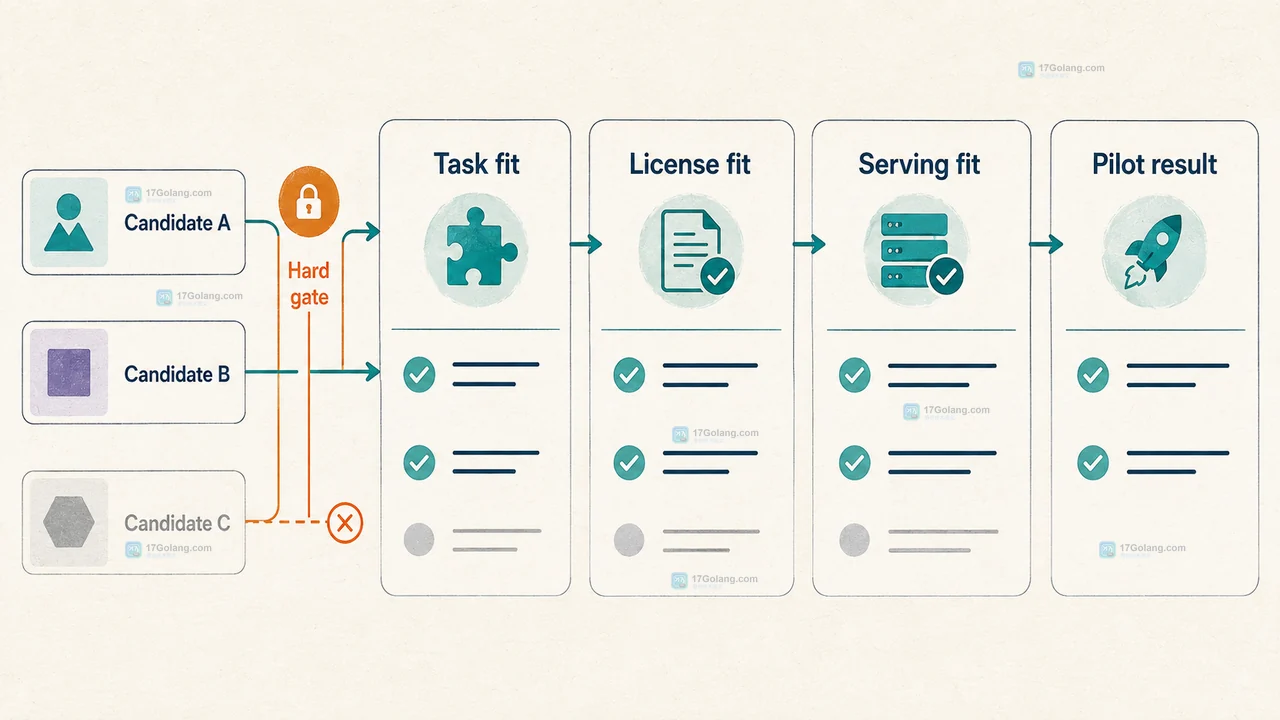 开源 AI 模型榜单适合做候选池,不适合直接决定生产模型。本文用一个轻量评分卡拆开任务集、人工偏好、许可证和真实推理成本,给出可复核的选型步骤。116 收藏
-
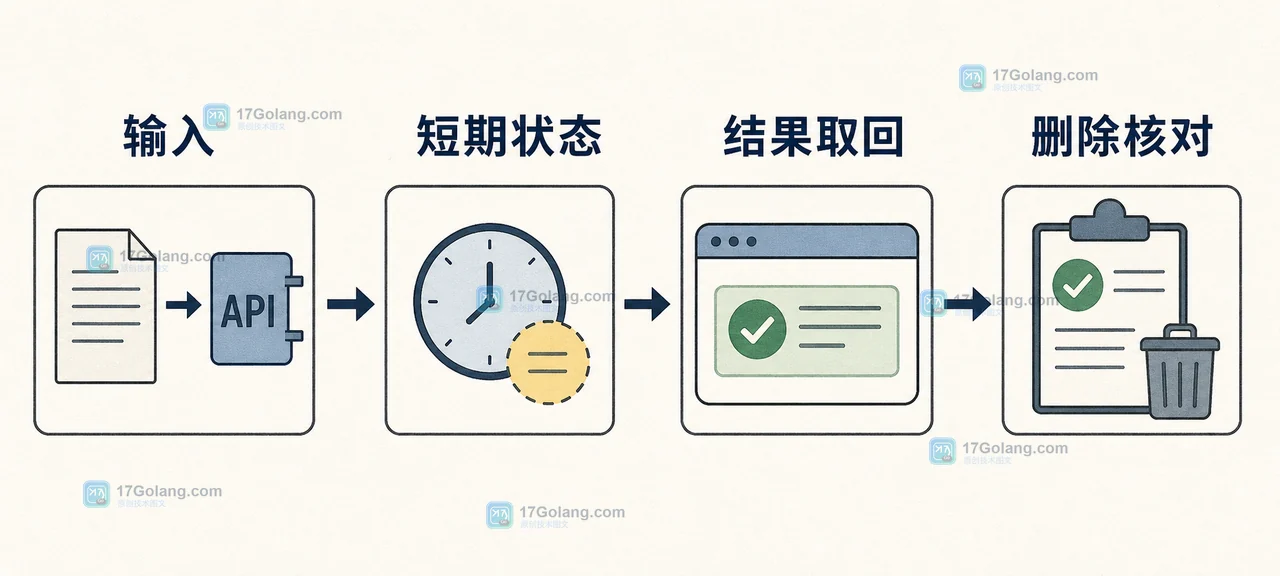 AI API 上线评审不能只看请求是否成功,还要画清输入、平台短期状态、回调结果和删除动作。本文用一个后台响应场景拆解客户数据与短期保留的边界,给出可落地的合规核对清单。115 收藏
-
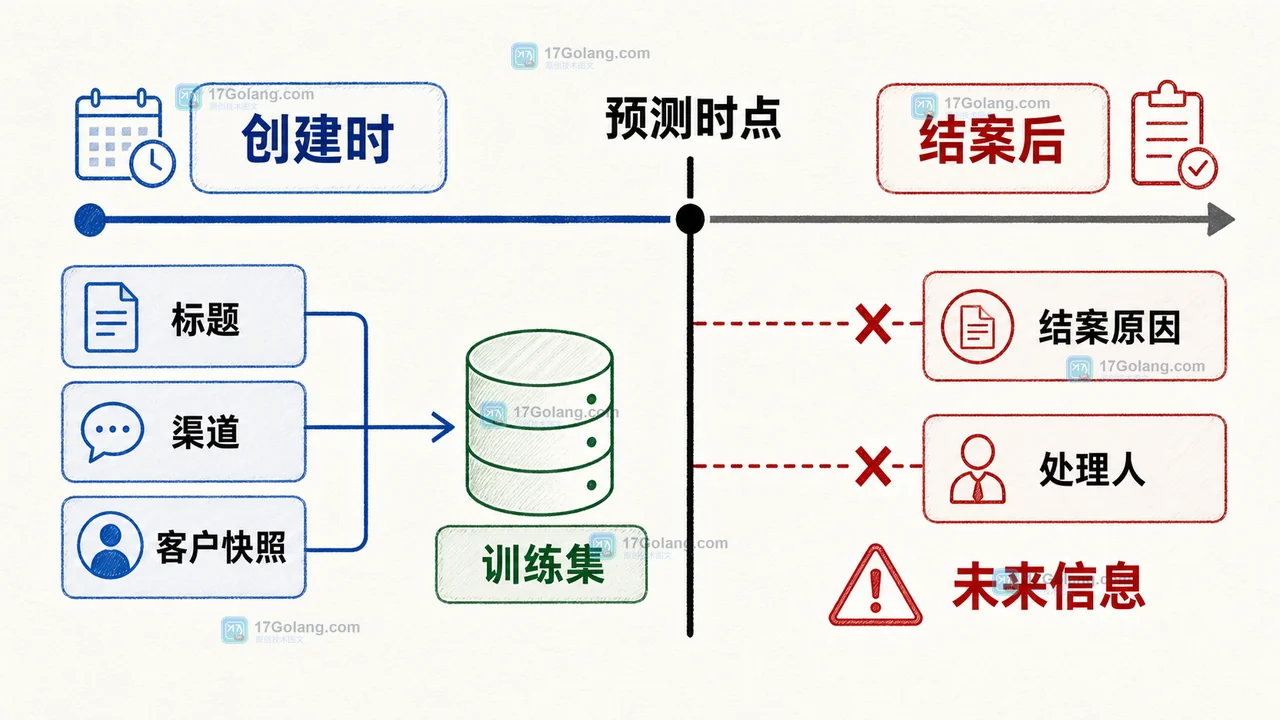 评测分数异常好,未必代表模型真的可靠。训练集、验证集和测试集之间的重复样本、未来字段和错误的预处理顺序,都会造成数据泄漏。本文以带时间的客服工单分类为例,给出切分、去重、特征时间点和最终验收的检查方法。115 收藏
-
 LLM评测不要把事实错误和表达偏差混成一个总分。本文给出分层标签、证据字段、分项统计和复核一致性的可复用设计。115 收藏
-
 语音转写与说话人分离遇到重叠发言时,不要按片段顺序抢词或直接删掉重叠区;应保留普通 diarization,再用词级时间交集决定归属,无法判断的结果进入 ambiguous 复核。115 收藏
-
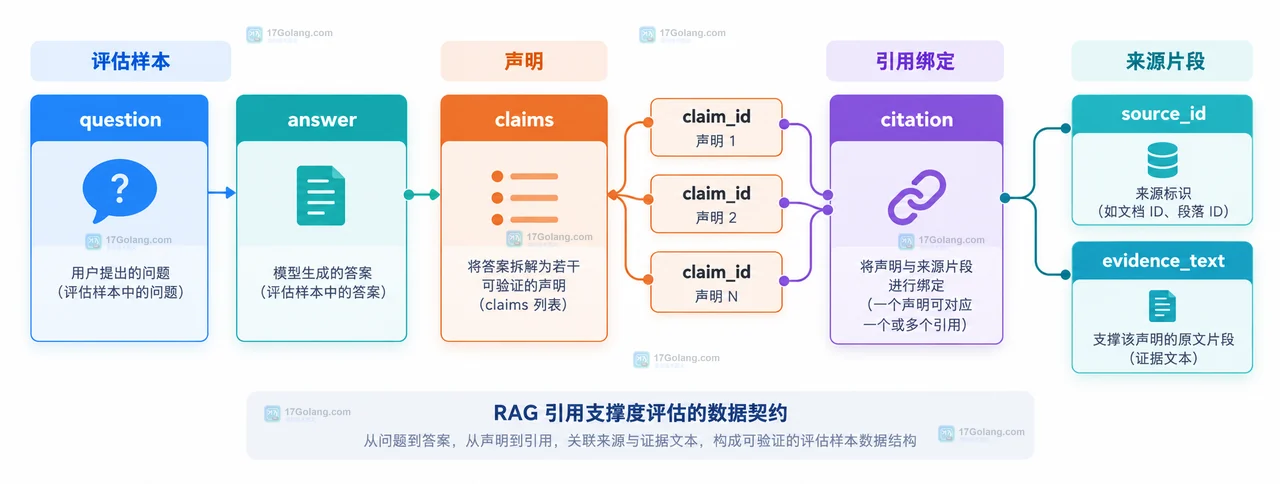 用 Hugging Face 风格的评估数据组织方式,拆解 RAG 引用支撑度的字段契约、覆盖检查、语义判定和分层排障方法。115 收藏
-
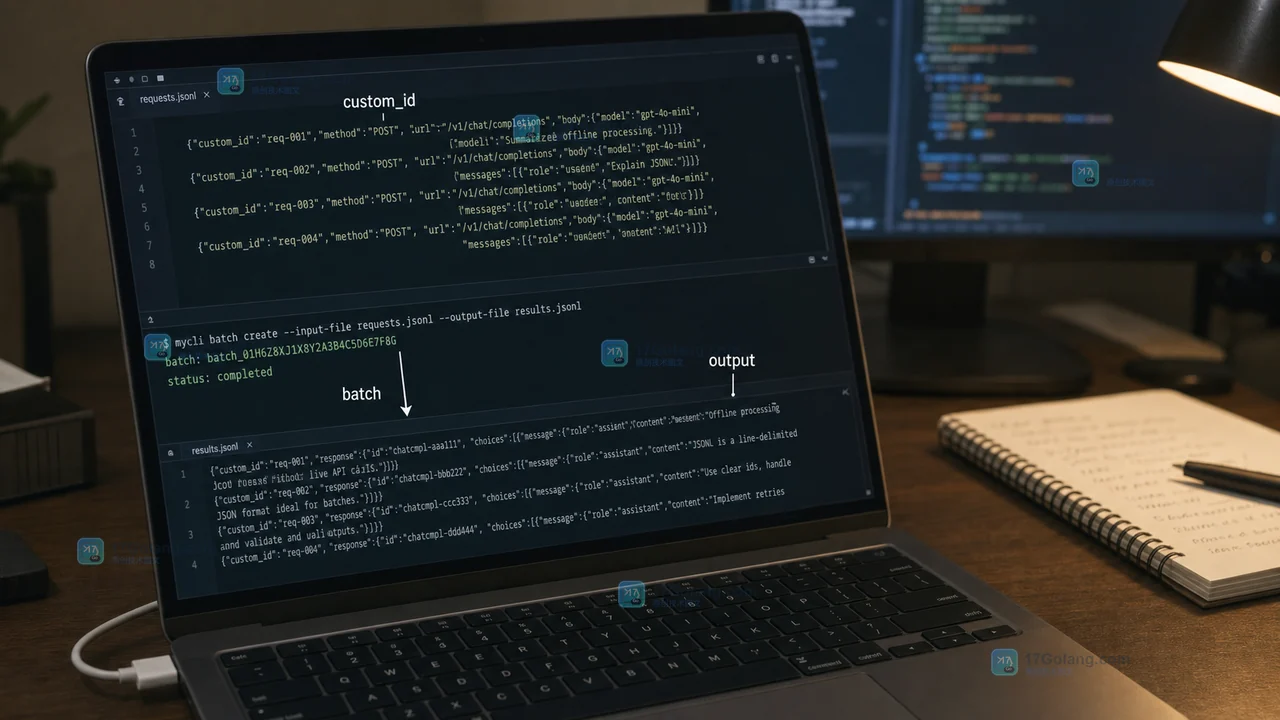 夜间给历史工单打标签、批量生成摘要这类不需要即时返回的工作,不该和在线请求抢同一条队列。本文用一份最小 JSONL 任务说明如何提交异步批次、查看状态、按 custom_id 对齐结果与业务记录,并处理输出文件和错误文件,避免把“批量完成”误当成“每一条都成功”。113 收藏
-
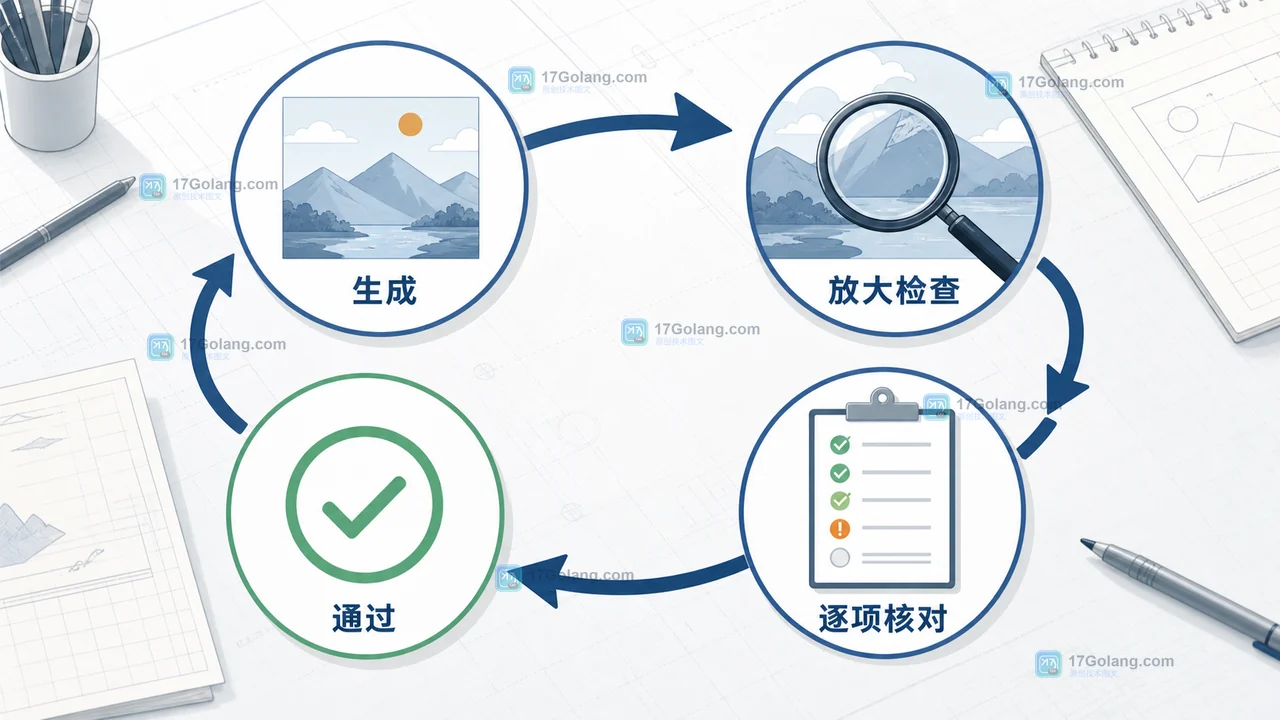 AI 图片里出现多余文字,通常不是把否定词堆得更多就能解决。本文从画面目的、文字约束、分步修改和交付验收四个环节,给出一套可复用的排查方法。113 收藏
-
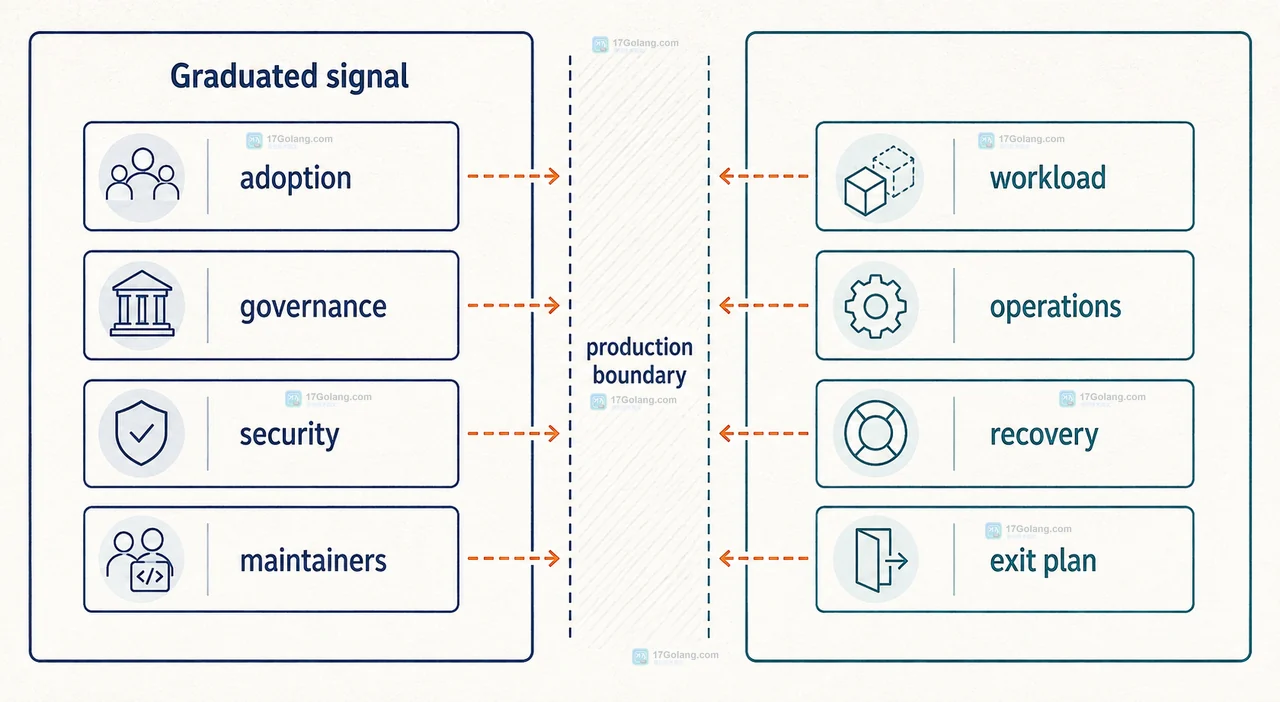 CNCF 项目毕业说明它在稳定性、社区治理、安全实践和生产采用证据方面达到更高成熟度,但不等于适配所有企业场景。本文从毕业信号、采用者证据、容量安全验证、灰度和退出成本五个方面整理生产采用判断清单。113 收藏
-
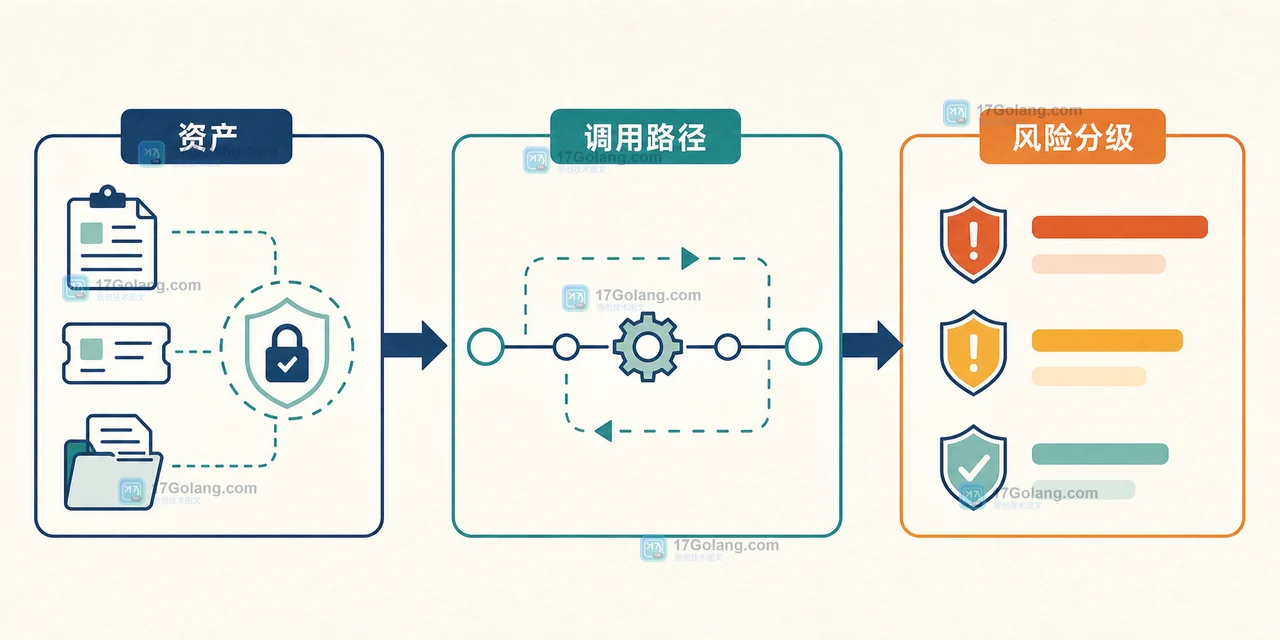 MCP 工具调用遇到超时,不能简单地把所有失败都重试。本文从资产保护、调用路径和错误分级入手,设计一套包含超时、重试、幂等、审计与人工接管的收口方案。111 收藏
-
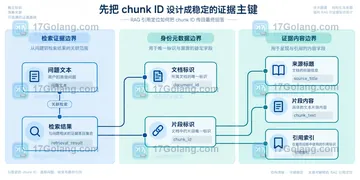 RAG 中不要让模型猜来源。给每个检索片段保留稳定 chunk_id,让模型返回可校验的 citations,再由应用层回填标题、页码和原文位置。111 收藏
-
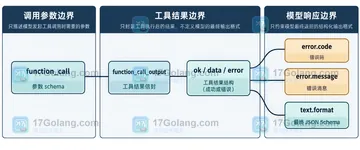 Responses API 的结构化输出不会自动校验工具返回值。本文用统一错误信封、function_call_output 和严格 JSON Schema 保留错误码、消息与可重试标记,并说明为什么还要保存原始工具结果。111 收藏
-
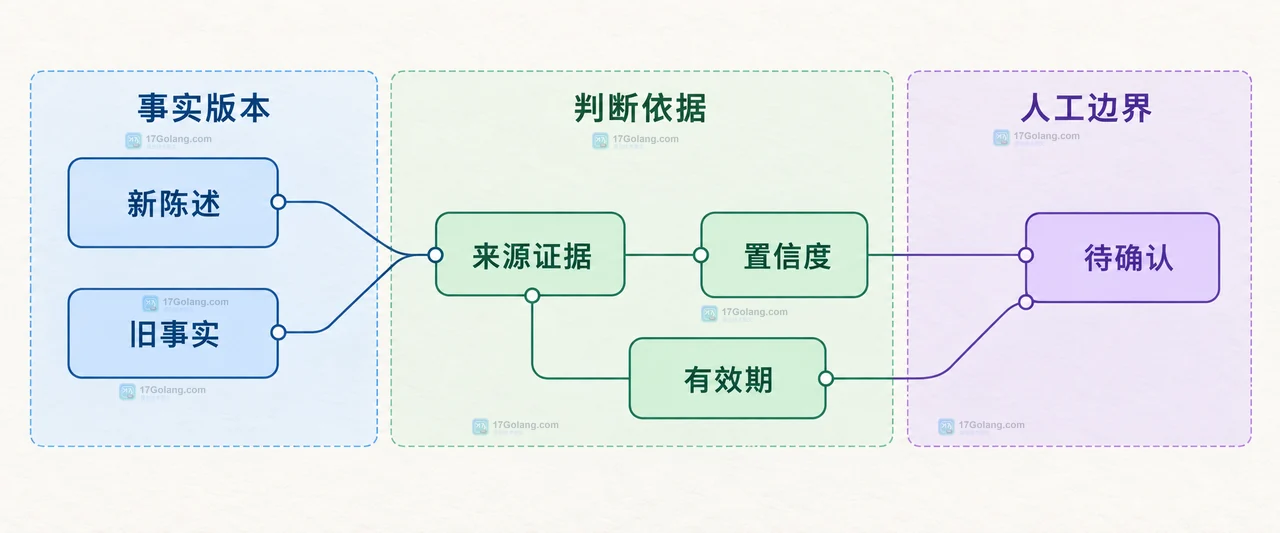 AI Agent 记忆不应把所有对话永久保存。本文用会话、任务和用户事实三层模型,说明字段设计、写入门槛、分层检索与冲突处理方法。110 收藏
-
 GPU 集群监控不能只增加一条利用率曲线。本文从设备身份、计算与显存、温度功耗与错误、任务归属和互联拓扑五个角度,给出从 CPU 指标扩展到 GPU 观测的最小维度清单,并说明如何控制 Prometheus 标签基数。110 收藏
-
 npm 从 2026 年 7 月起在发布时自动扫描新包,包可能正常上线、进入人工复核或被拦截;带有双用途安全能力的包还要声明 contentPolicy、附带 DISCLOSURE,并使用强制双因素认证的发布方式。文章把这项变化落到 CI 验收、延迟重试和申诉准备上。108 收藏