
Go语言技术文章
-
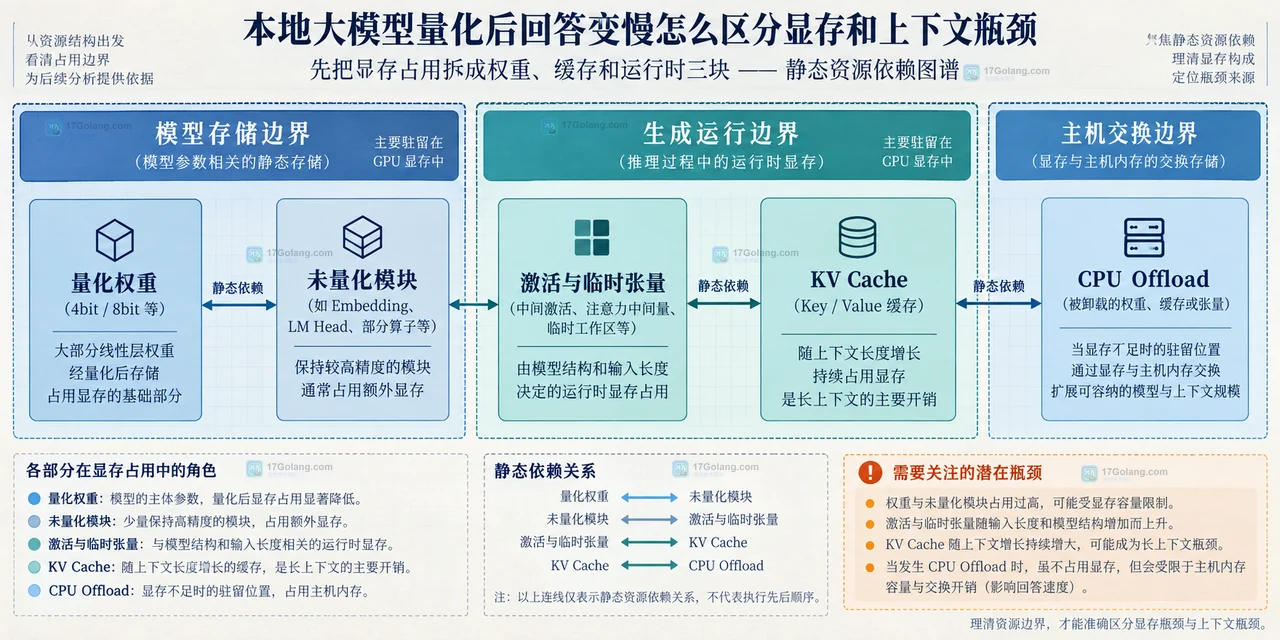 本地大模型量化后变慢,不一定是量化本身造成的。本文用显存峰值、首 token 延迟、生成 token/s 和上下文长度的对照实验,区分权重显存压力与 KV Cache 上下文瓶颈,并比较 4/8 bit、缓存卸载和量化缓存的选择。433 收藏
-
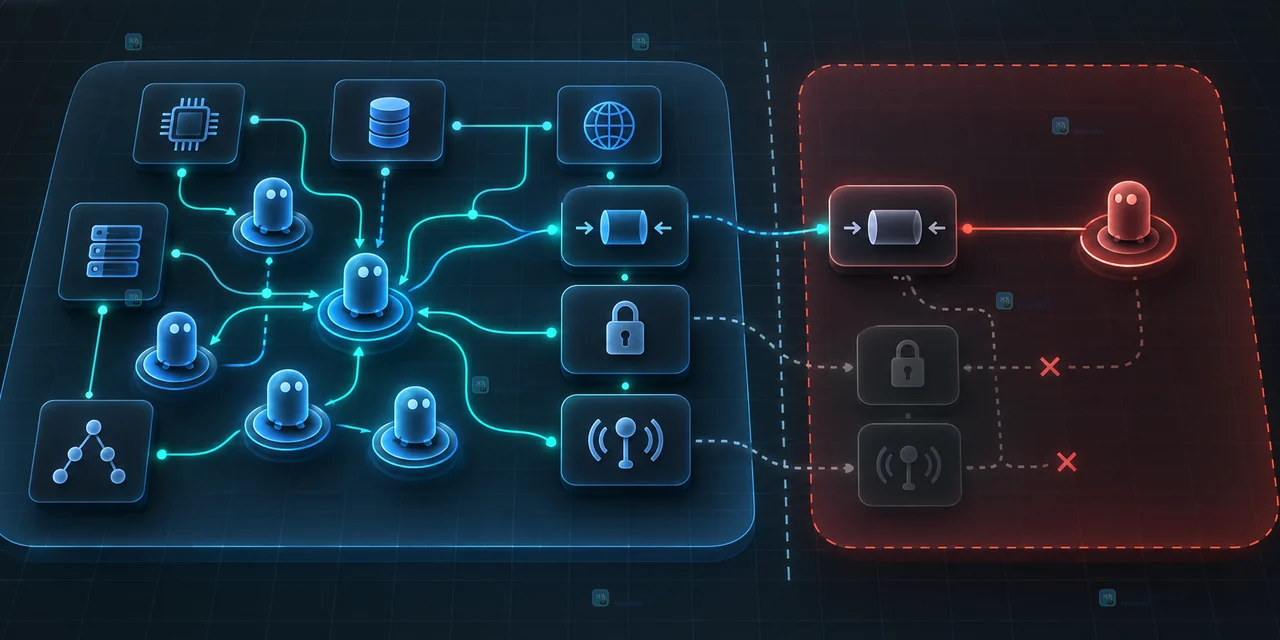 Go 1.27 将 goroutineleak profile 正式带入 runtime/pprof,并提供 HTTP 端点。本文解释它能识别哪些无法唤醒的阻塞协程、适合哪些服务排查,以及为什么结果仍需回到所有权和取消路径确认。105 收藏
-
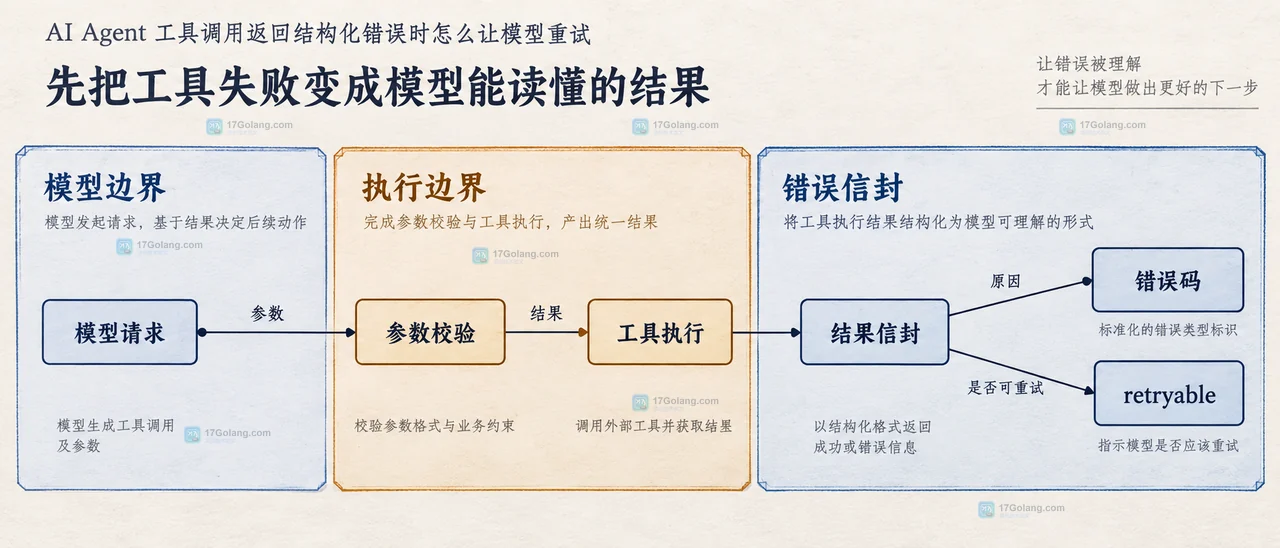 AI Agent 工具调用失败时,不要无条件重放模型请求。本文用统一错误信封、错误码分层、原始 call_id 回传和有限重试预算,让模型只重试可修复问题,并避免副作用重复执行。307 收藏
-
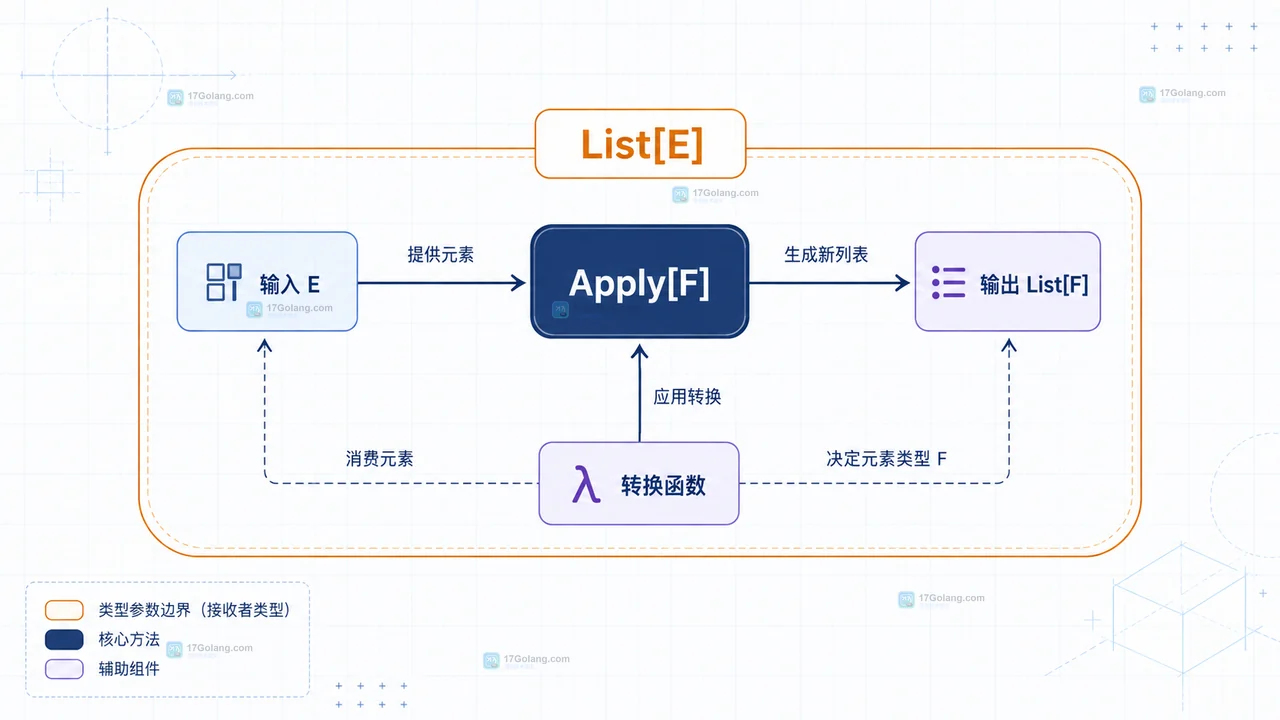 Go 1.27 支持具体类型的方法声明自己的类型参数,但接口方法仍不能声明泛型参数。本文用 List 的转换 API 拆解哪些旧函数值得改成 generic method,以及接口、反射和升级检查的边界。237 收藏
-
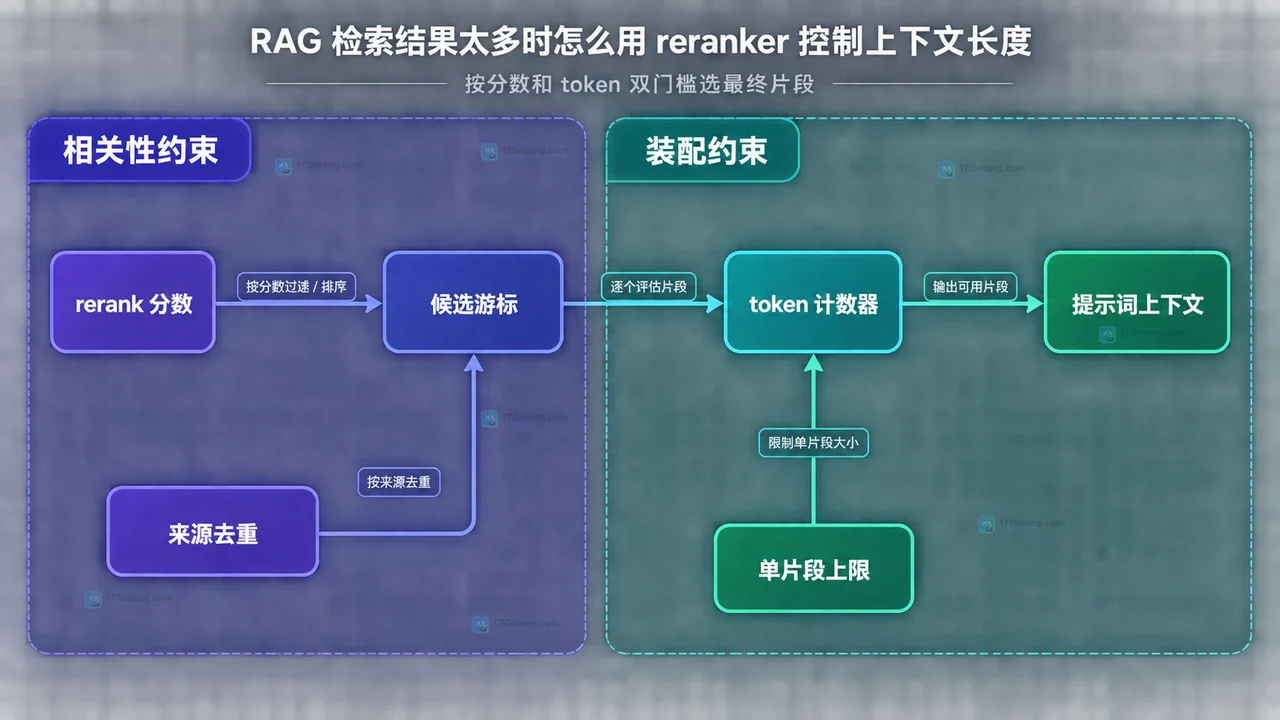 RAG 不应该把向量召回的所有片段直接塞进上下文。本文用 reranker 重排候选片段,再用 token 预算、单片段上限和来源去重装配最终上下文,给出可观测的参数与 Python 示例。281 收藏
-
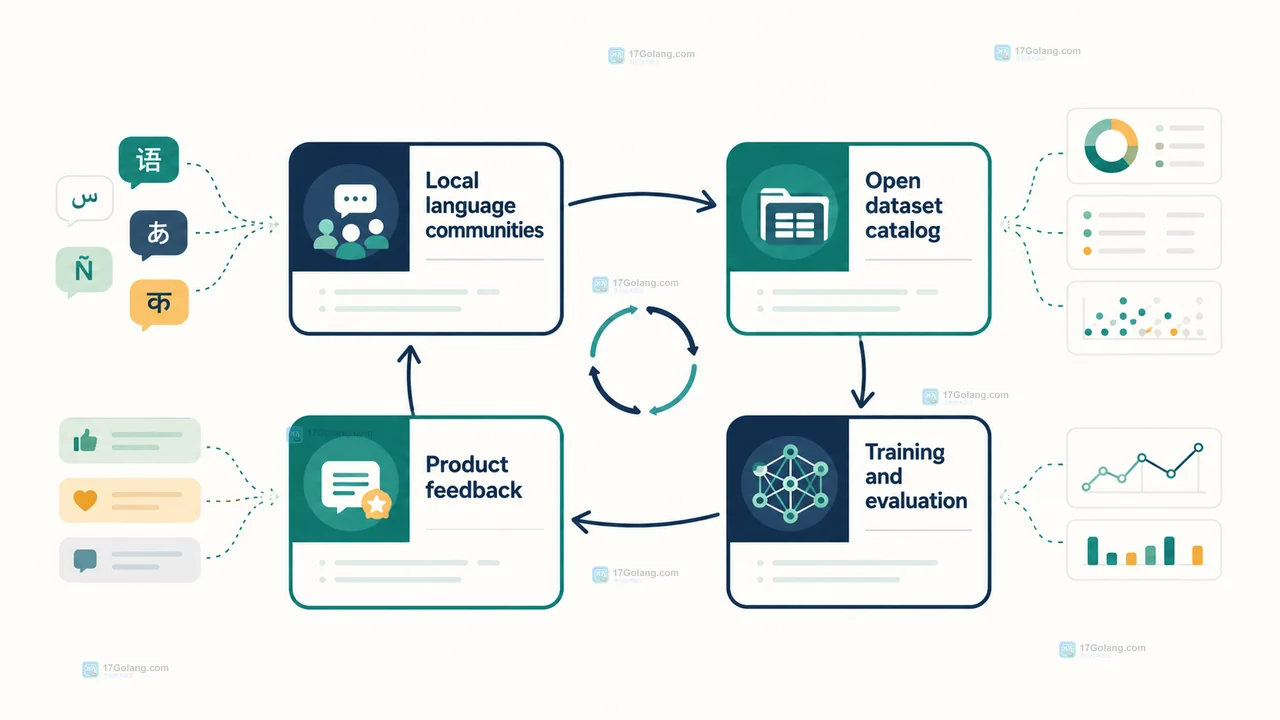 Google 新加坡 2026 公告宣布向 AI Singapore 的 Project Aquarium 追加 100 万美元,改善东南亚数据集质量并推动开放源代码。本文区分公告事实与开发推断,说明模型、应用和企业数据团队如何核对语言覆盖、许可证、质量与评测条件。257 收藏
-
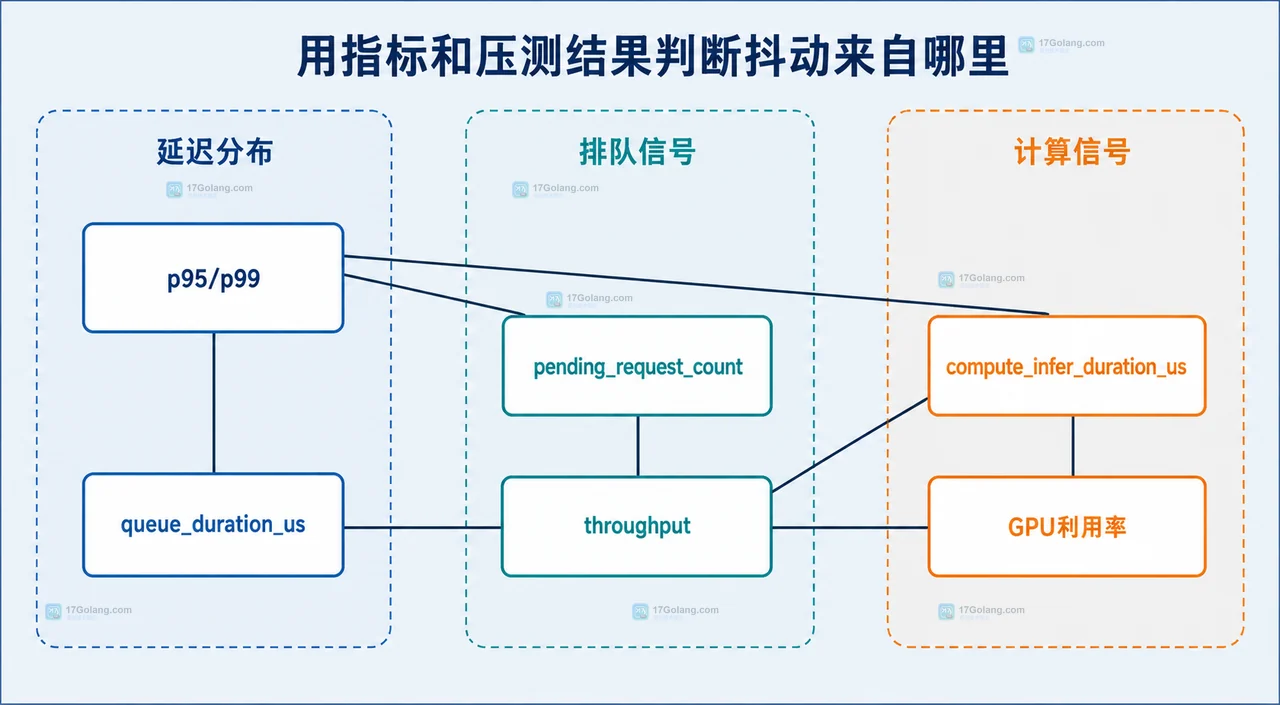 AI 推理服务的 p95、p99 延迟突然抖动时,不要只看 GPU 利用率。本文用请求、排队、输入处理、模型计算和输出处理的分段指标,结合并发与吞吐变化,判断瓶颈究竟在调度排队还是模型计算。462 收藏
-
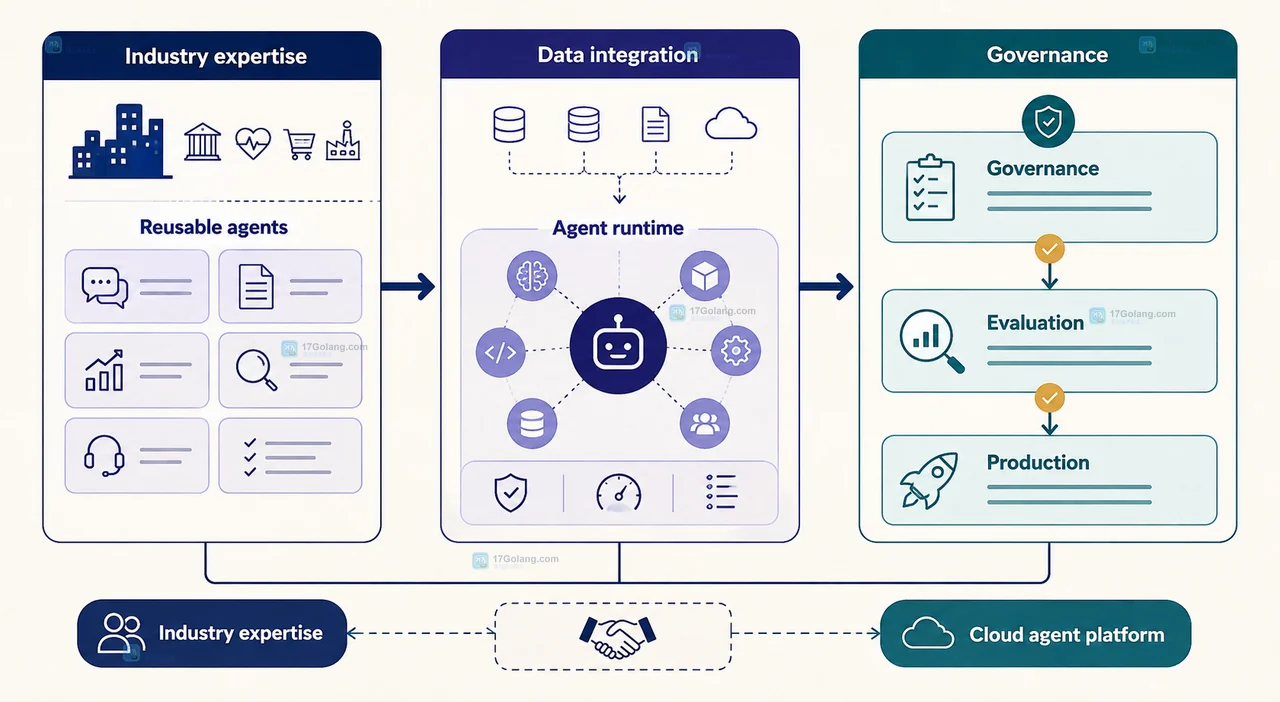 IBM 与 Google Cloud 2026 年 6 月宣布新的 Google Cloud Practice。合作重点不在发布新基础模型,而在把行业经验、AI 交付资产、数据连接、Agent Runtime、治理与观测能力串成企业 AI 的生产化流程。289 收藏
-
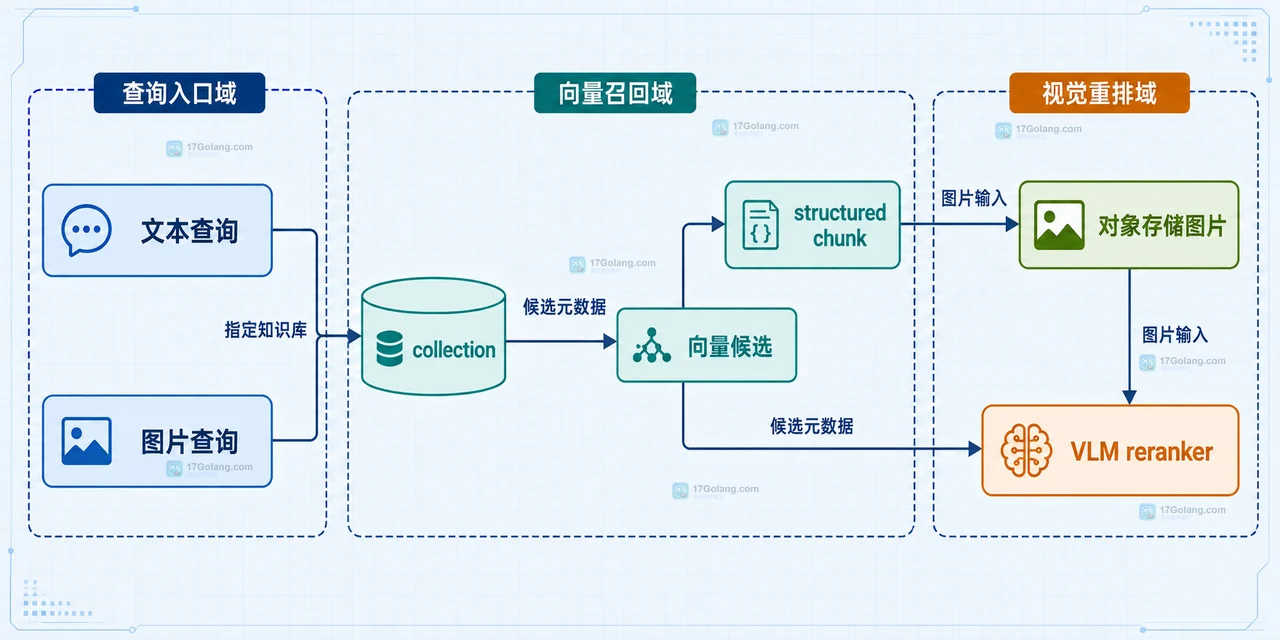 PDF 图表检索失败时,先区分抽取、模态 embedding、向量集合和视觉重排四层。本文用固定回归样本和配置检查,定位图表到底在哪一层丢失。132 收藏
-
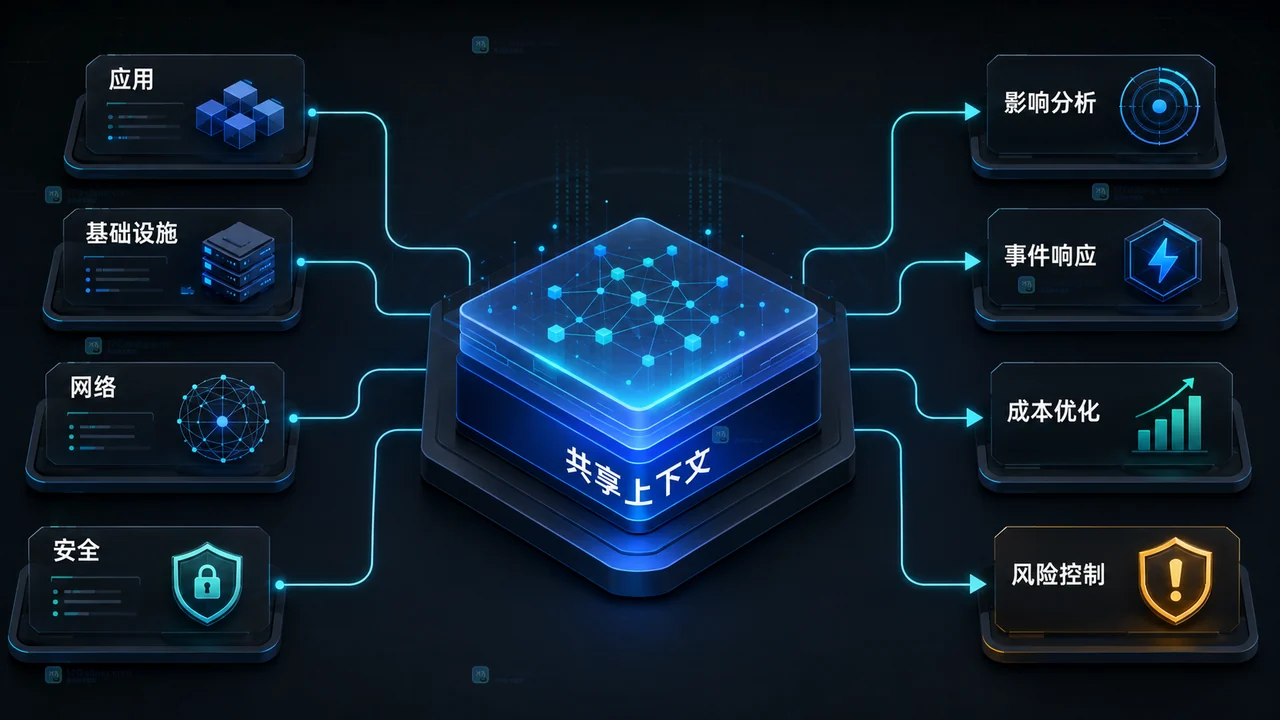 IBM 在 Think 2026 公布的 Concert 平台,重点不是替换现有监控工具,而是把应用、基础设施、网络和安全信号放到共享运维层中,辅助团队从发现问题走到审批后的行动。本文拆解其模块、AI 工作流和渐进式试点边界。486 收藏
-
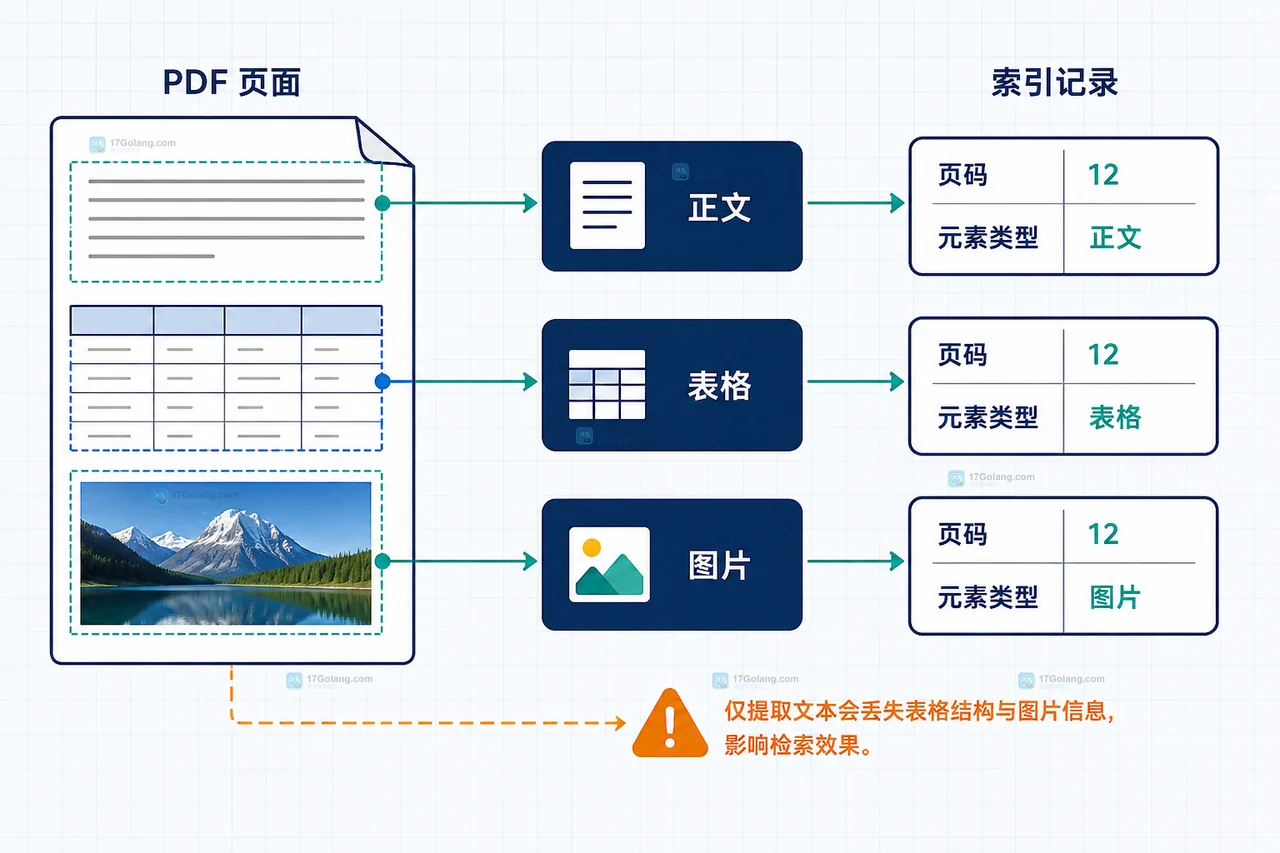 PDF 表格在 RAG 中不能只靠正文抽取。本文用摄取、元素表示和检索核对三层方法,说明如何保留表格结构、图片与页码元数据。244 收藏
-
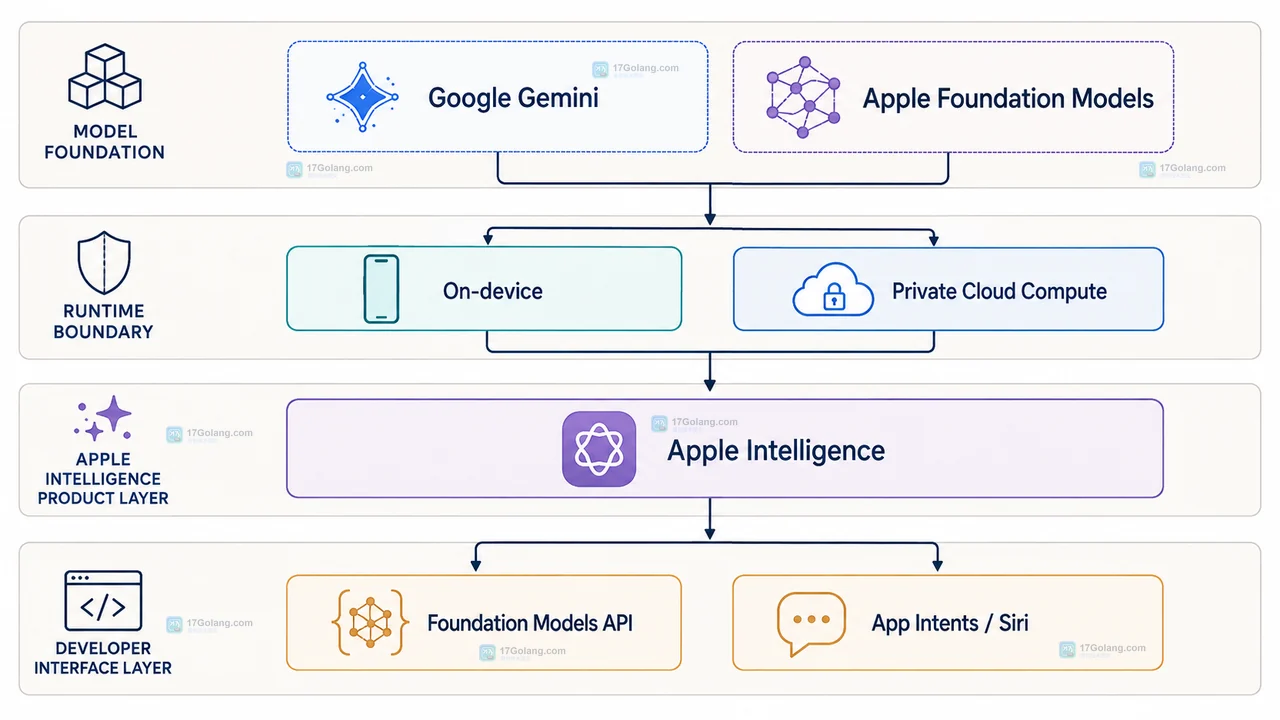 Google 与 Apple 的合作首先改变的是 Apple Foundation Models 的模型底座和云端承载方式,并不等于现有开发者 API 已经改名。本文按接口层、运行边界和 Siri 集成面梳理当前影响。408 收藏
-
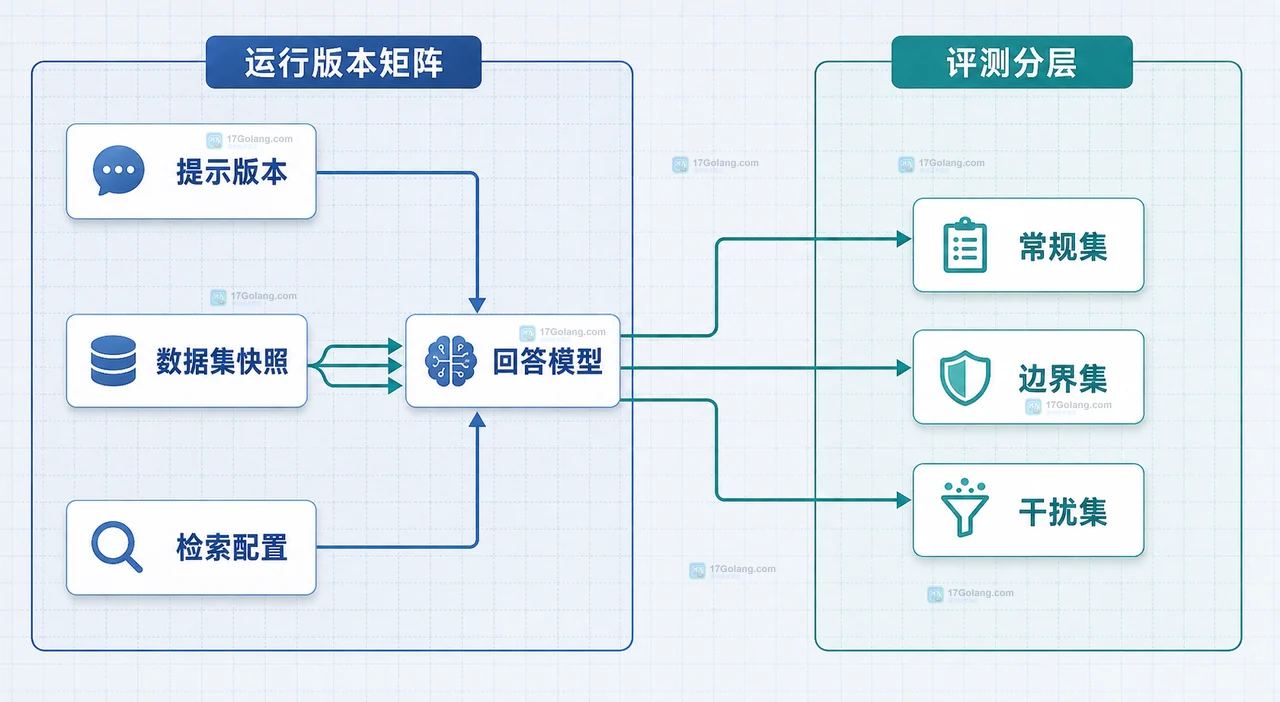 AI 问答评测不稳定,通常不是模型分数本身的问题,而是提示、检索配置和数据集同时在变化。本文给出一套可重复的 RAG 评测拆分、数据字段和回归清单。215 收藏
-
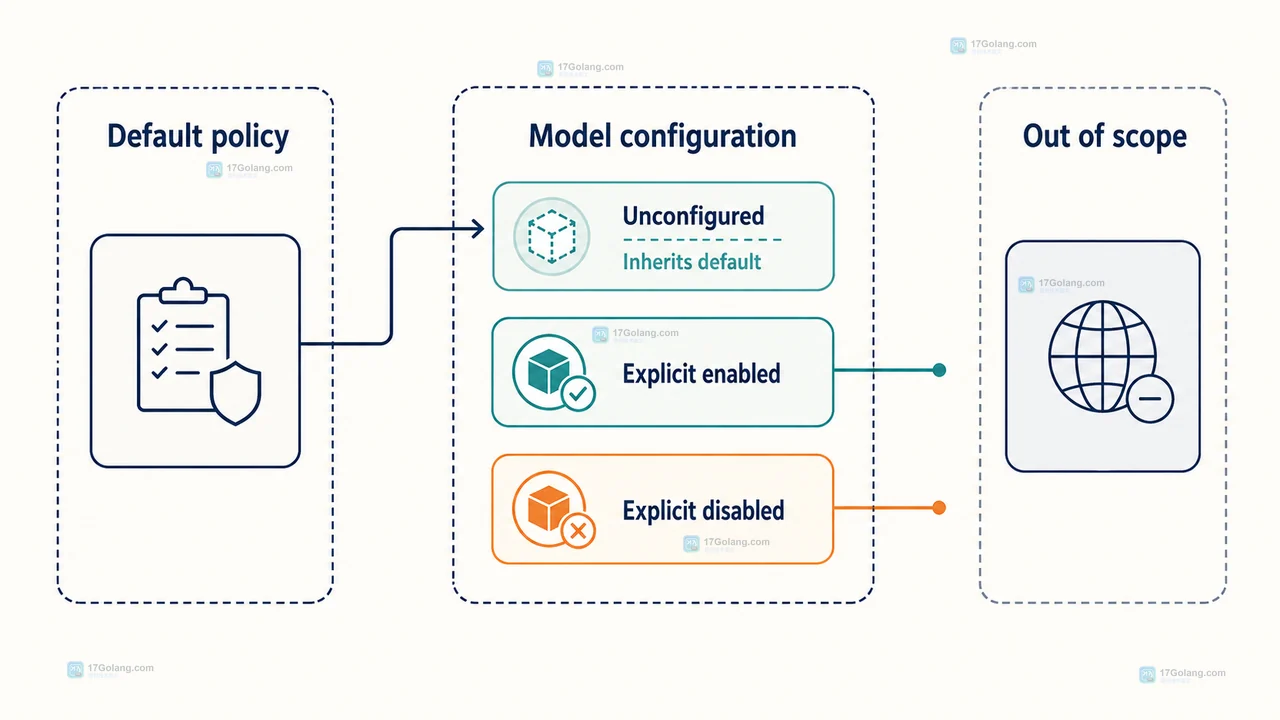 GitHub Copilot Business 和 Enterprise 的 GA 模型默认启用策略已经生效。本文拆解未配置模型、显式设置、企业与组织继承关系,以及管理员在开发效率和治理要求之间如何做一张可复查的模型准入清单。277 收藏
-
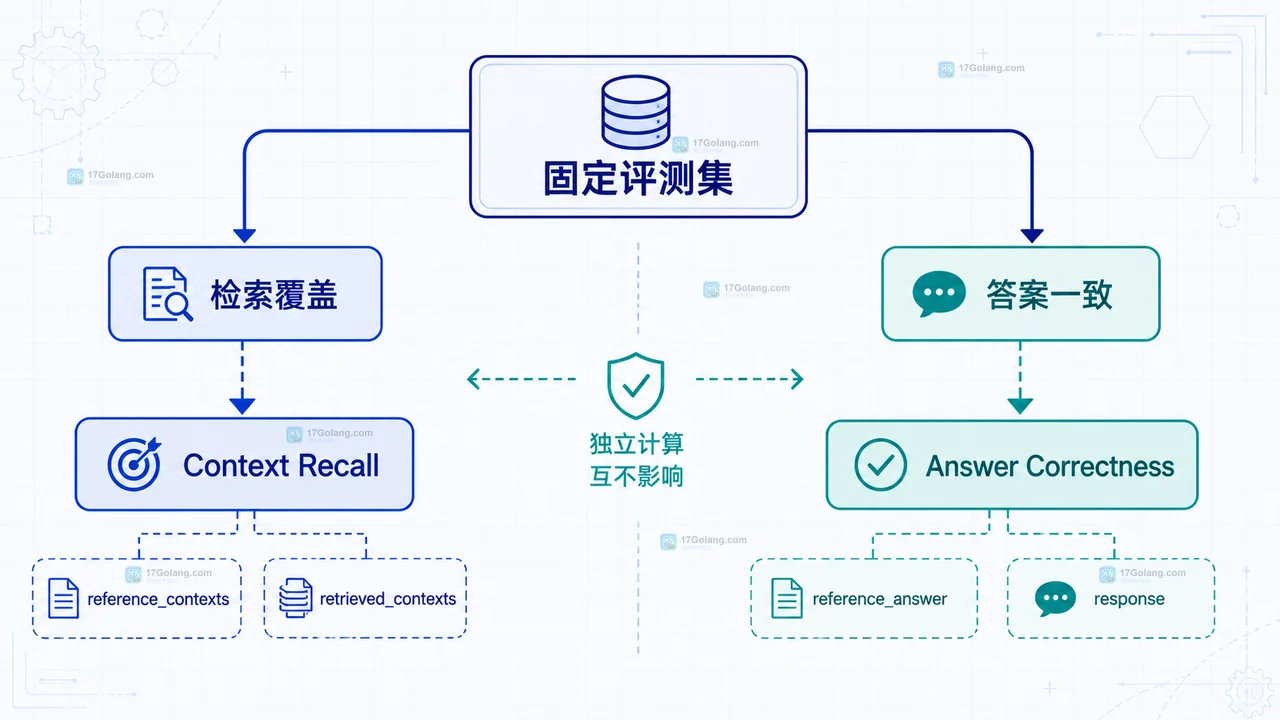 RAG 评测不要只看一个总分。本文用固定 JSONL 样本,把检索上下文覆盖率与最终答案正确率拆开统计,并用指标组合定位检索、生成和数据集问题。293 收藏