
Go语言技术文章
-
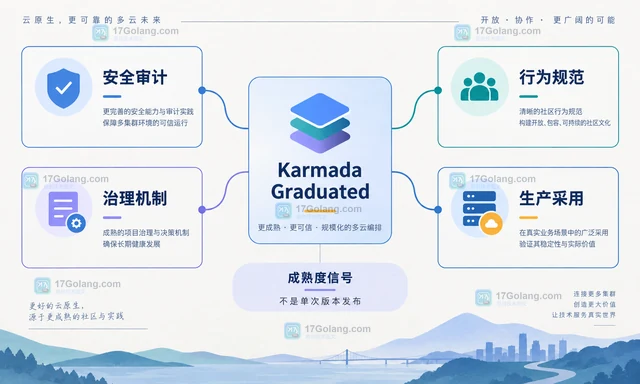 CNCF 宣布 Karmada 毕业,意味着这个多集群、多云 Kubernetes 编排项目在安全、治理和生产成熟度上完成了更高等级的审查。本文把新闻拆成工程师能使用的选型信号,说明它适合哪些场景,以及毕业不等于什么。466 收藏
-
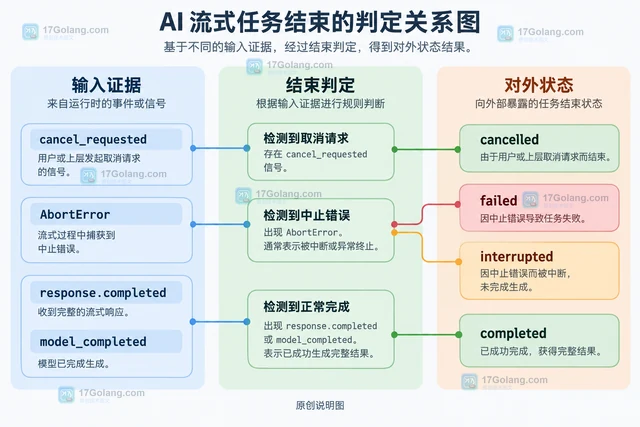 AI 应用的流式请求不能用“连接结束”判断模型完成。本文从一次取消被记成成功的故障入手,拆分 AbortSignal、SSE 完成事件和异常断开,给出可落地的状态字段、前端判定代码与日志边界。354 收藏
-
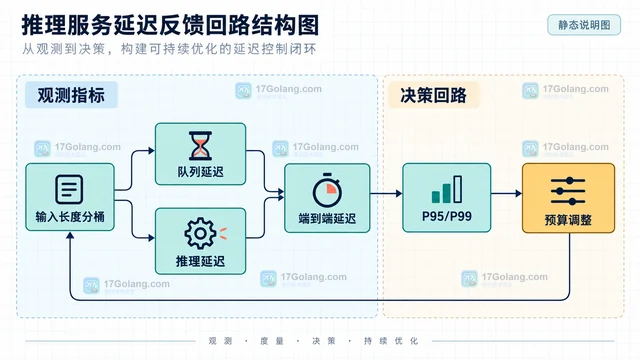 把推理请求的输入 token、输出上限、排队等待和生成吞吐拆开计算,再配合 TGI 的 token 与并发参数设置可解释的超时预算。371 收藏
-
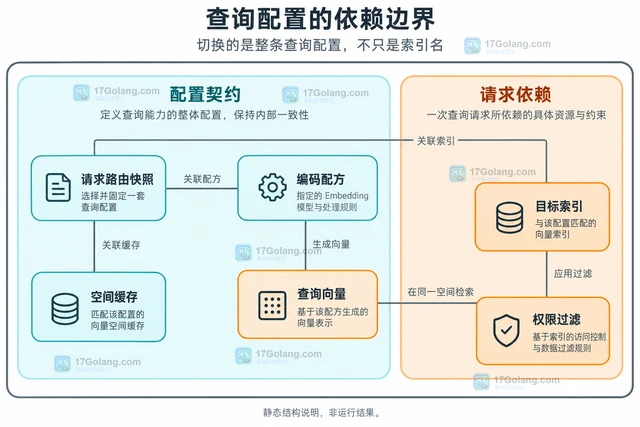 Embedding 模型更换后应隔离新旧向量空间,从原始文本重算文档向量,并成套切换查询配置。本文说明版本化双写、删除同步、缓存隔离和失败回退条件。386 收藏
-
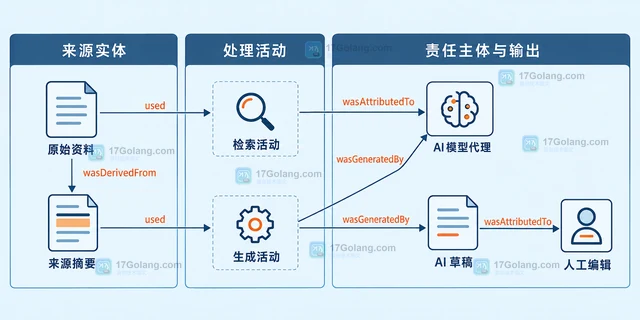 AI 生成内容要可追溯,关键不是只保存最终答案,而是把来源实体、检索与生成活动、模型和人工角色拆开记录,再用稳定 ID 串成可查询的引用链。448 收藏
-
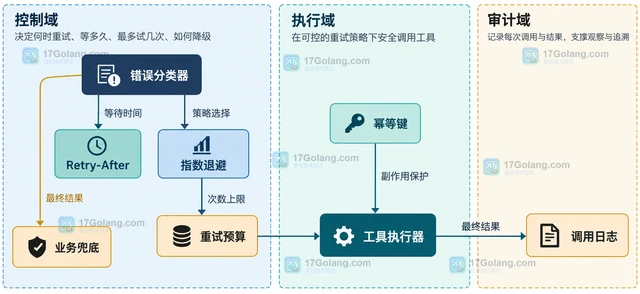 AI 工具调用不应把所有失败都重试。本文从参数校验、限流、超时、服务过载和业务拒绝五类场景出发,设计错误分类、指数退避、重试预算、幂等键与最终兜底。203 收藏
-
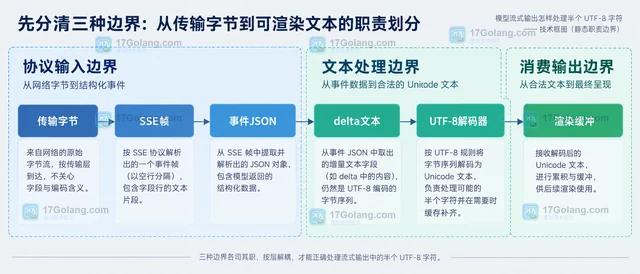 模型流的网络字节、SSE 帧和 UTF-8 字符不是同一条边界。本文用 Go 的 unicode/utf8 保存不完整尾部,说明如何在增量渲染中避免半个字符变成乱码,并划清 SDK 文本事件与原始字节适配层的职责。140 收藏
-
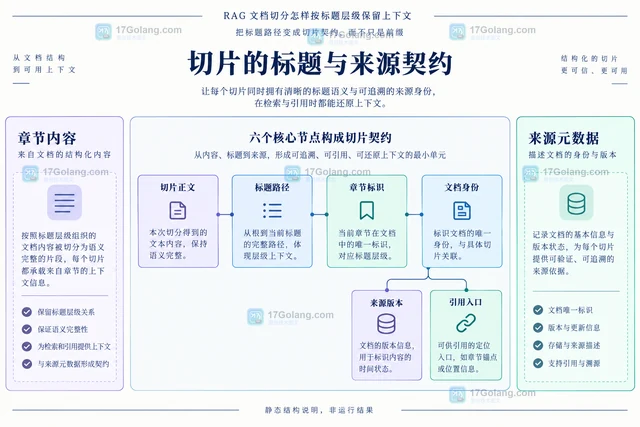 RAG 按标题层级切分应先分章节,再按长度细分并继承标题路径和来源元数据。本文用原创 Markdown 示例说明检索文本、生成上下文、引用定位和旧索引迁移的边界,避免切片只剩孤立正文。328 收藏
-
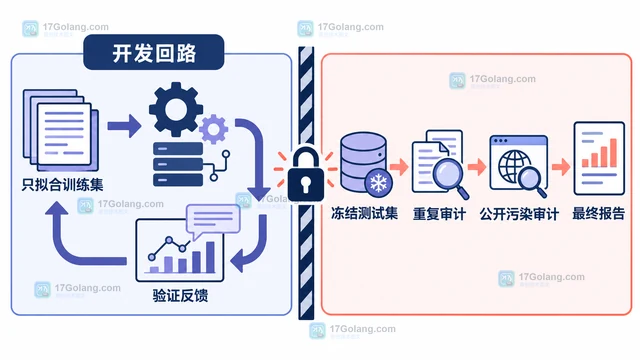 AI 评测分数异常偏高时,问题常不在指标本身,而在同源样本跨 split、预处理读到了测试集或公开基准已经进入训练语料。本文用来源分组、训练集拟合、冻结测试集和污染审计组成一套可落地的数据血缘方案。146 收藏
-
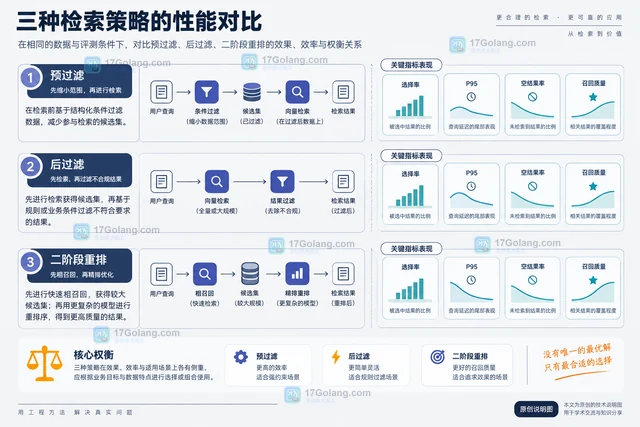 向量检索不要先取全局 top_k 再丢弃不合格结果。本文以 Redis Search 为例,把 tenant、状态和时间等元数据作为预过滤条件放到 KNN 前,并用选择率、P95 延迟和召回质量确定参数边界。365 收藏
-
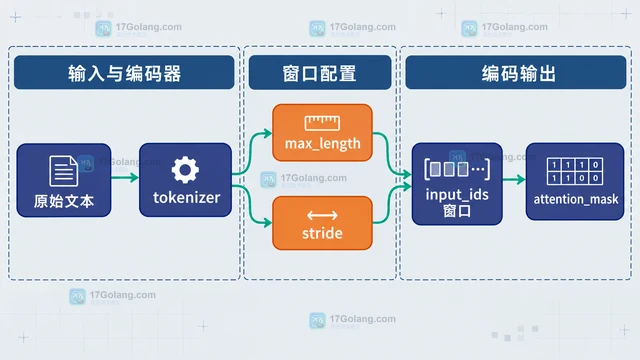 长文本超过模型输入上限时,用 Transformers tokenizer 的 stride 和 return_overflowing_tokens 生成带重叠的窗口,再通过 overflow_to_sample_mapping 与 offset_mapping 对齐原文。197 收藏
-
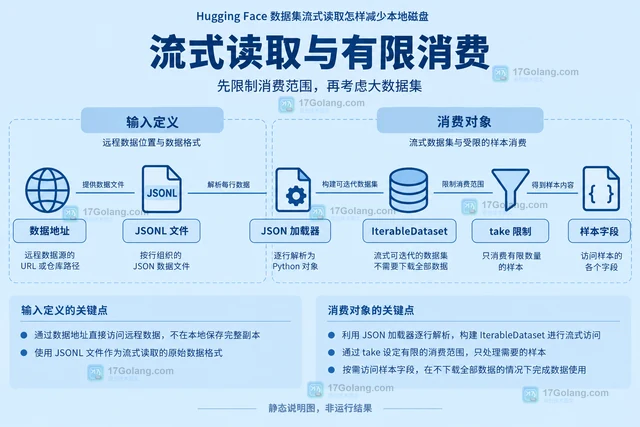 Hugging Face Datasets 的 streaming 可减少全量预下载和 Arrow 转换需求,但不等于零磁盘。本文给出有限消费示例,比较 Dataset 与 IterableDataset,并说明打乱缓冲、缓存位置、输出落盘和恢复边界。278 收藏
-
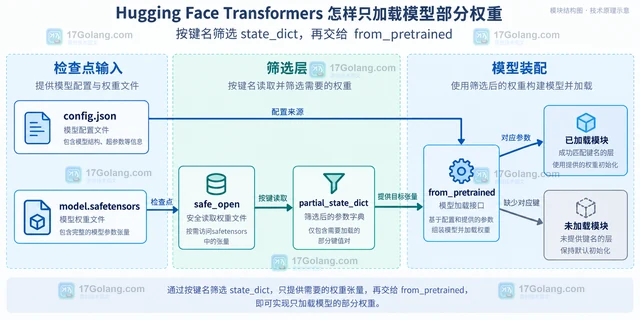 用 Transformers 按键名筛选 state_dict 只加载目标模块,并区分部分权重加载与 device_map 显存分配,避免把随机初始化层误当成预训练权重。395 收藏
-
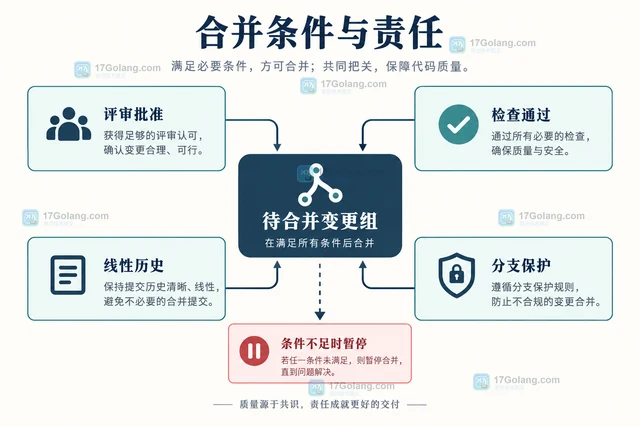 GitHub堆叠拉取请求正式可用,支持拆分依赖变更与集中合并。本文说明适用范围、CI触发、合并条件及自动合并分批推出的边界。430 收藏
-
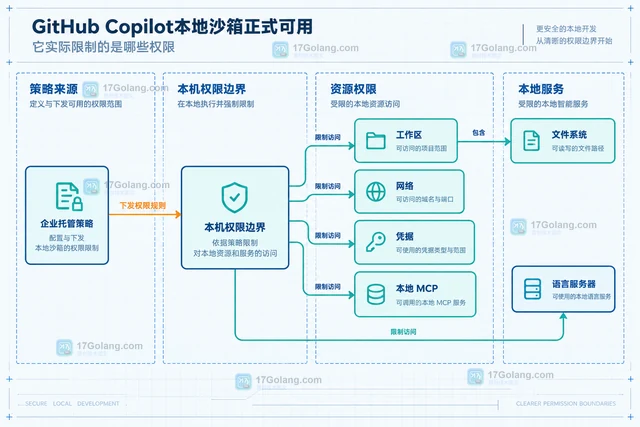 GitHub 官方公告显示,Copilot CLI 从 1.0.94-0 起可在 /model 中发现运行中的本地 Ollama 模型,并与已配置模型、GitHub 云端模型一起选择。本文说明发现、添加、会话使用与离线模式的边界。261 收藏