
人工智能技术文章
-
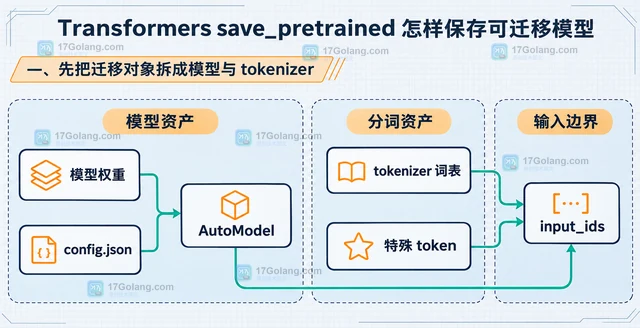 用 Transformers 的 save_pretrained 分别保存模型和 tokenizer,整理权重、配置与词表的目录关系,并说明如何在新环境中恢复。268 收藏
-
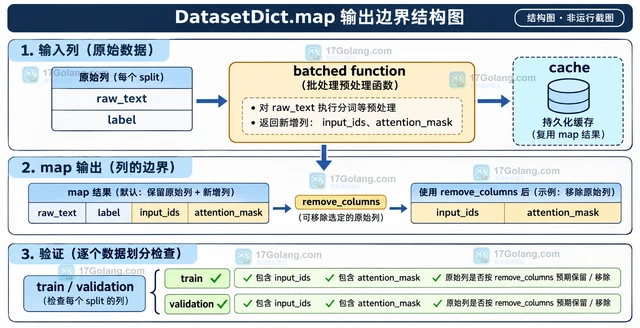 DatasetDict.map 会把同一个预处理函数应用到 train、validation 等分片,返回的仍是 DatasetDict。本文用 batched 函数、remove_columns 和逐分片检查,说明统一预处理的写法、缓存边界与常见误区。267 收藏
-
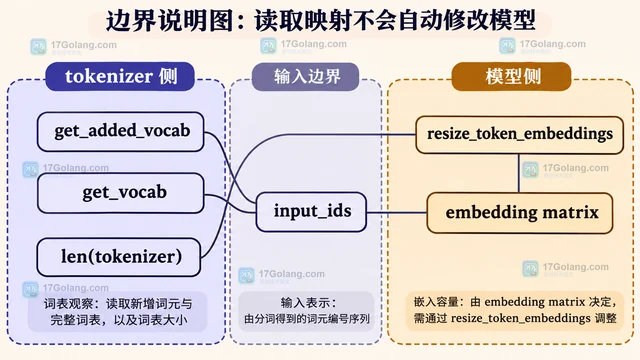 用 Transformers 的 get_added_vocab 读取新增词元到 token id 的映射,并区分 get_vocab、add_tokens 返回值与模型嵌入矩阵之间的边界。267 收藏
-
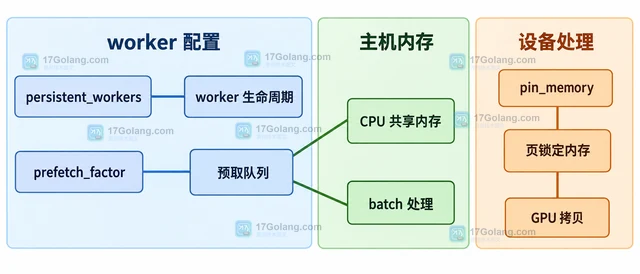 PyTorch DataLoader 的多进程预取会同时受到 num_workers、prefetch_factor 和 batch_size 影响。本文给出按共享内存预算限制预取批次的配置方法,并区分 worker 生命周期、pin_memory 与真实内存瓶颈。265 收藏
-
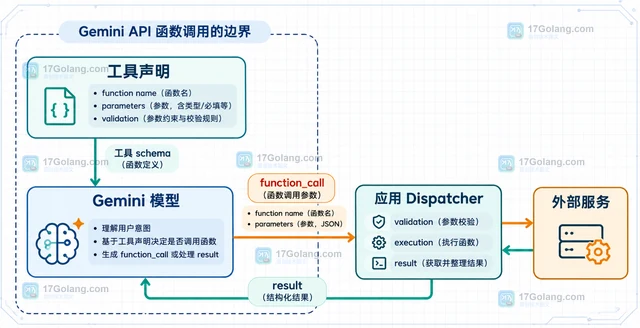 用 Gemini API 串联多个工具时,关键是把工具声明、模型决策、本地执行和结果回传拆开,并用依赖顺序控制调用链。265 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · vLLM KV Cache gpu-memory-utilization max-num-batched-tokens max-num-seqs 批处理显存
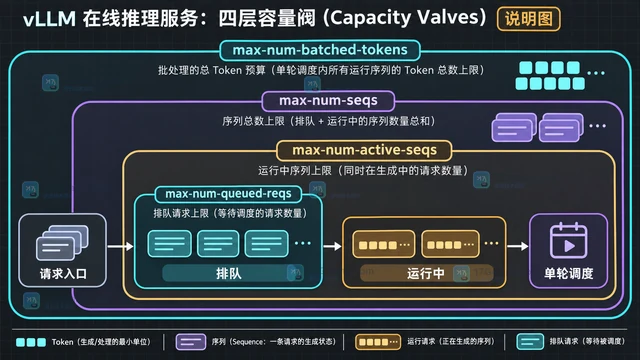 vLLM 的 gpu-memory-utilization 只划定单实例显存预算,不直接限制批处理条数。本文用 max-num-batched-tokens、max-num-seqs、max-num-active-seqs 和排队上限拆开说明显存、单轮批量与入口容量的配置边界。265 收藏
-
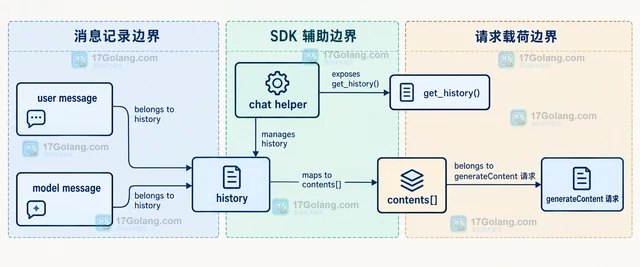 Gemini API 多轮对话不能只发送当前问题:新项目可保存 interaction_id 续接服务端状态,generateContent 则要维护并重新提交 contents 历史。263 收藏
-
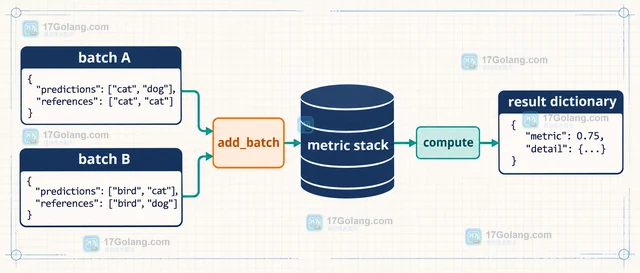 用 Hugging Face Evaluate 完成指标加载、输入格式确认、批量提交预测结果和最终 compute,并解释一次性计算与增量计算的选择边界。261 收藏
-
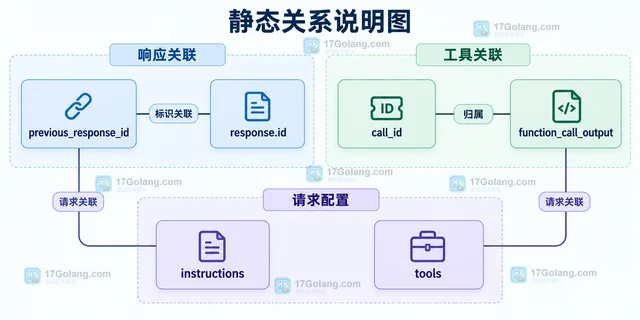 OpenAI Responses API 迁移旧工具调用代码,需要调整工具声明、输出项解析与 call_id 结果回传。本文以只读查询示例解释响应链续接、严格参数和失败出口。260 收藏
-
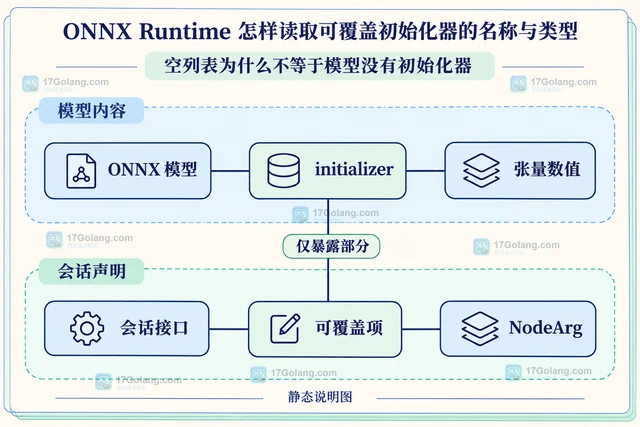 使用 ONNX Runtime get_overridable_initializers 读取可覆盖初始化器的名称、类型和形状,整理元数据报告,并区分空列表、加载异常、权重数值与性能结论。259 收藏
-
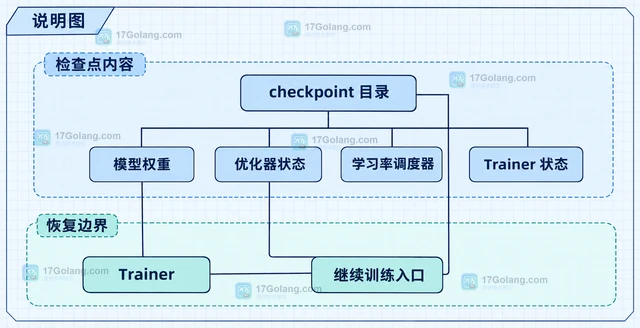 Transformers Trainer 继续训练时,不能只加载模型权重,而要把完整 checkpoint 交给 train(resume_from_checkpoint=...)。本文说明优化器、调度器、global_step、检查点目录和 ignore_data_skip 的关系,并给出显式路径与自动寻找最近检查点的写法。258 收藏
-
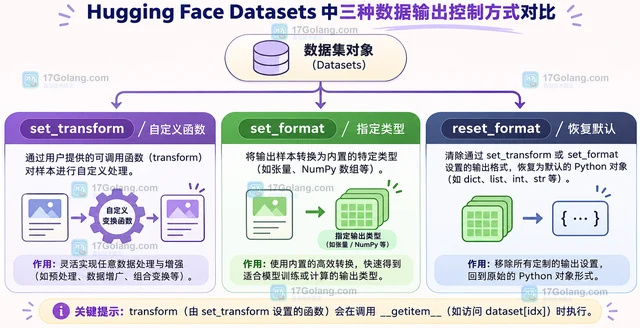 Hugging Face Datasets 的 set_transform 可以在索引或切片取样时按需生成模型输入和派生字段。本文说明 columns、output_all_columns、reset_format 与 with_transform 的边界,并给出保留原始列和生成 tokenizer 字段的原创示例。258 收藏
-
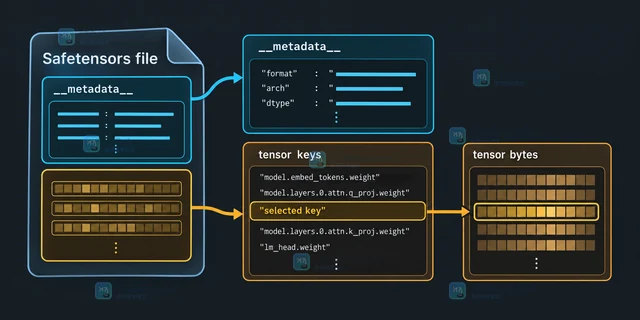 Safetensors 文件可以先通过 safe_open 查看权重键和文件级元数据,再按目标键读取单个张量。本文说明 get_tensor、get_slice、metadata 的分工,并处理缺键、空元数据和分片模型边界。256 收藏
-
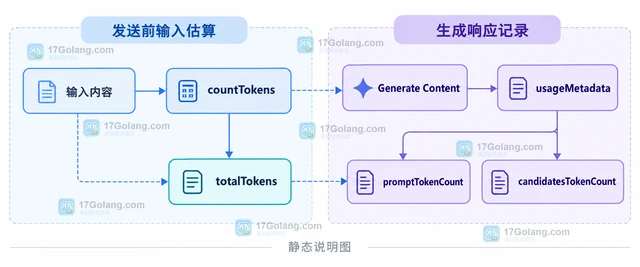 Gemini API 的 countTokens 只用于发送前估算输入规模,生成响应中的 usage metadata 才记录本次请求的实际输入、输出、缓存、工具调用与思考 token。本文用 Python 区分两类数字及其使用场景。254 收藏
-
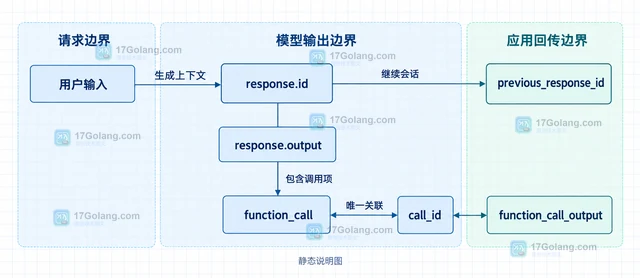 Responses API 的 tool call 不是把一段文本塞回对话,而是用 response.output、function_call、call_id 与 function_call_output 维持调用关联。本文从安全边界、回传控制和审计记录说明状态怎样串联。253 收藏