
人工智能技术文章
-
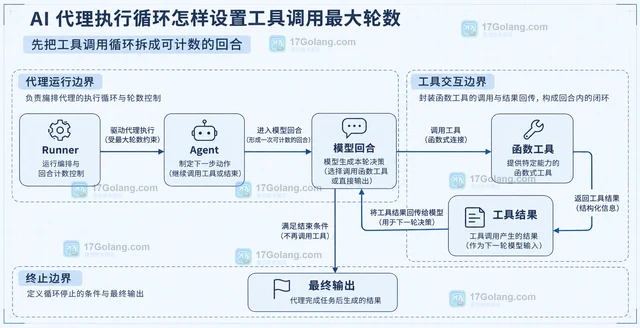 AI 代理的工具调用循环应把 max_turns 当作模型回合硬上限,再分别观测工具错误率、延迟与成本。本文用 OpenAI Agents SDK 的 Runner 示例说明上限触发、受控退出、并发工具和嵌套代理的预算边界。253 收藏
-
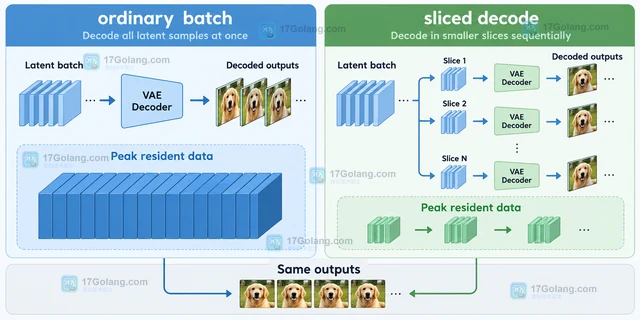 本文围绕 Diffusers enable_vae_slicing,说明多图 VAE 解码的显存峰值来源、管线级启用方式、受控测量方法和速度与显存之间的取舍。252 收藏
-
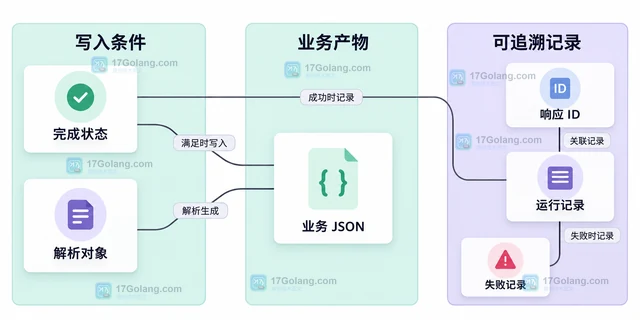 本文用 Python 说明 Responses API 如何按结构化 Schema 取得解析对象,并把业务字段、响应状态和运行记录分开保存为 JSON。250 收藏
-
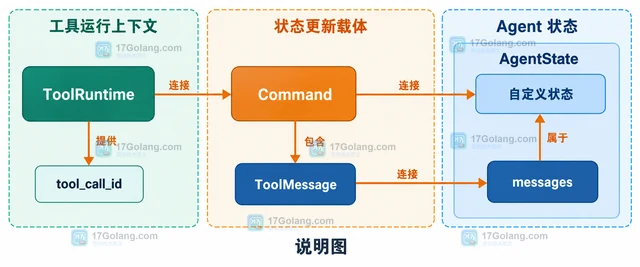 LangChain 的工具调用不是把返回值自动塞进任意列表,而是要用 AIMessage 中的调用记录和匹配的 ToolMessage 组成连续消息历史;工具还需要改状态时,再通过 Command 同时写回 messages 和自定义状态。250 收藏
-
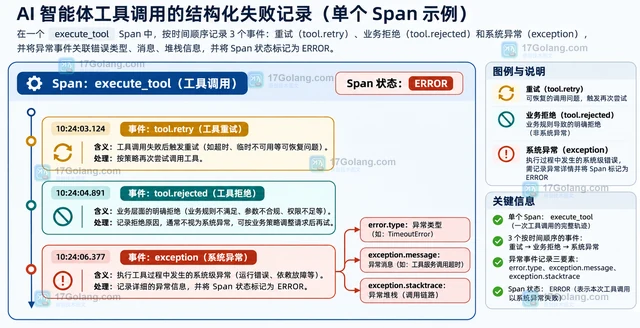 用 OpenTelemetry 把 AI 代理、模型、工具和下游依赖串成一棵 Trace 树,并用结构化事件记录重试、业务拒绝和异常原因。250 收藏
-
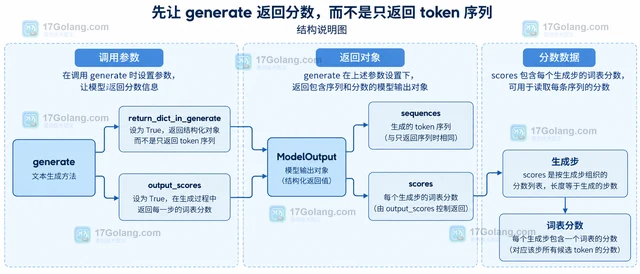 Transformers generate 默认主要返回生成序列。本文说明如何打开 return_dict_in_generate 与 output_scores,使用 compute_transition_scores 对齐每个生成 token 的分数,并区分 decoder-only、encoder-decoder 与 beam search 的边界。249 收藏
-
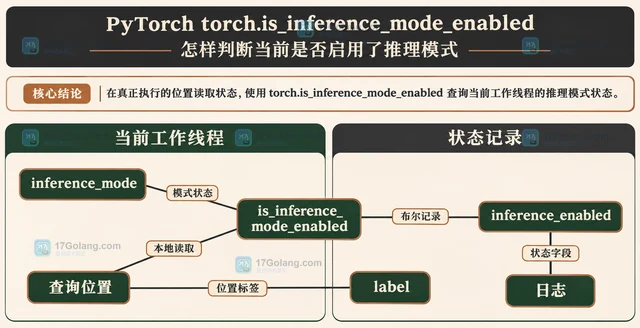 用局部上下文和预测入口示例说明 PyTorch 推理模式查询,解释布尔返回、线程局部性,并区分梯度开关、模型训练标记与推理状态。249 收藏
-
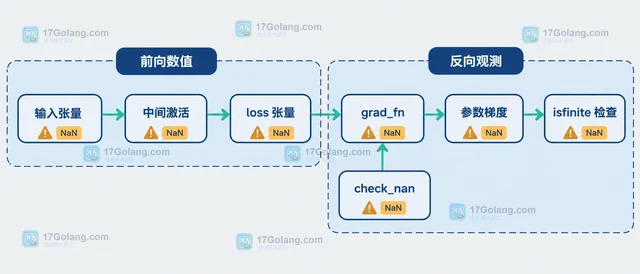 训练在 loss.backward() 阶段出现 NaN 或 Inf 梯度时,可以用 PyTorch autograd anomaly detection 保存前向 traceback,并结合 check_nan、isfinite 和梯度检查把范围收窄到具体算子与输入。248 收藏
-
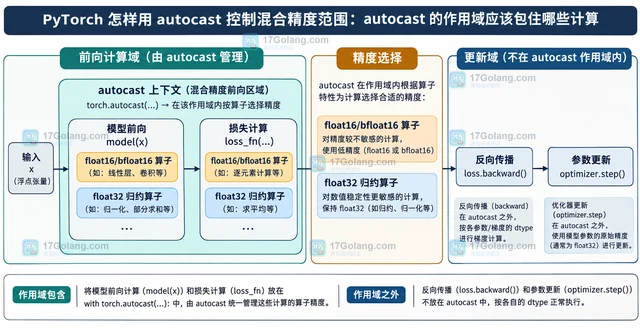 用 PyTorch 的 torch.autocast 控制混合精度范围:明确前向与损失计算的作用域,演示局部关闭 autocast 保留 float32,并说明 GradScaler、推理和常见边界。248 收藏
-
科技周边 · 人工智能 | 3星期前 | python · 人工智能 · snapshot_download Hugging Face Hub HF_HUB_CACHE HF_HOME 模型缓存 huggingface_hub
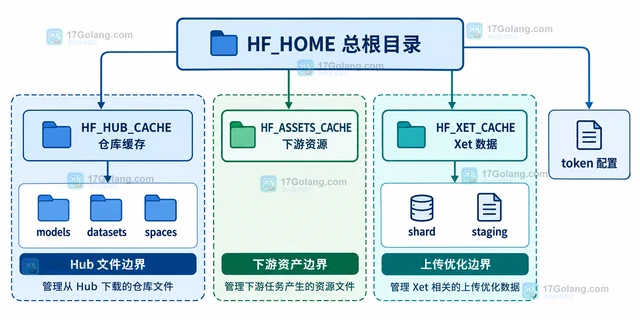 Hugging Face Hub 的模型缓存可以通过 HF_HOME、HF_HUB_CACHE、HF_ASSETS_CACHE 和 HF_XET_CACHE 分开管理。本文从目录边界、环境变量导入时机、repo 缓存结构、下载函数与清理边界几个方面说明如何让模型文件可控地复用。247 收藏
-
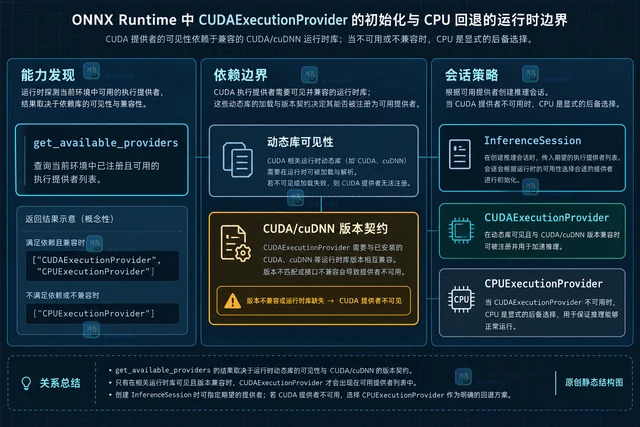 说明 ONNX Runtime 如何根据硬件、安装包和运行库选择 CPU 或 CUDA provider,给出可用能力判断、CUDA 优先回退 CPU 的 Python 写法,并梳理 CUDA 与 cuDNN 的兼容边界。246 收藏
-
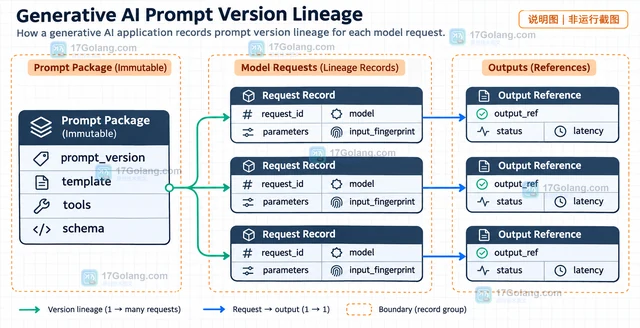 生成式 AI 应用应把提示词正文、工具定义和输出约束固定成不可变版本,再用 request_id 关联模型请求与输出。本文给出版本键、请求事件字段和敏感数据分层记录方法。243 收藏
-
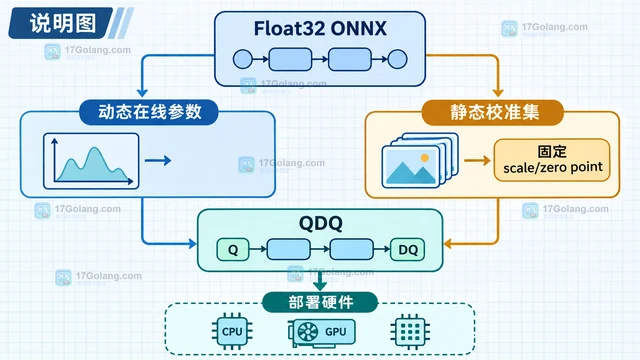 用同一份 ONNX 模型比较 ONNX Runtime 动态量化与静态量化,说明校准数据、输入契约、量化格式和中间激活如何造成空输出或结果偏差,并给出可复用的排查清单。242 收藏
-
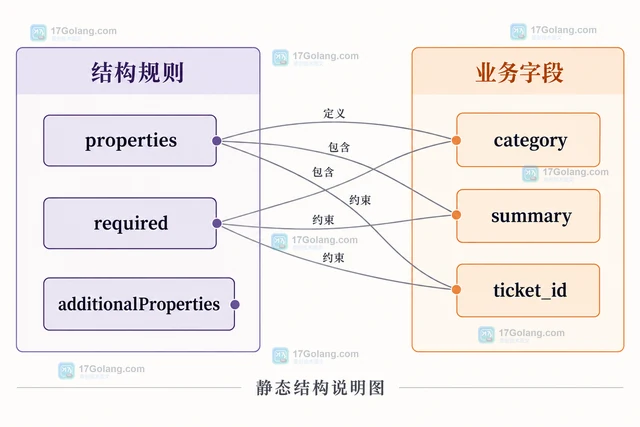 JSON Schema 约束模型输出教程:在 Responses API 配置 text.format、必填字段与空值,处理拒绝和未完成响应,区分结构正确与业务事实正确。241 收藏
-
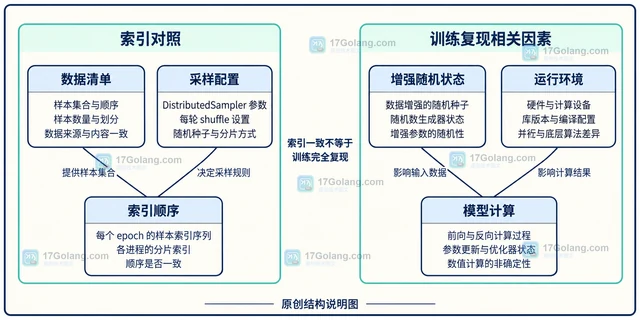 PyTorch DistributedSampler 以共同 seed 与逐轮 set_epoch 控制打乱。本文说明调用位置、rank 划分、尾部处理和恢复训练时的索引复现范围,并给出小样本对照代码。241 收藏