
人工智能技术文章
-
科技周边 · 人工智能 | 6天前 | 性能优化 · Hugging Face Datasets IterableDataset flatten_indices indices mapping Arrow
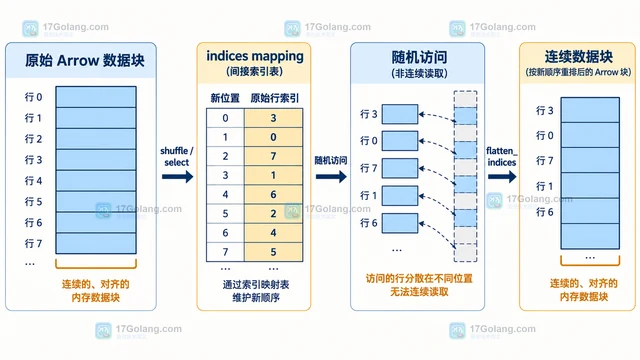 Hugging Face Datasets 在 shuffle、select 等操作后可能带有 indices mapping,导致访问不再连续。本文用 flatten_indices 重写数据,说明缓存、批量写入、并行和 IterableDataset 的选择边界。222 收藏
-
科技周边 · 人工智能 | 3小时前 | 性能优化 · 人工智能 · 深度学习 · PyTorch CUDA SDPA scaled_dot_product_attention Flash Attention
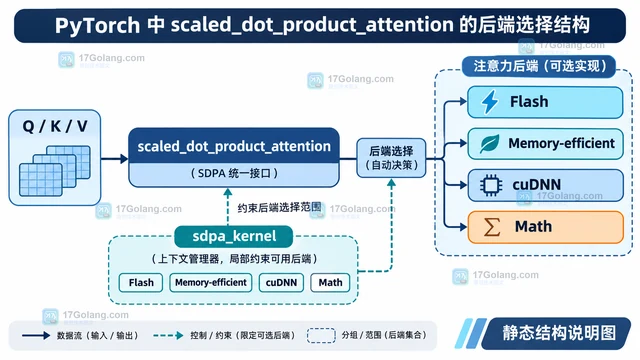 PyTorch 的 scaled_dot_product_attention 默认会根据输入和设备选择可用实现。本文用 sdpa_kernel 说明如何做局部后端约束,并从 CUDA、dtype、mask、dropout、GQA 和数值精度几个条件判断 fused kernel 为什么回退。214 收藏
-
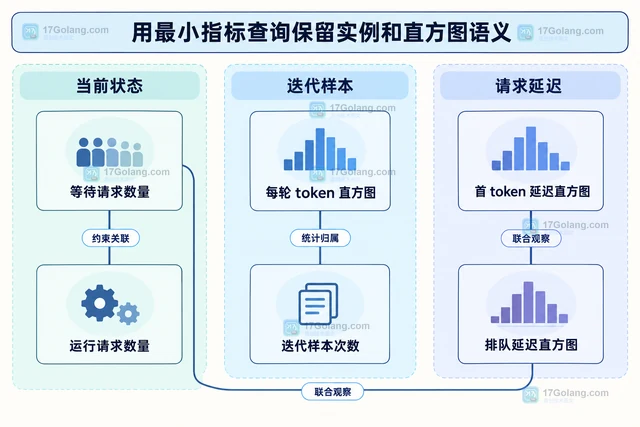 观察 vLLM continuous batching 时,将等待队列、运行请求、每轮 token、KV 缓存和延迟分开统计,说明旧指标迁移、PromQL 查询口径及调度参数的取舍。211 收藏
-
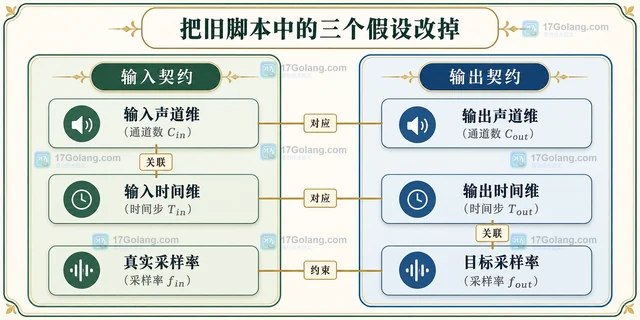 torchaudio多声道重采样应保留声道维并沿最后一维处理。结合48kHz到16kHz的张量示例,说明旧脚本迁移、采样率标签、核缓存及设备精度的配套修改。210 收藏
-
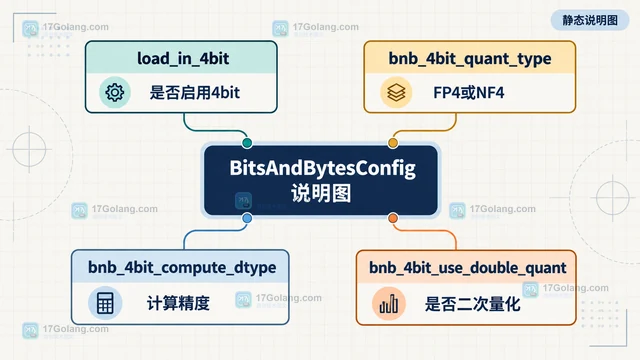 通过 BitsAndBytesConfig.to_dict() 和 model.config.quantization_config 读取 4bit 量化配置,重点区分 load_in_4bit、nf4/fp4、计算 dtype 与双重量化字段。205 收藏
-
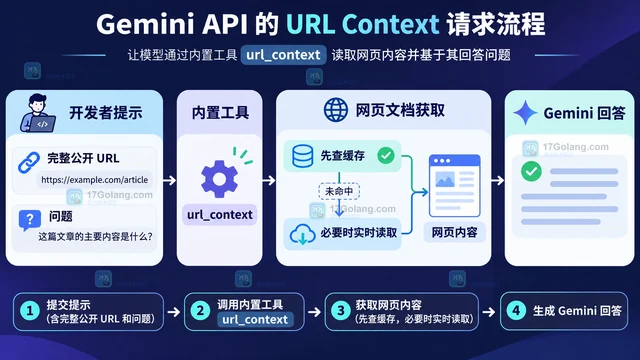 本文围绕 Gemini API 内置 URL Context,说明如何提交公开网页、如何读取 URL 引用与检索状态,以及 20 个 URL、34MB、登录墙和私有网络等输入边界。204 收藏
-
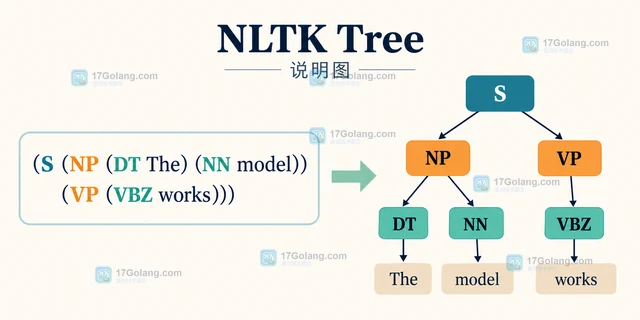 用 NLTK Tree.fromstring 读取括号形式句法树,掌握根节点、叶子、树位置和自定义括号等参数的实际用法。203 收藏
-
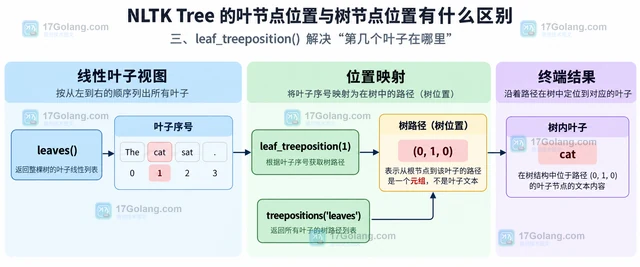 NLTK Tree 的位置元组既可以定位根节点和短语节点,也可以定位具体叶子。本文用一棵句法树区分 treepositions、treepositions('leaves')、leaf_treeposition 与连续叶子范围定位。197 收藏
-
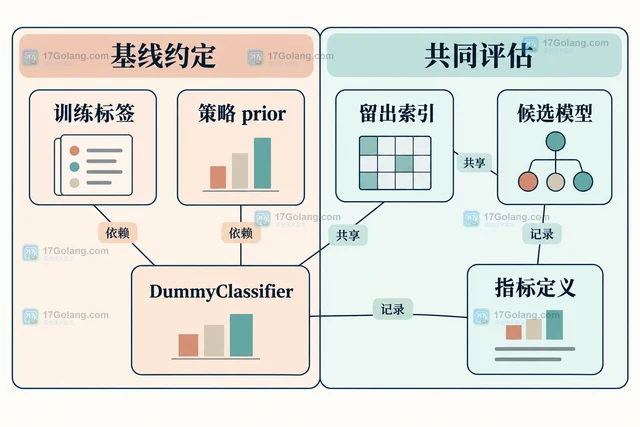 使用 DummyClassifier 为分类任务建立参照,说明 prior 等策略、相同数据划分与指标比较,并通过合成数据示例记录准确率、平衡准确率和评估失败状态。189 收藏
-
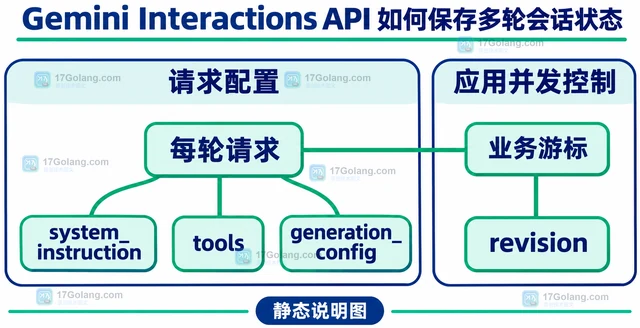 通过 previous_interaction_id 继续 Gemini 多轮会话,说明游标持久化、每轮配置、并发分支与保留期限,并提供 Python 示例。187 收藏
-
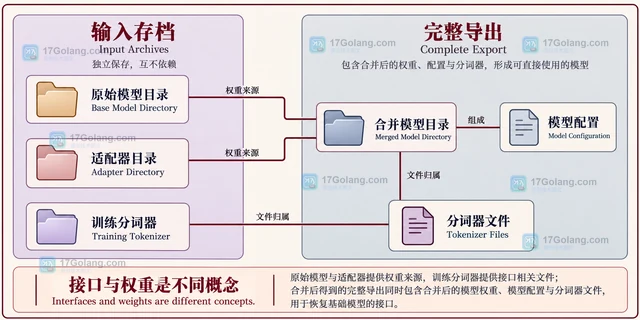 PEFT通过merge_and_unload返回保留适配器效果的普通模型。文章说明返回值使用、完整导出、可撤销合并,以及恢复接口与还原原始权重的区别。185 收藏
-
 用 ONNX Runtime SessionOptions 开启 profiling,完成代表性推理后通过 end_profiling 导出 JSON,再按 Node、Kernel 与 dur 字段定位算子级延迟,避免误把主机事件和设备事件重复计算。178 收藏
-
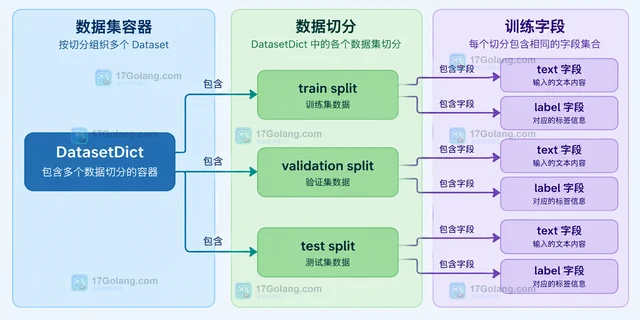 用 Hugging Face Datasets 的 select_columns 从 Dataset 或 DatasetDict 中保留训练所需字段,配合 column_names、features 和 split 检查处理字段缺失与结构不一致。174 收藏
-
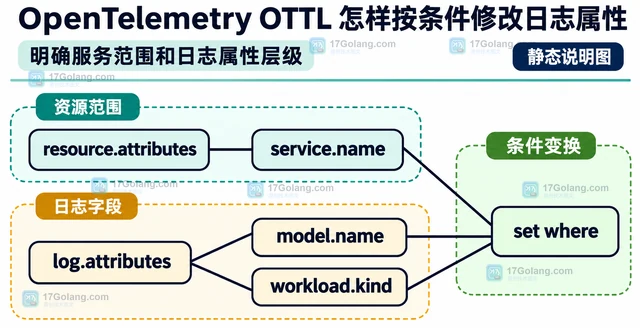 用 OTTL set where 按服务与字段条件补日志属性,提供 Collector 配置,并说明资源层级、缺失值、覆盖、条件组合与错误策略。172 收藏
-
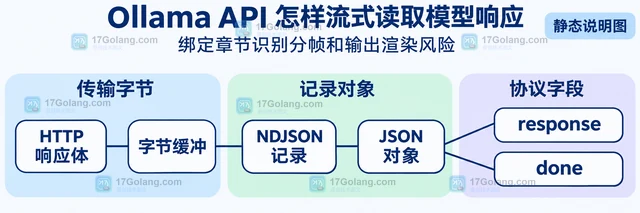 通过 Python 逐行解析 Ollama NDJSON 流,处理文本增量、完成标记、流内错误和连接关闭,并区分中断草稿与完整响应。167 收藏