
人工智能技术文章
-
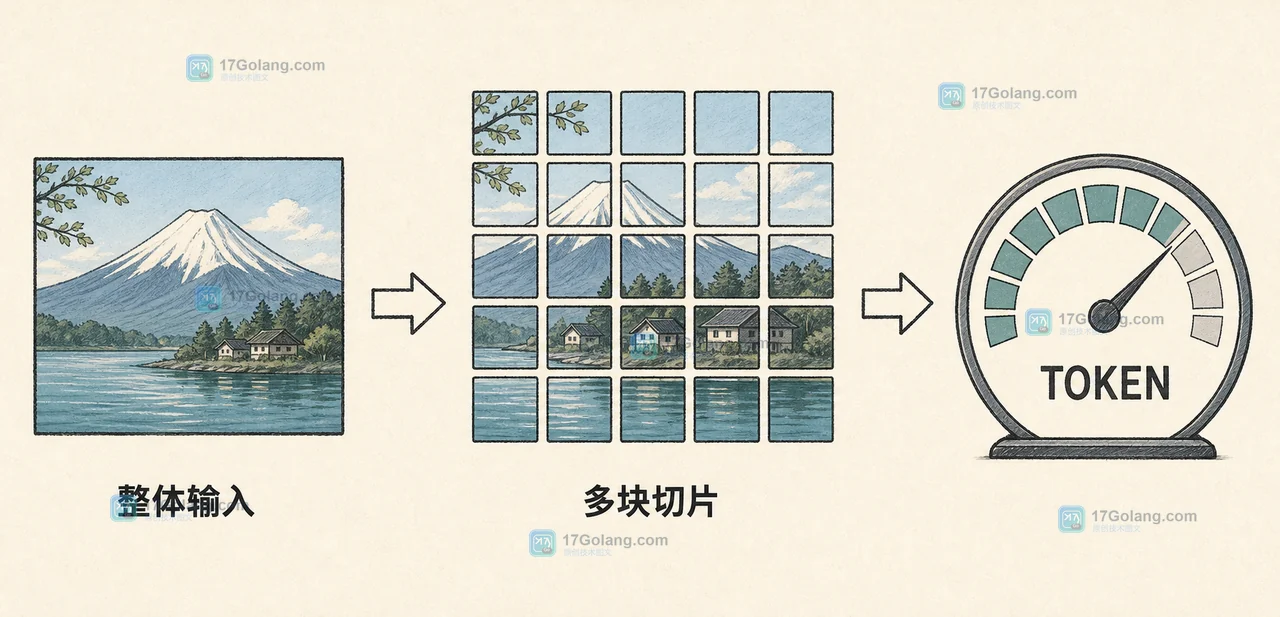 多模态接口处理图片时,分辨率越高不一定越划算。本文用图片尺寸、切片数量和 media_resolution 拆开 token 与延迟的关系,并给出调用前估算、缩放和结果复核方法。161 收藏
-
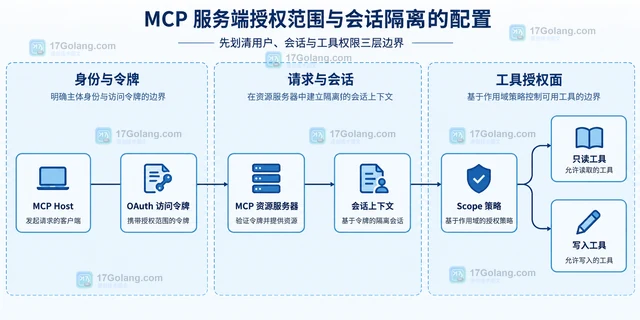 从 HTTP 令牌校验、scope 工具映射、请求级授权上下文和审计字段四个层面,说明如何配置 MCP 服务端的授权范围与会话隔离,避免主体、租户和写入权限混用。161 收藏
-
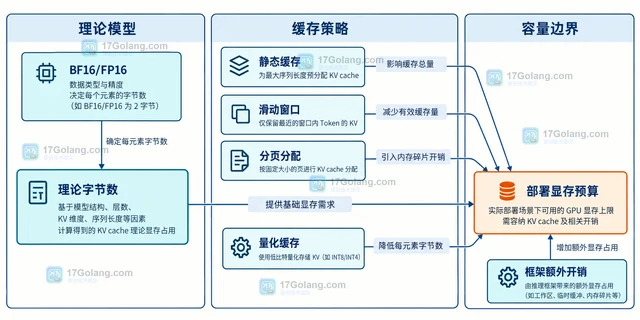 LLM 推理时,KV cache 显存主要随 batch、层数、KV 头数、head_dim、上下文 token 数和缓存精度线性增长。本文给出可手算的公式,用 GQA 示例比较 BF16 与 FP16,并说明静态缓存、滑动窗口、分页分配和量化缓存带来的实际差异。158 收藏
-
 JAX 未注册的自定义类会整体作为叶子,无法让 jax.jit 看到内部数组。本文用 register_pytree_node、register_pytree_node_class 和 register_dataclass 说明动态字段、静态元数据与对象重建的注册边界。156 收藏
-
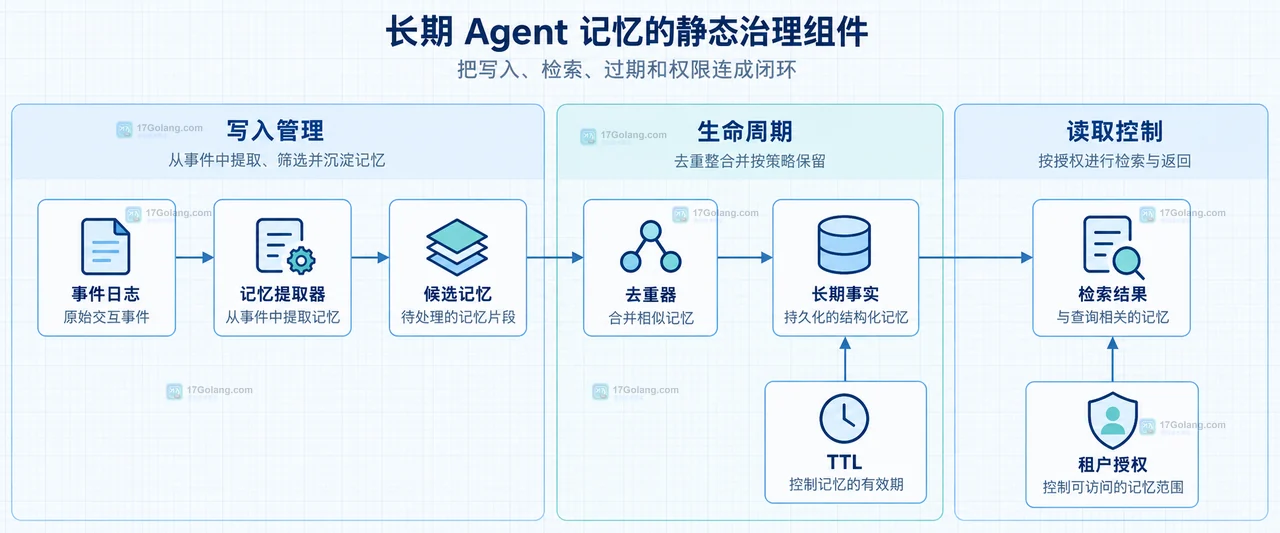 AI Agent 的短期上下文负责当前线程,长期存储负责跨会话复用。本文从边界、数据类型、写入检索和权限保留四个方面给出一套可落地的记忆设计方法。155 收藏
-
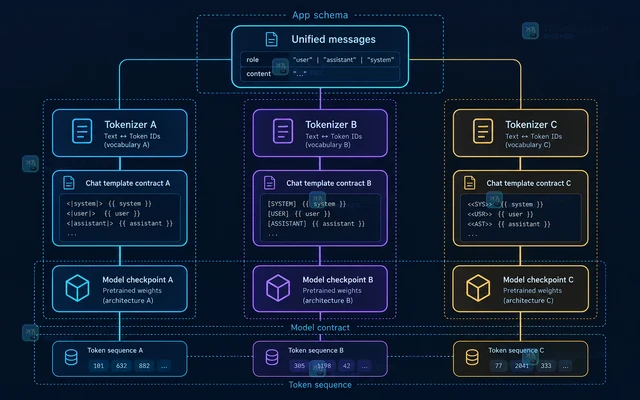 多模型服务应统一 role/content 消息结构,而不是硬编码一套控制 token。本文用 tokenizer.apply_chat_template 建立模型契约层,区分普通回复、预填续写与训练格式,并说明特殊 token 和能力边界。154 收藏
-
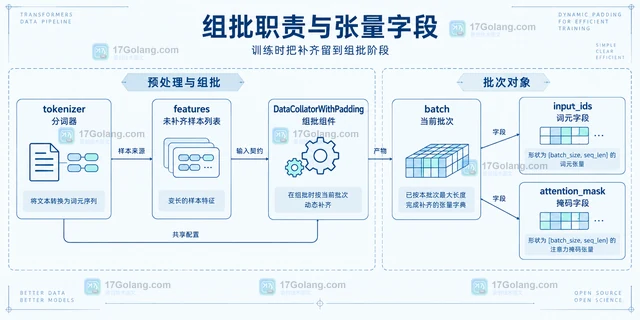 比较Transformers批次分词的动态补齐与固定长度补齐,说明截断上限、collator组批职责和部署形状约束,并给出可复制代码与实际观测指标。153 收藏
-
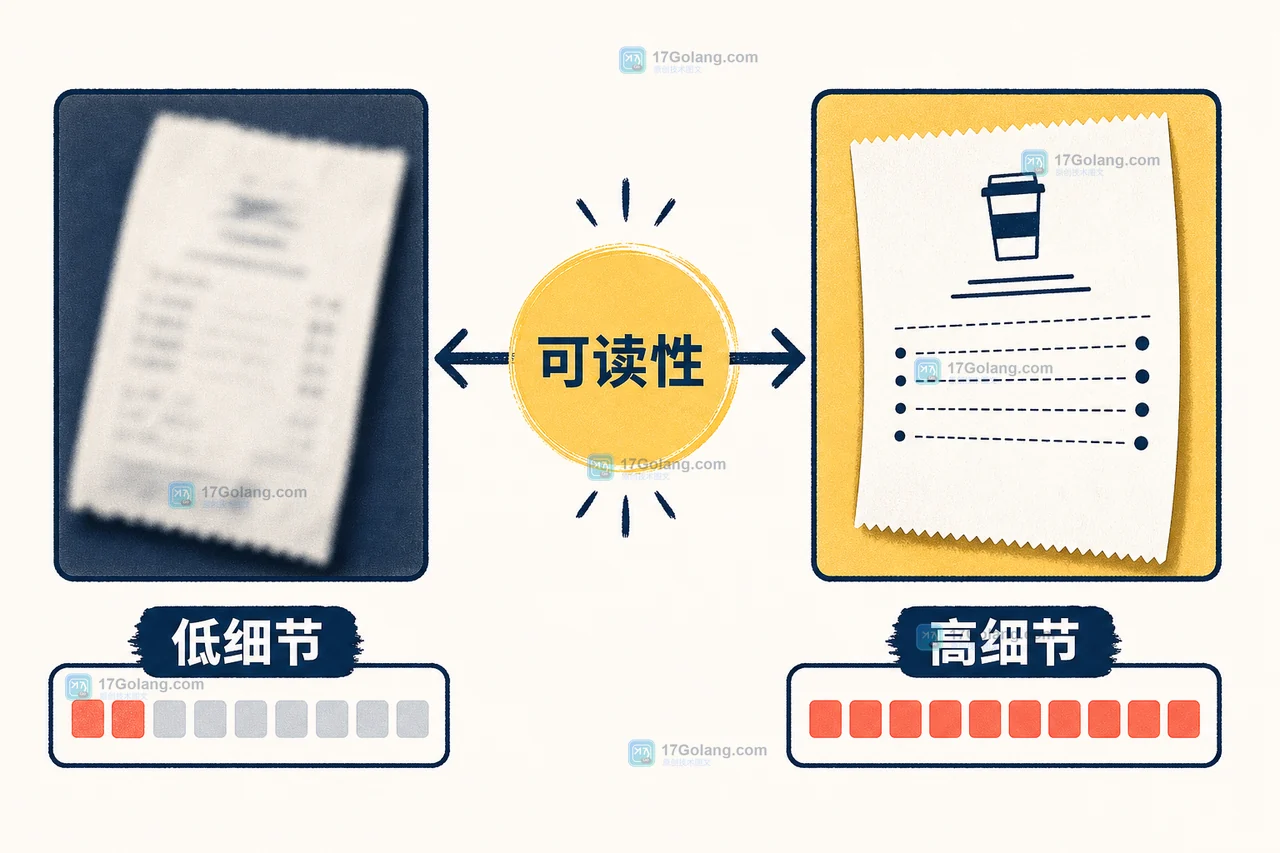 图片输入的成本不只由文件大小决定,还受模型细节档位、有效分辨率和长图切分方式影响。本文用一套可复核的输入策略,判断何时用低细节、何时保留高分辨率,以及长图如何切成可验收的局部图片。152 收藏
-
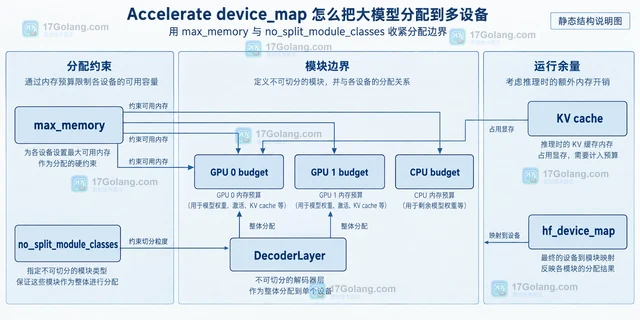 通过 Transformers 与 Accelerate 的 device_map=auto、max_memory 和 no_split_module_classes,把大模型稳妥分配到多张 GPU,并检查 CPU 或磁盘卸载边界。150 收藏
-
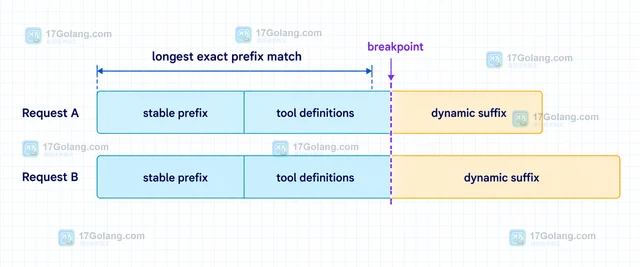 用 Responses API 的 usage 字段判断 prompt caching 是否命中,并通过稳定前缀、显式 breakpoint 与诊断信息排查缓存边界。150 收藏
-
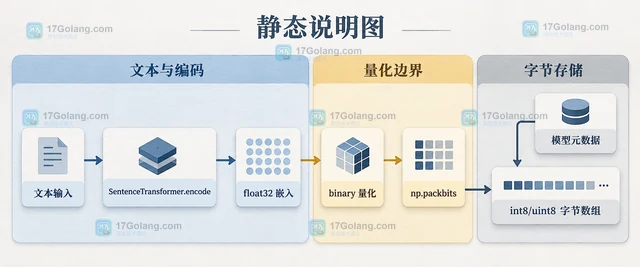 Sentence Transformers 可以在 encode 阶段直接生成 binary 嵌入,也可以把已有 float32 向量交给 quantize_embeddings。本文说明 bit 打包后的 shape、dtype、保存元数据,以及二进制召回与高精度重排的配合方式。150 收藏
-
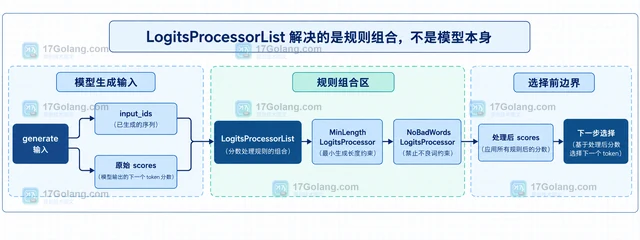 Transformers LogitsProcessorList 会按列表顺序依次处理生成分数。本文用最小长度、禁用词、分数归一化和自定义处理器说明如何组合规则,并给出接入 generate 与排查失效的实用方法。149 收藏
-
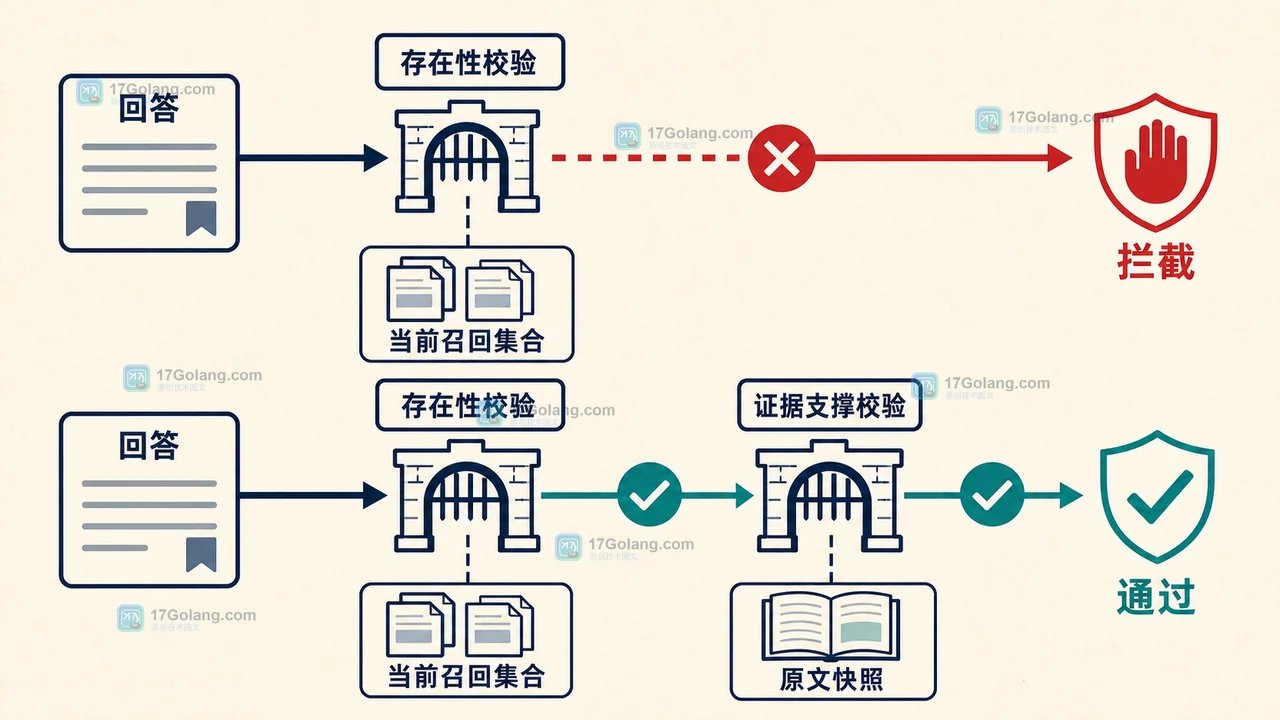 RAG 应用里,回答看似有引用却指错段落,往往不是模型单独出错,而是切块编号、索引元数据和原文版本没有保持同一条链路。本文用文档快照、chunk_id 和回答后验校验,搭一套可定位、可回归的引用验收方法。148 收藏
-
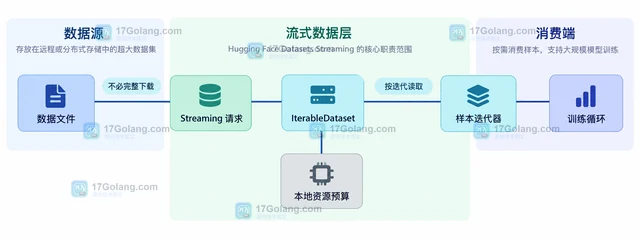 Hugging Face Datasets Streaming 通过 IterableDataset 边迭代边读取超大数据集。本文给出加载、抽样、缓冲打乱、在线变换、分片与训练观测的完整用法和适用边界。148 收藏
-
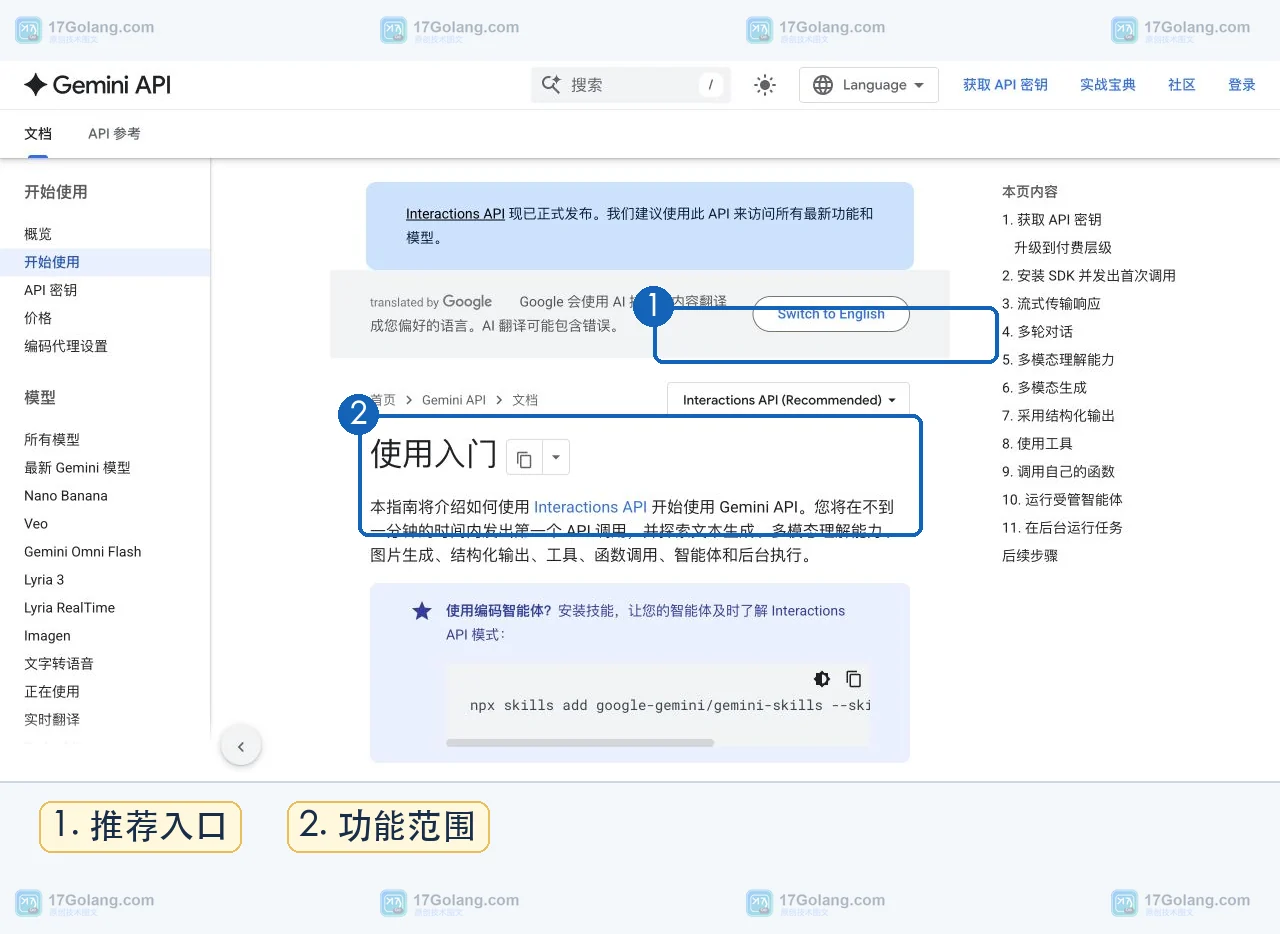 Gemini Interactions API 将输出格式统一到 response_format,本文结合 Google 官方文档拆解 text、audio、image 配置迁移,以及 JSON Schema 格式正确但业务值仍需校验的边界。147 收藏