
人工智能技术文章
-
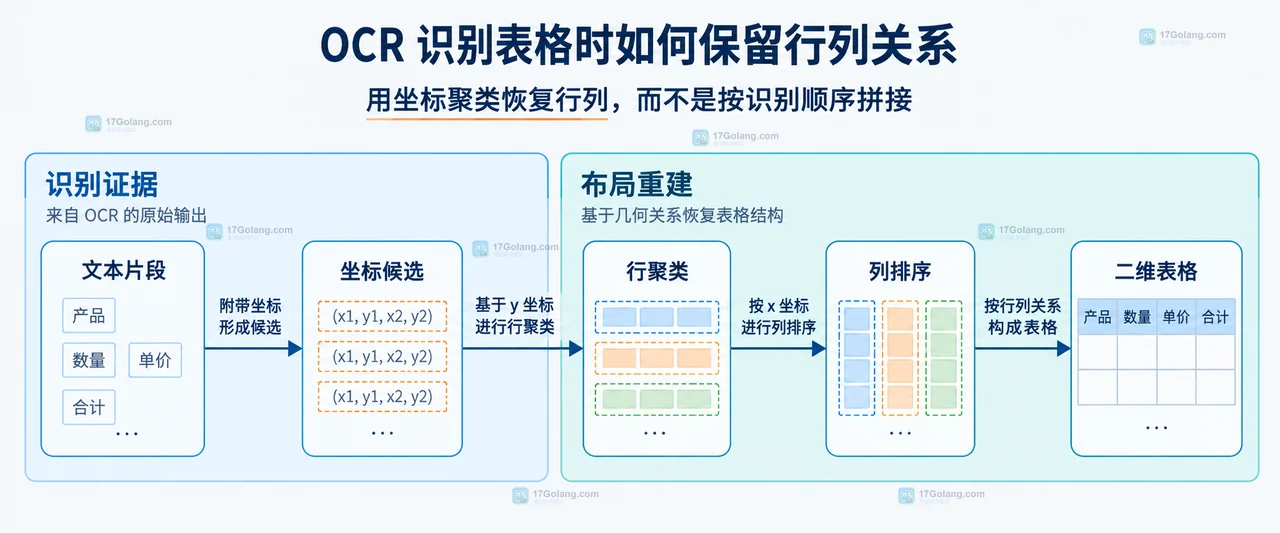 OCR 识别表格不能只保留文字,还要保存每个片段的坐标框,再通过行聚类、列排序和跨度判断重建二维结构。本文给出一套可落地的处理流程。147 收藏
-
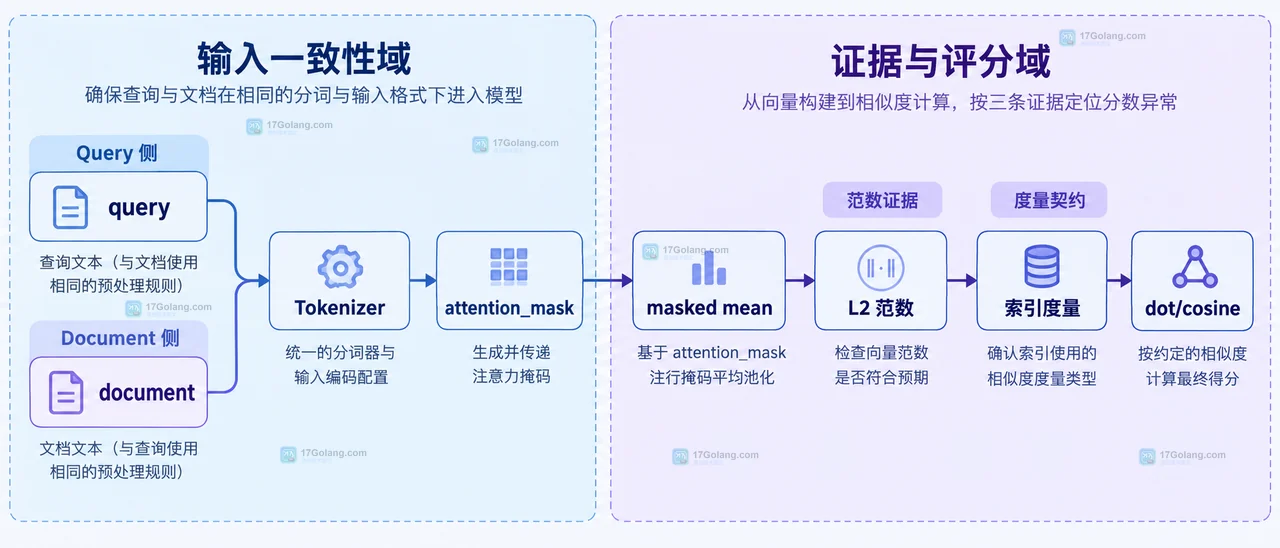 embedding 归一化不是简单打开一个开关:先统一 query 与 document 的向量契约,再检查池化、attention_mask 和相似度度量。本文给出两种配置方式和一套可复用的排查清单。147 收藏
-
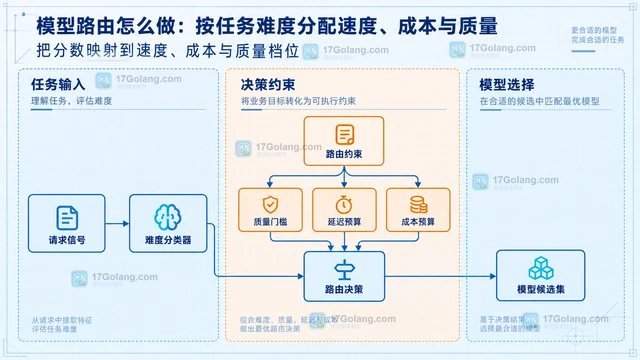 模型路由不只是按名称转发请求,而是根据任务难度、质量门槛、延迟预算和相对成本选择模型。本文用一个 Python 小项目实现可解释分类、分档选择、失败回退、质量升级和离线评测。147 收藏
-
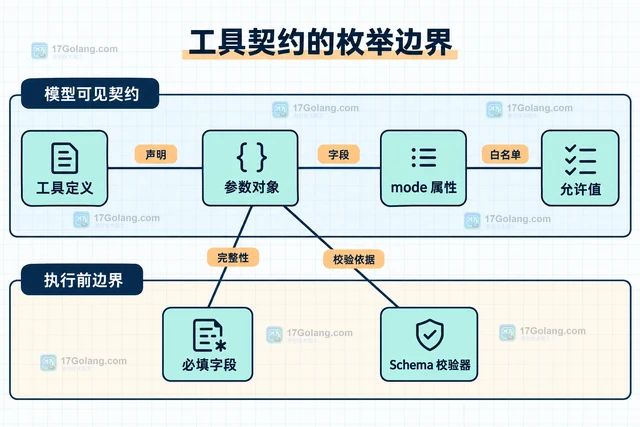 AI 工具调用参数只允许固定集合时,应在 JSON Schema 中使用 enum,并在真实工具执行前再次校验。本文用一个报告工具说明枚举契约、非法参数拒绝、错误分类、重试边界和版本兼容策略。147 收藏
-
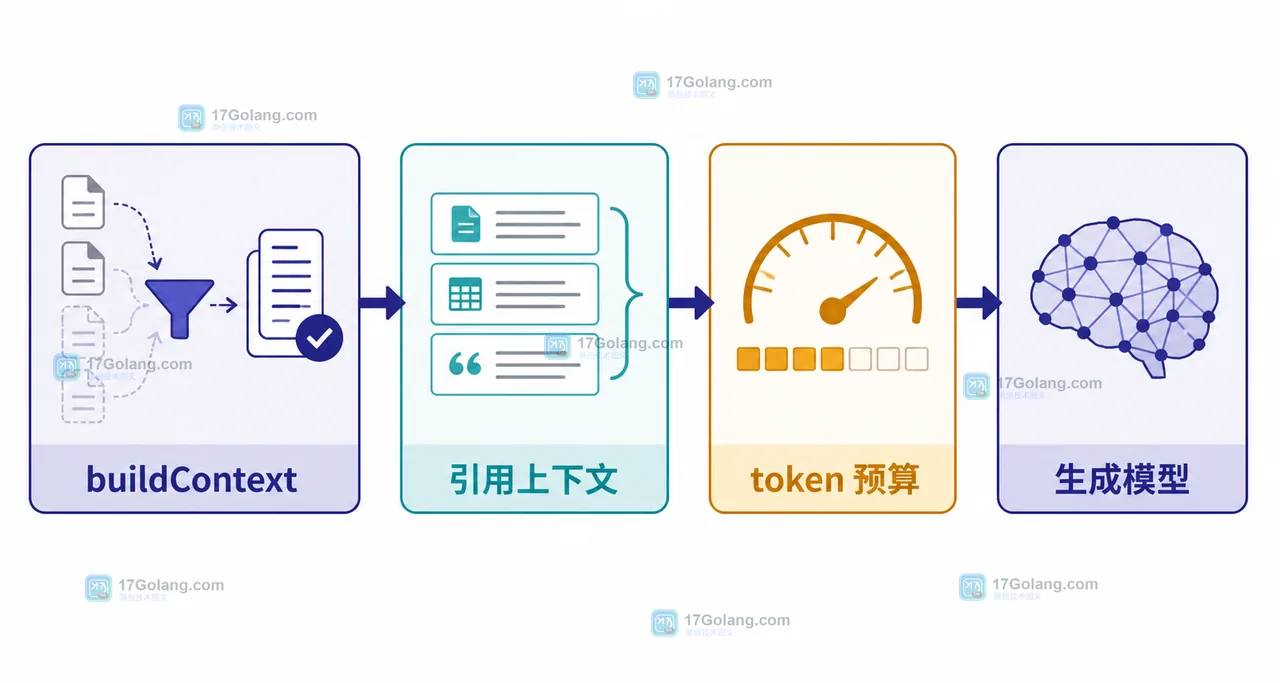 RAG 应用把检索结果直接拼进提示词,常会遇到重复段落挤占上下文、引用指向不稳定和答案被相似文档带偏的问题。本文用一条可回放的数据流说明候选文档如何去重、截断并组成引用上下文。146 收藏
-
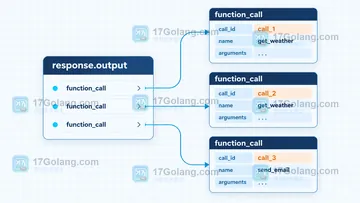 Responses API 一次返回多个 function_call 时,不要只处理第一项;保留完整 response.output,按每个 call_id 执行工具并逐条回传 function_call_output,才能避免结果串线。146 收藏
-
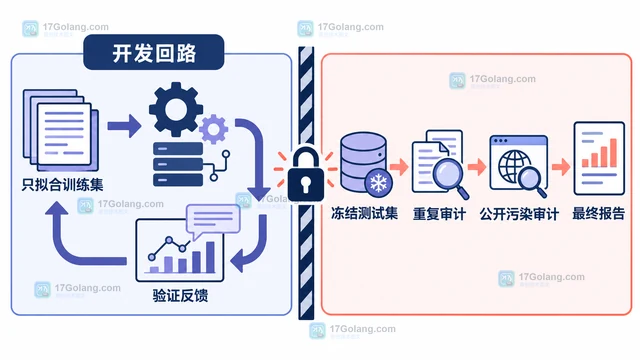 AI 评测分数异常偏高时,问题常不在指标本身,而在同源样本跨 split、预处理读到了测试集或公开基准已经进入训练语料。本文用来源分组、训练集拟合、冻结测试集和污染审计组成一套可落地的数据血缘方案。146 收藏
-
 在一次请求的流式窗口发生中断时,重发与否是关键风险点。本文给出以请求 ID、幂等键、状态回放与回退策略构成的恢复闭环。145 收藏
-
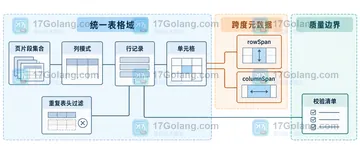 OCR 表格跨页合并不能简单拼接文本。本文从页级表格、重复表头、列位归一化和跨页断行四个边界入手,给出可落地的合并伪代码与结果检查清单。145 收藏
-
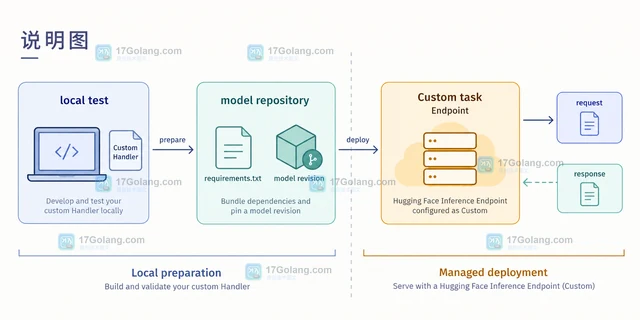 从 handler.py 的 EndpointHandler 结构、依赖管理、本地测试到 Custom 任务部署,说明 Hugging Face Inference Endpoint 编写自定义 Handler 的完整边界。145 收藏
-
科技周边 · 人工智能 | 1星期前 | JSON · API · python · 人工智能 · 结构化输出 · 结构化输出 JSON Schema Gemini API response_schema response_mime_type additionalProperties
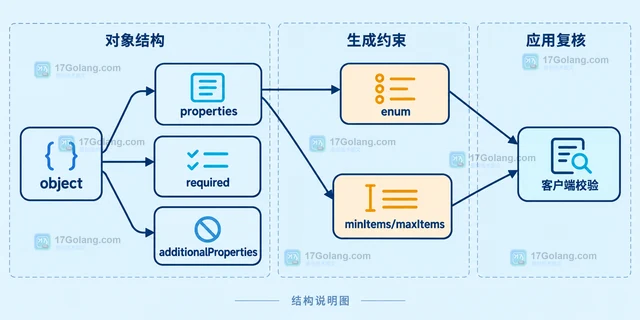 Gemini API 结构化输出要限制 JSON 字段,应把 response_mime_type 与 response_schema 一起配置,用 properties、required、enum 和额外字段策略约束形状,再在客户端校验业务语义。145 收藏
-
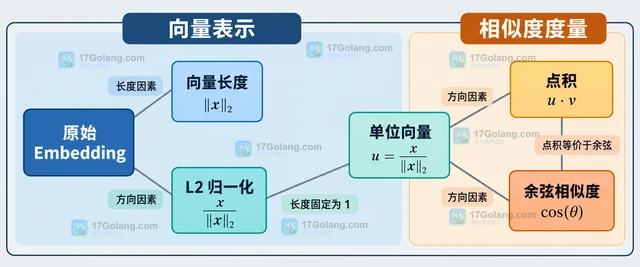 Embedding 做 L2 归一化后,向量长度不再参与点积排序,点积可以等价于余弦相似度。本文从公式、Sentence Transformers 用法和检索场景说明何时归一化,以及混用不同分数的风险。144 收藏
-
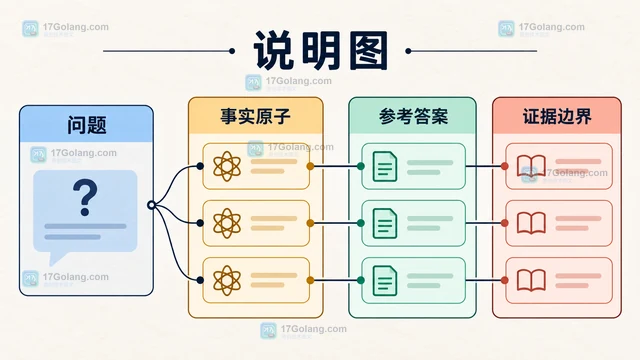 生成式回答的事实性评测不能只准备一组问题和一个总分。本文从样本边界、参考答案、事实原子、支持与矛盾判分以及人工复核五个方面,设计一套可比较的对照样本结构。144 收藏
-
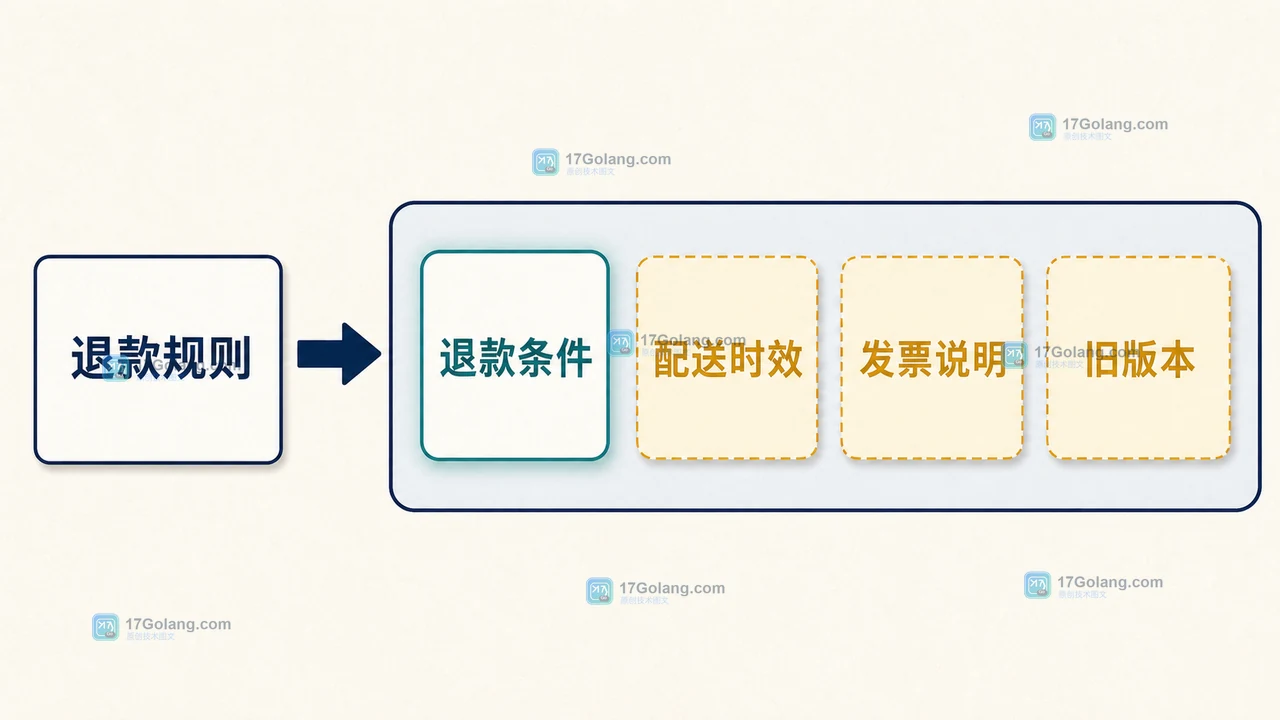 向量检索召回很多无关片段,通常不是单一模型失效,而是候选范围、相似度阈值和最终排序没有分层。本文用一个文档问答场景拆开召回噪声的定位路径,说明元数据过滤、score_threshold、候选集放大和重排的使用边界。141 收藏
-
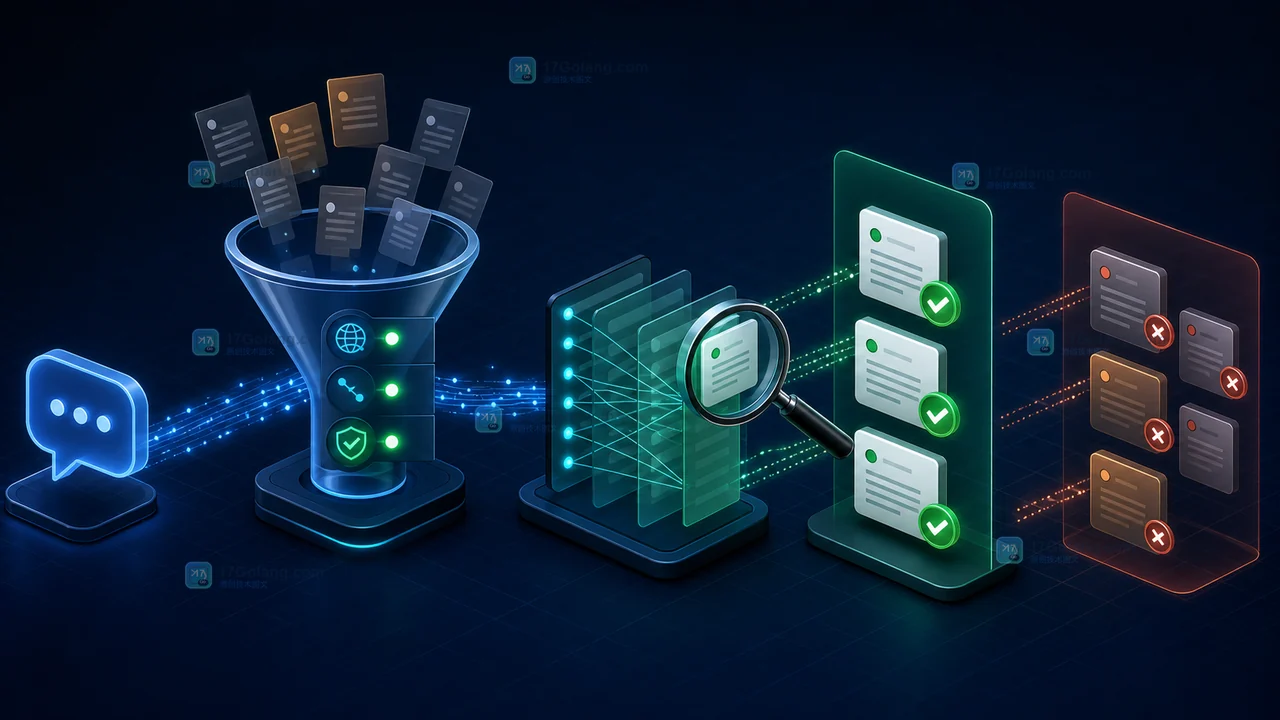 RAG 应用回答看似流畅却总带错文档,通常不是模型突然失常,而是切分、召回和证据核对没有连成一条可追踪链路。本文用一个知识库排障场景,拆解如何定位错召回并验证修复效果。141 收藏