
人工智能技术文章
-
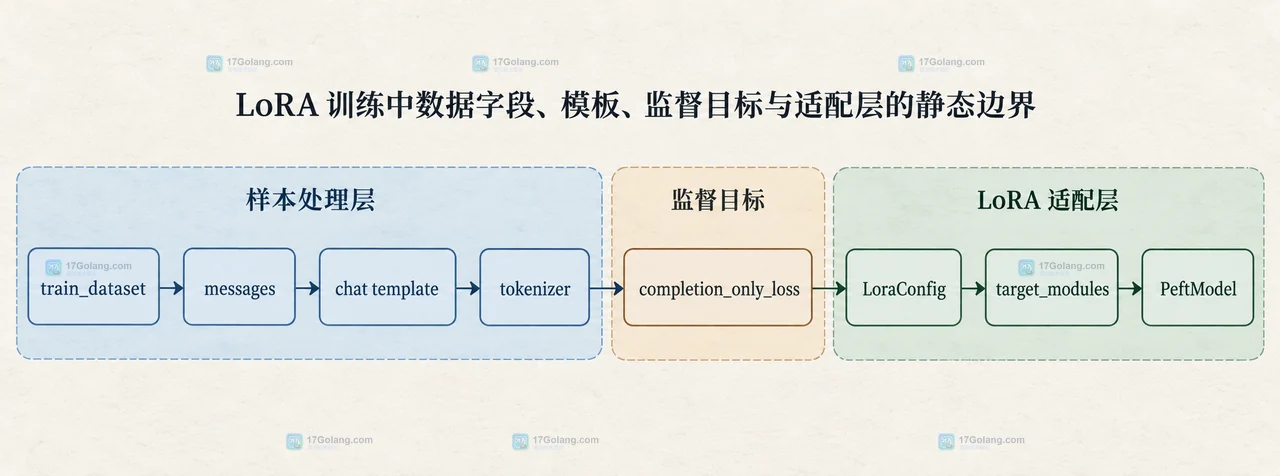 使用 Hugging Face TRL 做 LoRA 微调时,先把 instruction、input、output 等业务字段统一为 text、messages 或 prompt/completion,再分别排查聊天模板、损失目标和 target_modules 配置。171 收藏
-
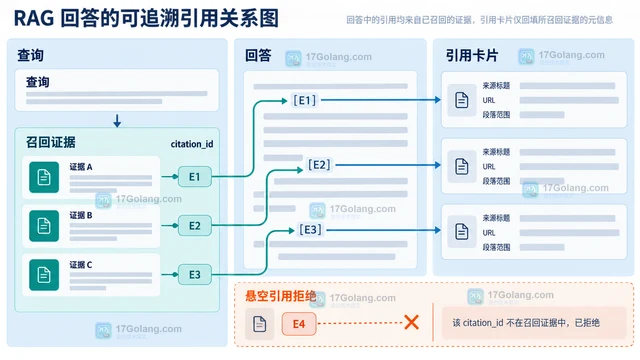 RAG回答要可追溯,关键不是把链接拼到末尾,而是让每个检索片段从入库开始就带有稳定来源身份、位置和引用编号。本文给出证据记录、提示词传递、引用渲染与回归检查的实现方法。171 收藏
-
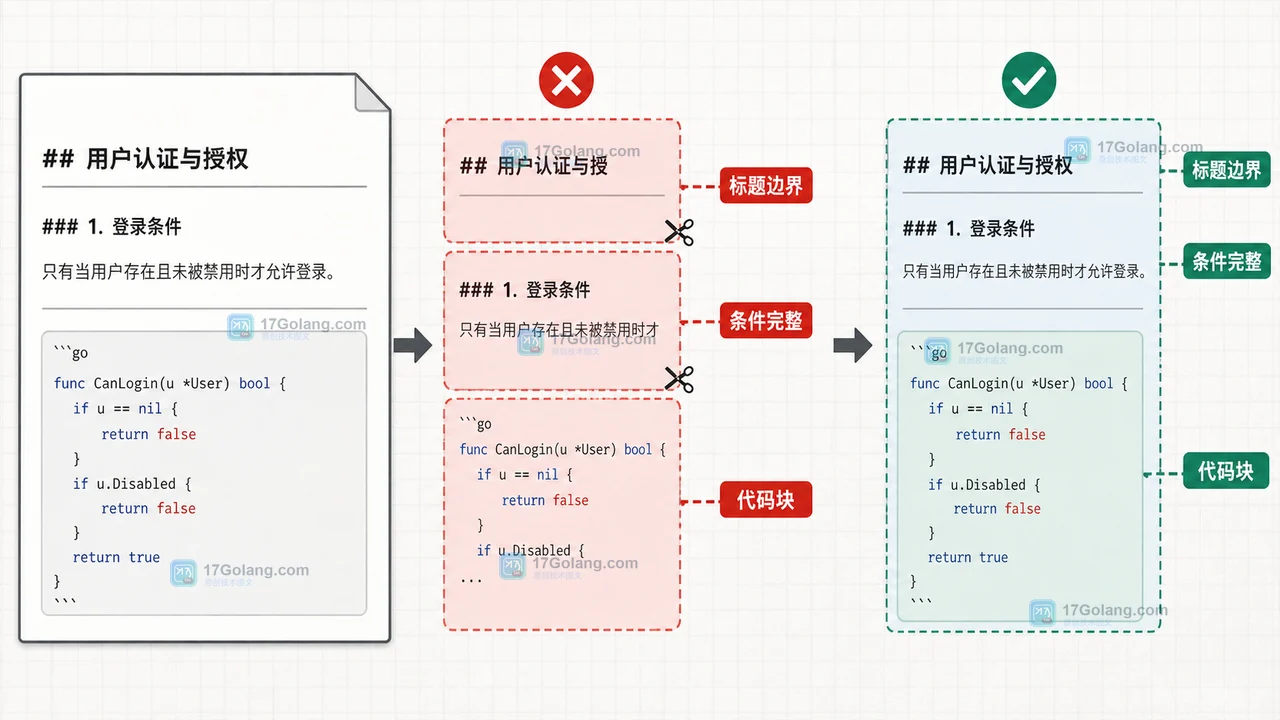 RAG 知识库的切片不是越短越好。本文用一份带标题和代码块的技术文档说明切片长度、重叠窗口与语义边界如何共同影响召回证据,并给出可复现的调参流程、检查指标和常见误区。170 收藏
-
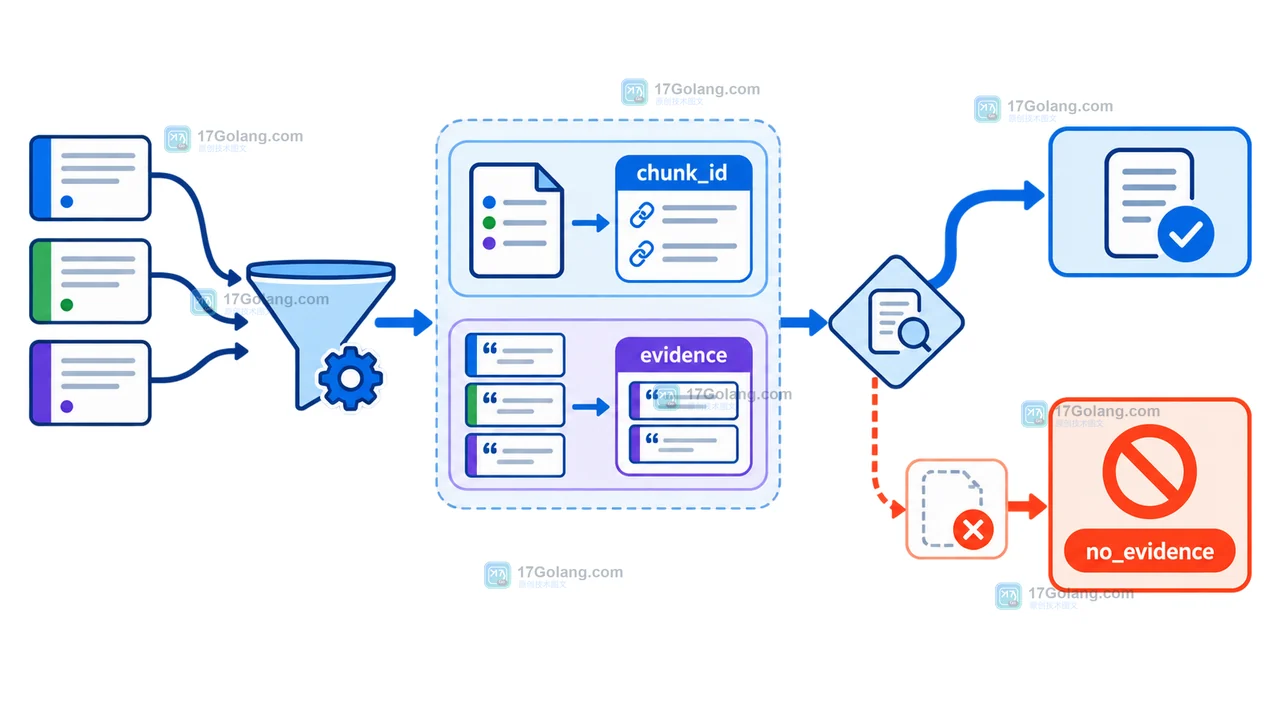 RAG 流程里,检索命中不等于可以直接交给模型。本文用来源分层、上下文拼接、引用保留和空结果分支,搭出一条可核对、可回退的回答链路。170 收藏
-
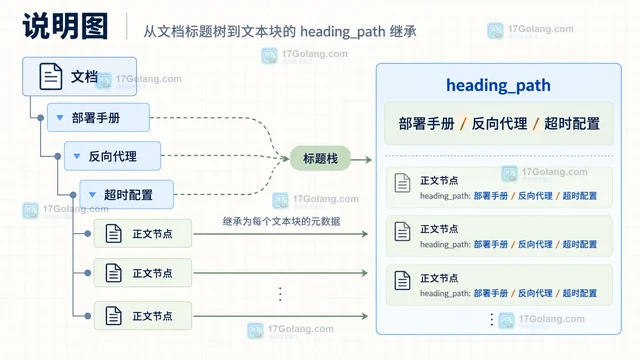 长文档做RAG时,先解析标题树并把标题路径、来源位置和版本写入chunk metadata,再按语义边界切分和重建上下文,减少检索片段丢失章节语境的问题。170 收藏
-
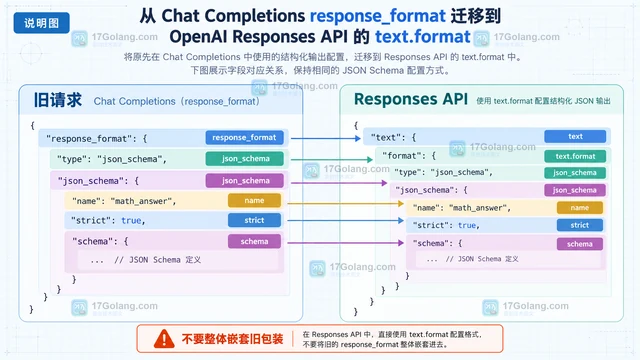 Responses API 的结构化输出要放在 text.format 中,用 json_schema 和 strict:true 约束 JSON 形状。本文从 Chat Completions 迁移差异、Schema 设计、JavaScript 调用和拒答/不完整响应处理四个方面整理可执行写法。168 收藏
-
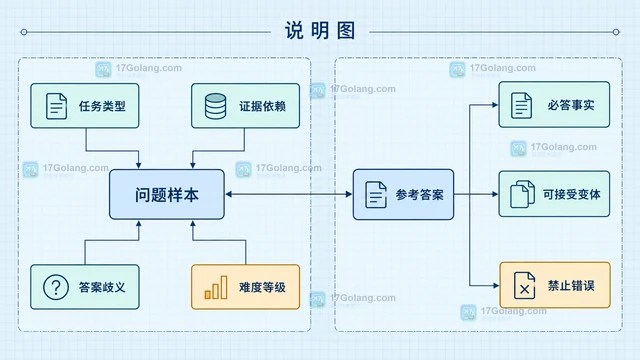 生成式问答评测集不应只保留一个总分。本文从样本标签、参考答案和指标三处说明如何把简单题、边界题与高难题分开统计,保留旧分数的同时增加难例回归信号,让模型版本变化更容易解释。167 收藏
-
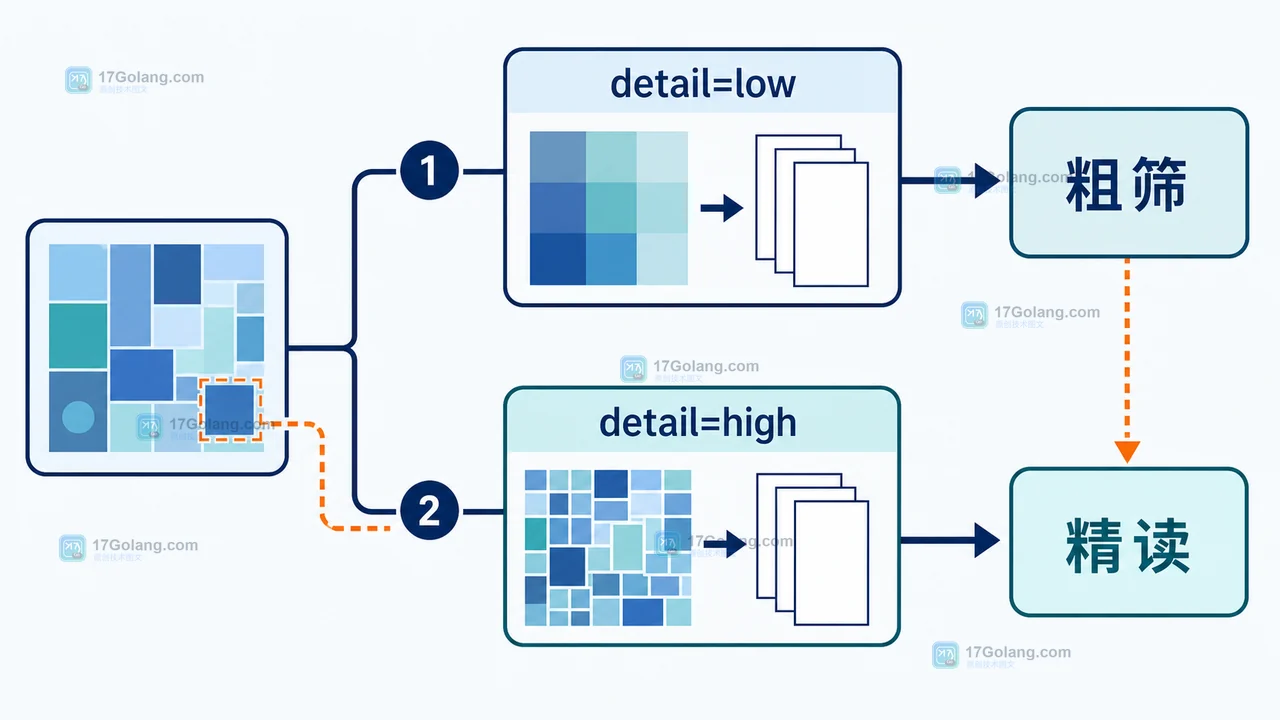 多模态接口的图片费用不只取决于文件大小,真正影响预算的是输入分辨率、detail 级别、图片数量和重试策略。本文用一个可复用的请求预算表,说明什么时候使用 low、high 或 auto,并给出上线前的核对方法。165 收藏
-
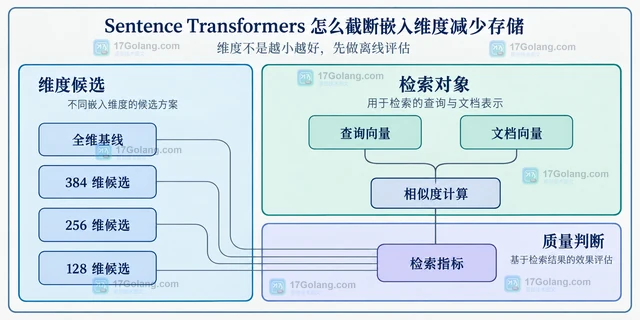 本文介绍如何用 Sentence Transformers 的 truncate_dim 与 truncate_embeddings 缩短嵌入向量,计算理论存储节省,并通过离线检索指标选择维度,说明 Matryoshka 模型、归一化、索引迁移和推理性能的边界。165 收藏
-
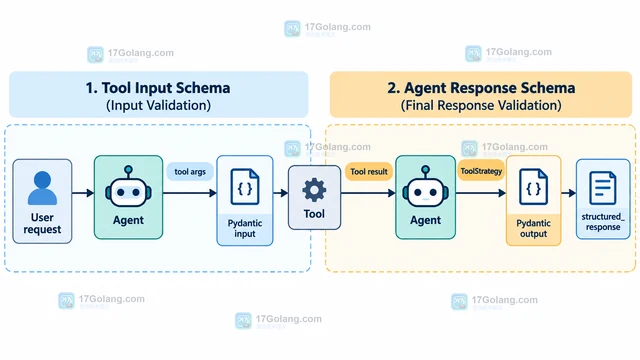 LangChain 的工具参数 schema 和 agent 最终 structured_response 不是同一个边界。本文用 Pydantic 与 ToolStrategy 固定返回结构,并说明 handle_errors、工具组合和 provider-native 输出的适用条件。165 收藏
-
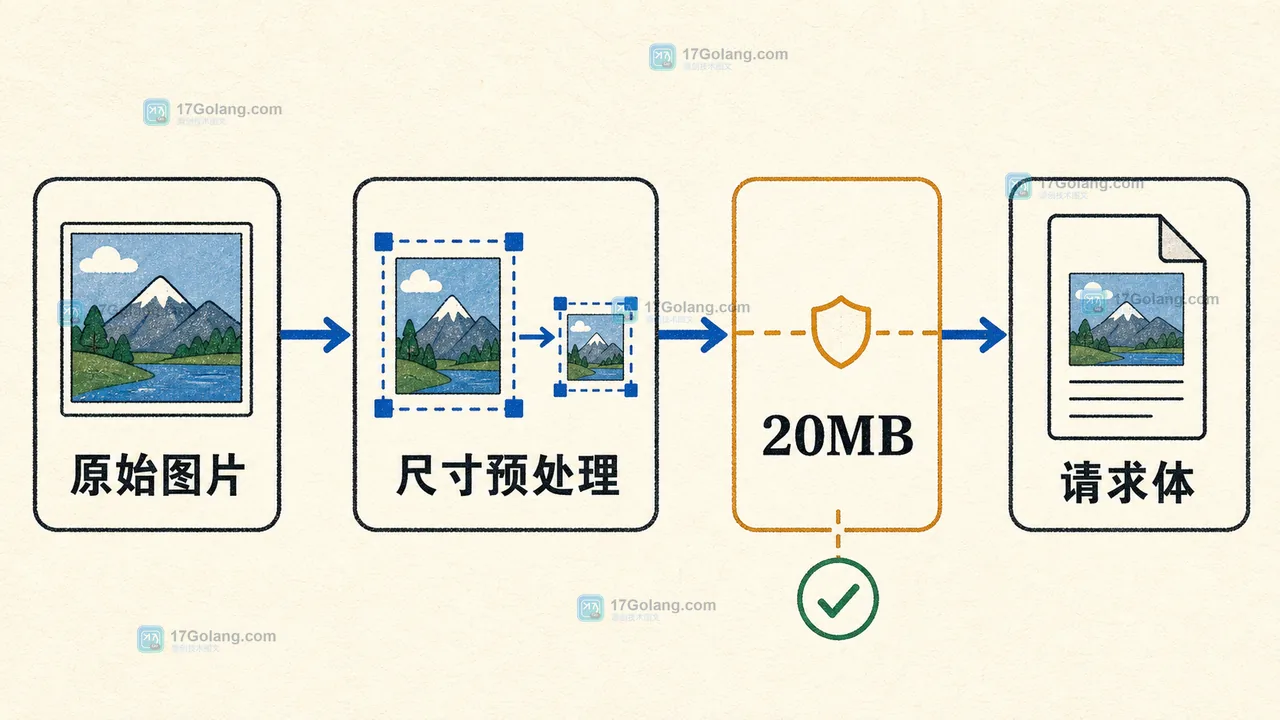 多模态请求总超时通常不是单一网络问题:图片尺寸、编码体积、视觉分辨率和重试策略会共同放大耗时。本文用一条可观测链路拆解预处理、请求超时、重试边界和最终降级。164 收藏
-
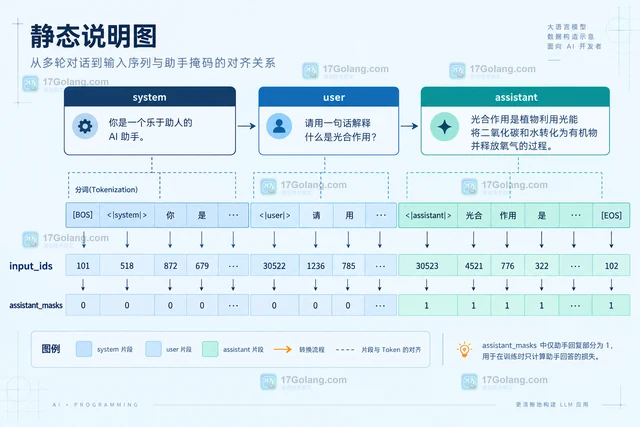 Transformers 的 apply_chat_template 可以通过 generation 块记录 assistant 内容,并返回与 input_ids 对齐的 assistant_masks。本文说明参数组合、模板写法、训练标签转换和全零掩码排查边界。164 收藏
-
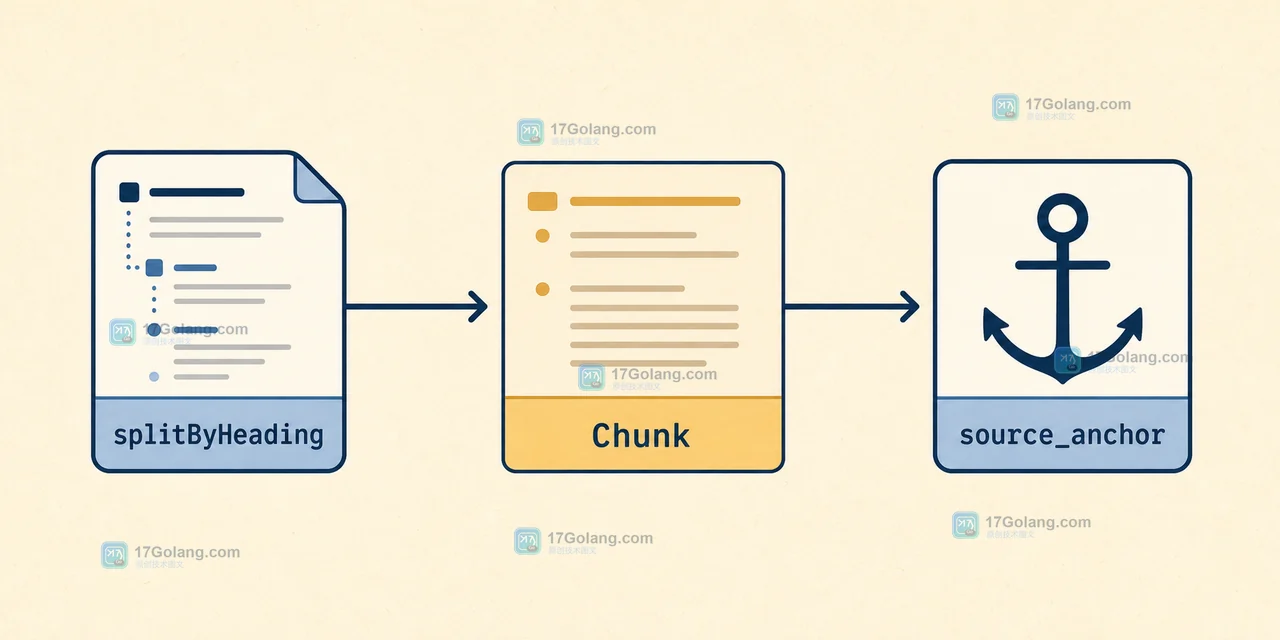 RAG 系统如果只保存一段孤立文本,回答命中后很难解释它来自文档哪里。本文用 Go 设计带标题路径、页码和片段编号的 Chunk,演示切片、检索上下文和引用回链如何连成一条可复查的数据路径。163 收藏
-
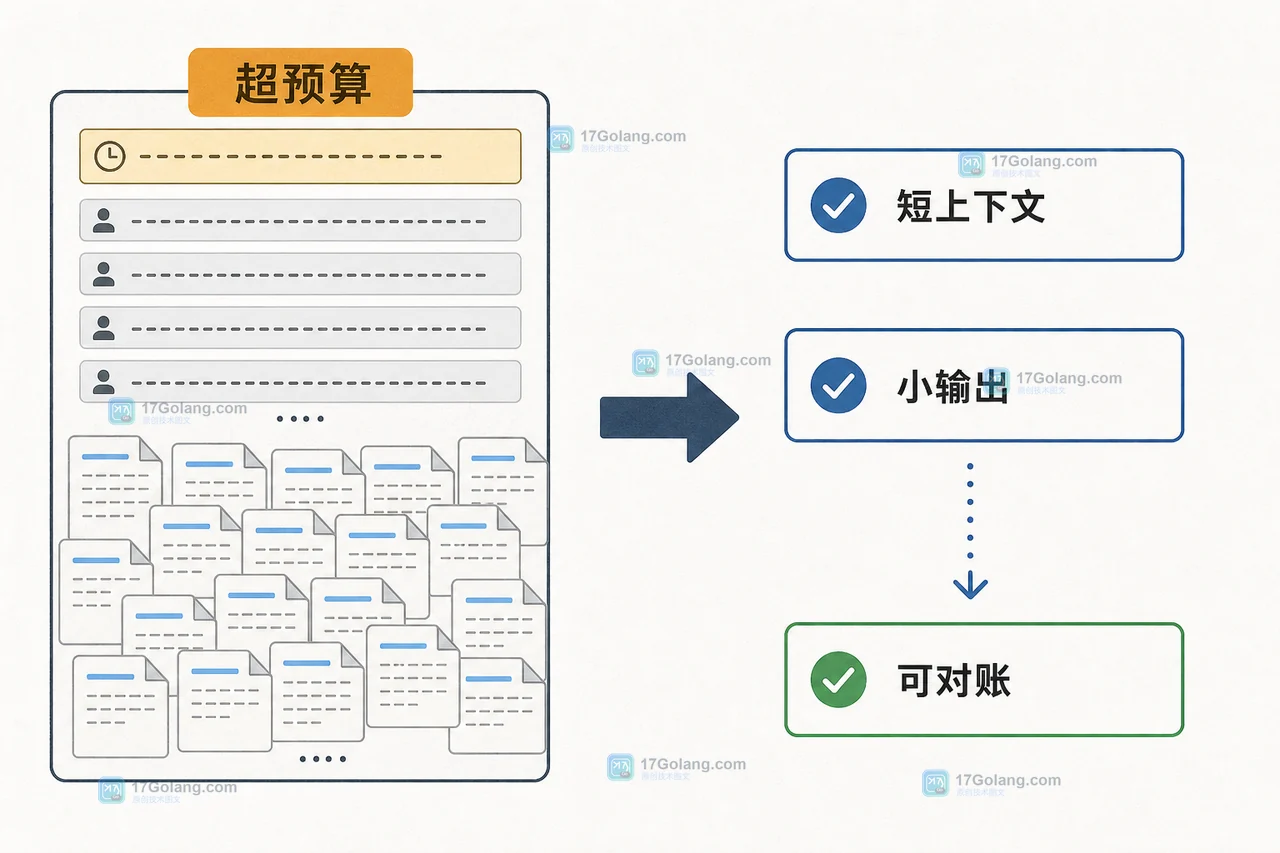 AI 应用上线后,成本失控通常不是因为某一次请求特别贵,而是输入上下文、输出长度和重试叠加后没有预算边界。本文用一个请求预算器拆解 token 估算、费用计算、阈值判断和超额降级,并给出可验收的 Go 示例。162 收藏
-
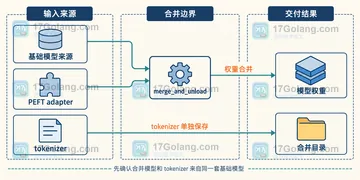 LoRA 合并只处理 adapter 权重,不会自动替你保存正确的 tokenizer。本文用一套可复用的核对脚本检查词表、特殊 token、长度配置和嵌入尺寸,避免合并模型上线后出现输入映射不一致。162 收藏