
人工智能技术文章
-
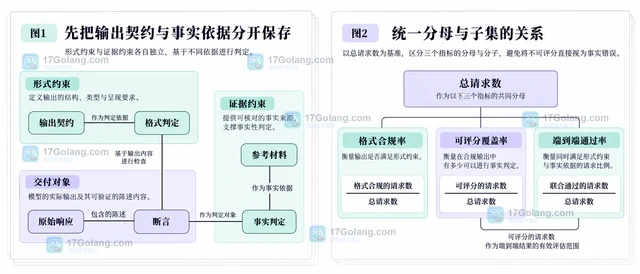 AI评估应分别记录事实依据与格式合规。本文用同一组示例说明断言支持、字段约束、不可评分项及报告分母,避免用格式正确代替事实正确。119 收藏
-
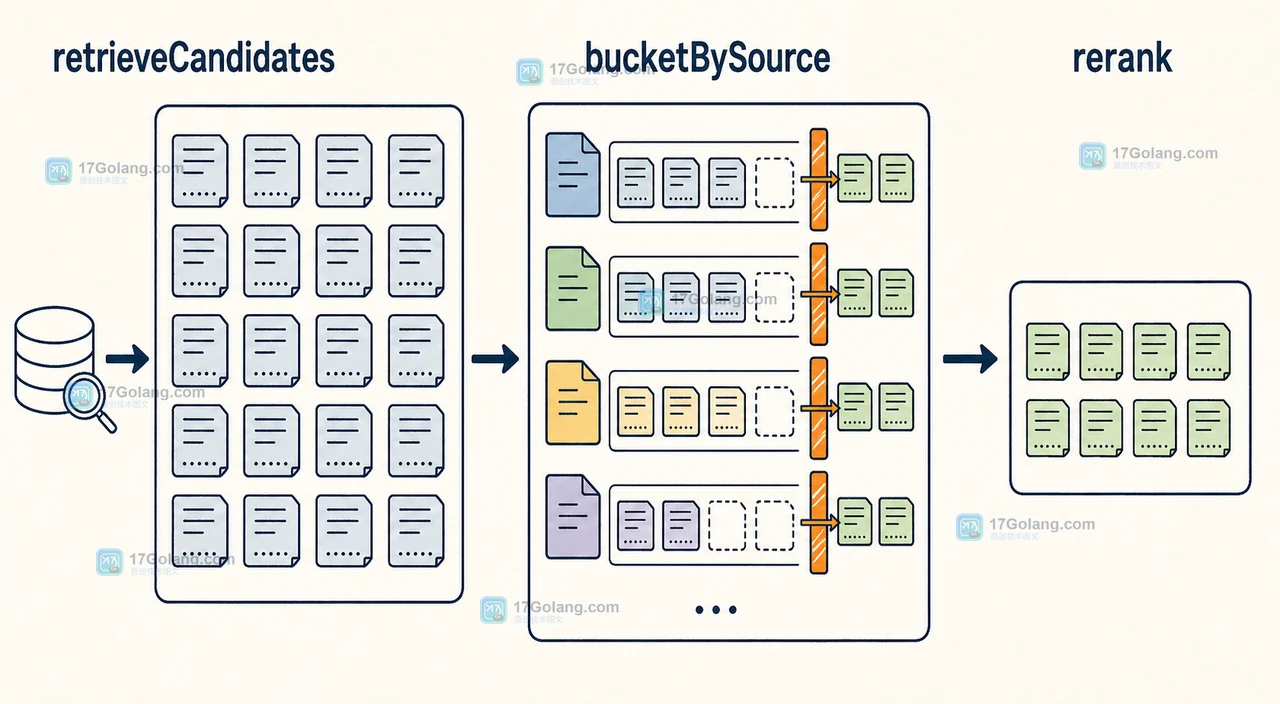 长文切片容易在 RAG 召回中占满候选集。本文用 Go 演示按来源分桶、限制每桶配额,再把候选交给 rerank,最后按 token 预算组装上下文,并给出可复查的召回指标。118 收藏
-
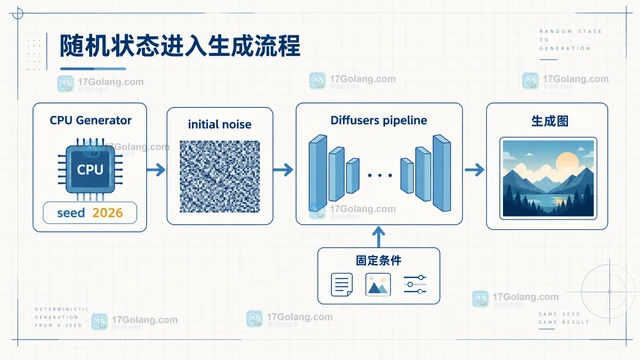 Diffusers 生成结果每次不同,通常与随机状态和采样条件有关。本文用 CPU torch.Generator 说明怎样固定初始噪声、每次重新播种,并整理模型、提示词、步数和调度器的复现清单。118 收藏
-
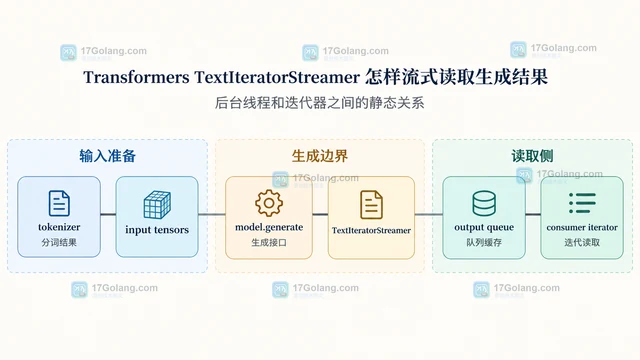 Transformers 的 chat template 不是装饰性格式,而是模型训练时使用的控制 token 约定。本文只围绕 apply_chat_template,说明 role/content 消息结构、推理与训练参数、特殊 token 重复和不同模型模板不兼容时的处理方式。118 收藏
-
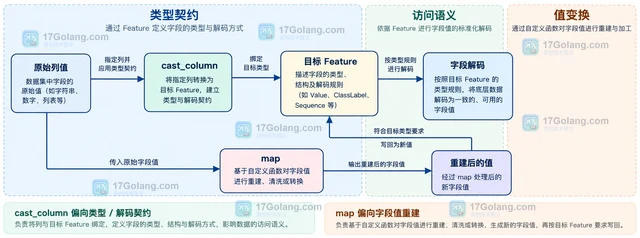 本文围绕 Hugging Face Datasets 的 cast_column,说明如何查看 features、把列映射到目标 Feature,以及何时应该改用 map 重建字段值。118 收藏
-
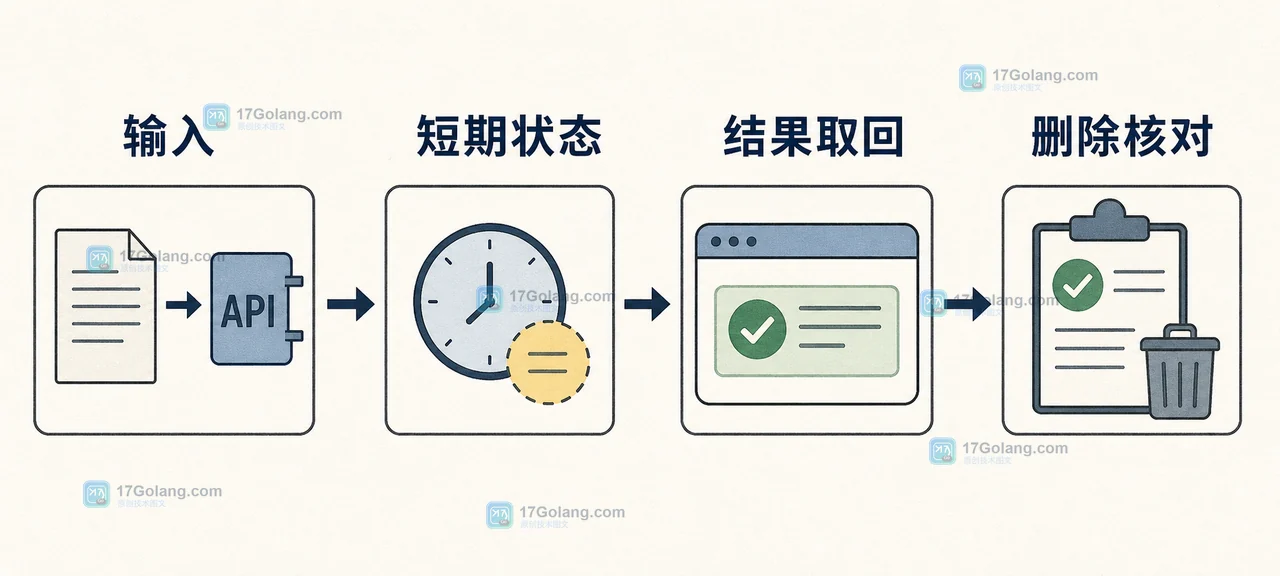 AI API 上线评审不能只看请求是否成功,还要画清输入、平台短期状态、回调结果和删除动作。本文用一个后台响应场景拆解客户数据与短期保留的边界,给出可落地的合规核对清单。115 收藏
-
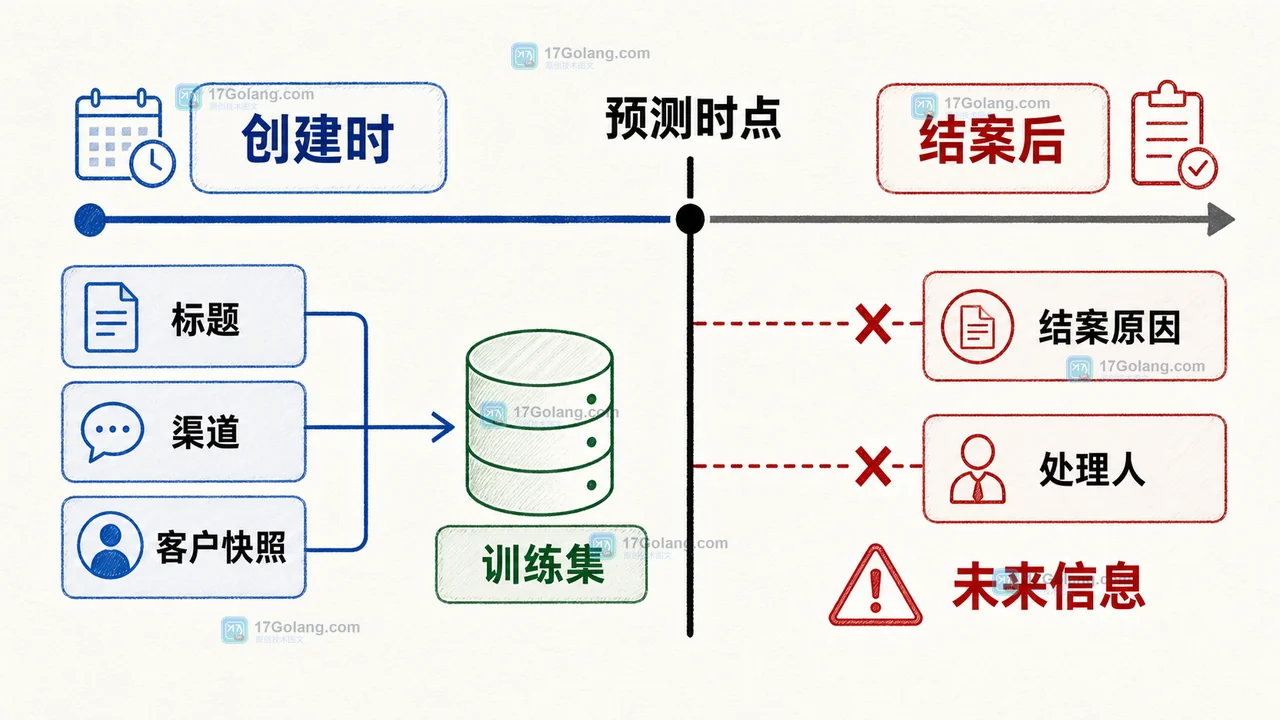 评测分数异常好,未必代表模型真的可靠。训练集、验证集和测试集之间的重复样本、未来字段和错误的预处理顺序,都会造成数据泄漏。本文以带时间的客服工单分类为例,给出切分、去重、特征时间点和最终验收的检查方法。115 收藏
-
 LLM评测不要把事实错误和表达偏差混成一个总分。本文给出分层标签、证据字段、分项统计和复核一致性的可复用设计。115 收藏
-
 语音转写与说话人分离遇到重叠发言时,不要按片段顺序抢词或直接删掉重叠区;应保留普通 diarization,再用词级时间交集决定归属,无法判断的结果进入 ambiguous 复核。115 收藏
-
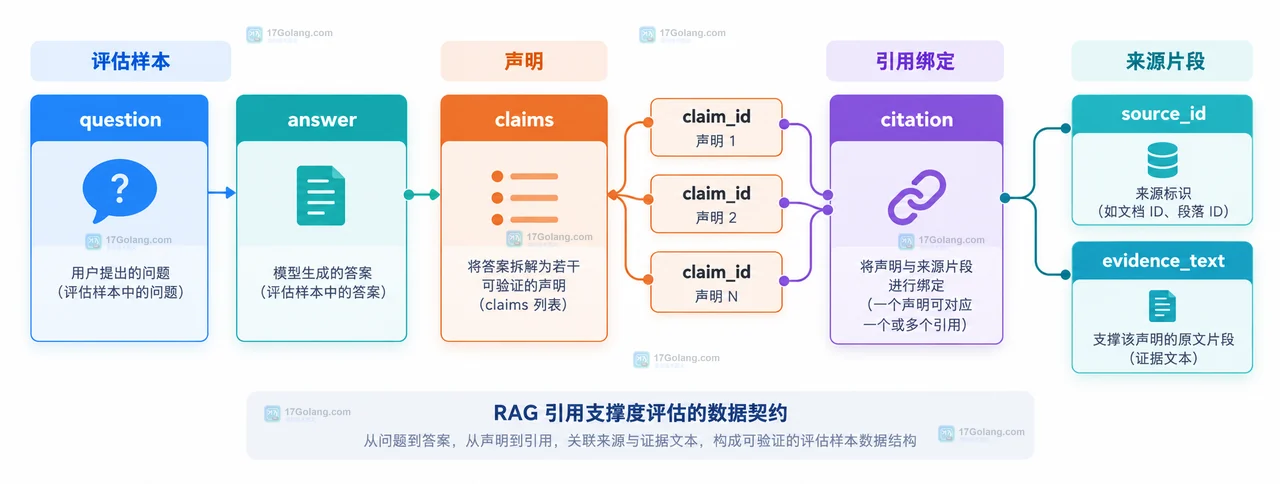 用 Hugging Face 风格的评估数据组织方式,拆解 RAG 引用支撑度的字段契约、覆盖检查、语义判定和分层排障方法。115 收藏
-
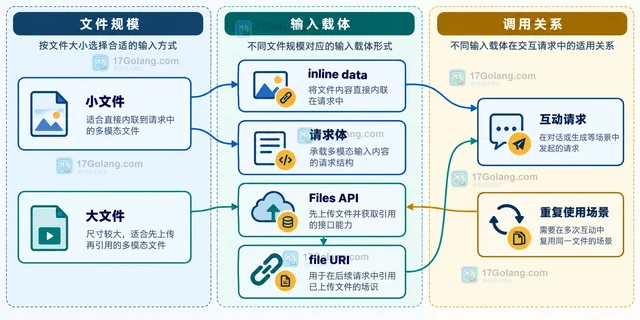 处理图片、音频、视频和 PDF 时,先把文件转换成可信的 MIME 类型,再映射到 image、audio、video 或 document 内容对象;小文件单次调用可用内联数据,较大或需要复用的文件应使用 Files API。本文用一套路由层说明输入对象、PDF 边界和文件 URI 的选择。114 收藏
-
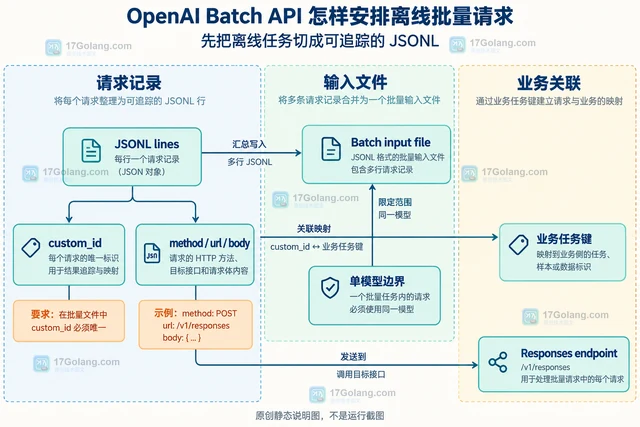 OpenAI Batch API 适合不要求即时返回的批量任务。本文用 JSONL、Files API 和 Python SDK 说明如何创建 24 小时批次,按 custom_id 回填结果,并处理 failed、expired、文件大小和单模型边界。114 收藏
-
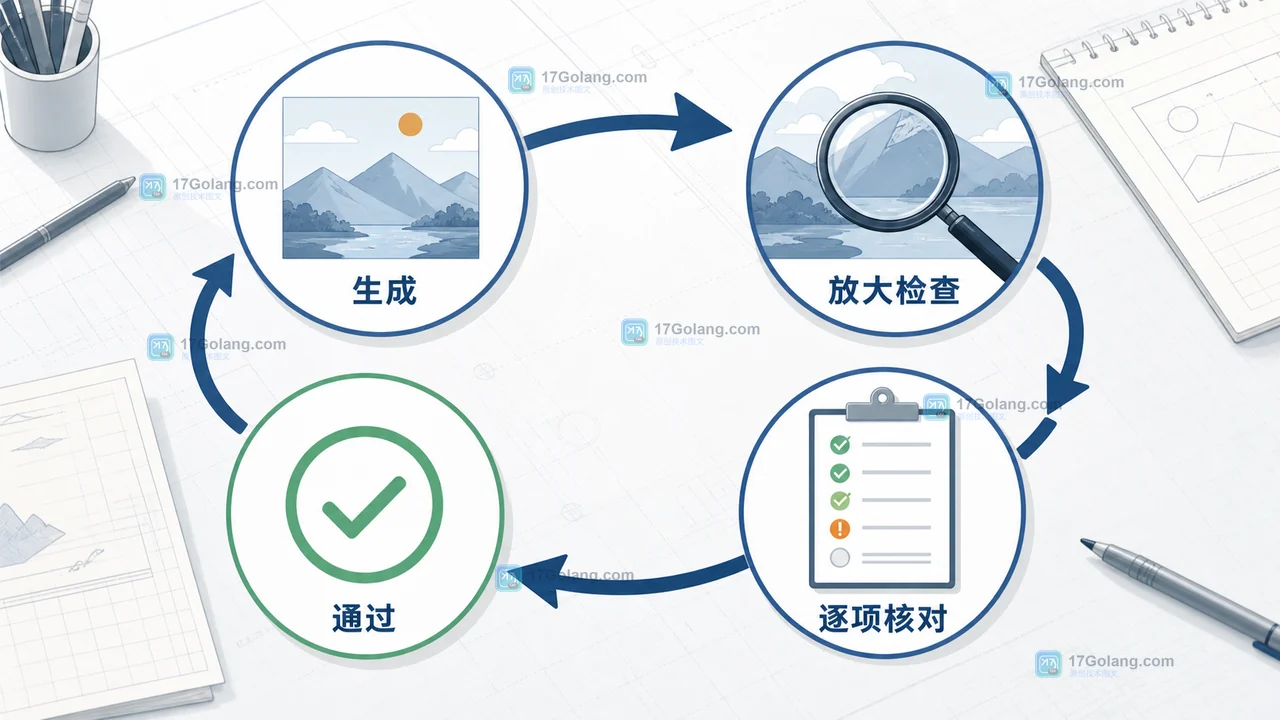 AI 图片里出现多余文字,通常不是把否定词堆得更多就能解决。本文从画面目的、文字约束、分步修改和交付验收四个环节,给出一套可复用的排查方法。113 收藏
-
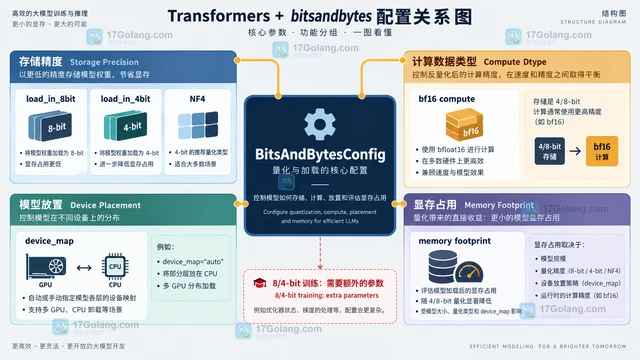 Transformers 量化配置选择的关键不只是显存大小,还要看推理、QLoRA 微调、精度容忍度和硬件后端。本文用 BitsAndBytesConfig 对比 int8 与 int4 的适用边界,并给出检查清单。113 收藏
-
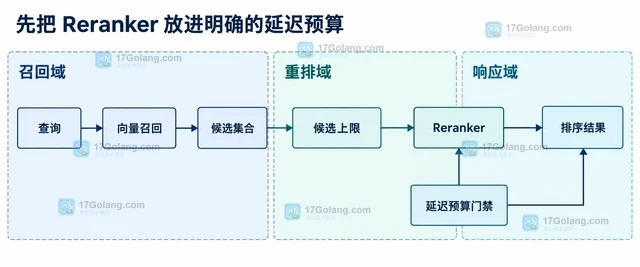 Reranker 通常只应处理召回后的有限候选。本文从延迟预算、候选规模、输入长度、批量和超时降级几个方面,给出一套可落地的检索重排控制方案。113 收藏