
人工智能技术文章
-
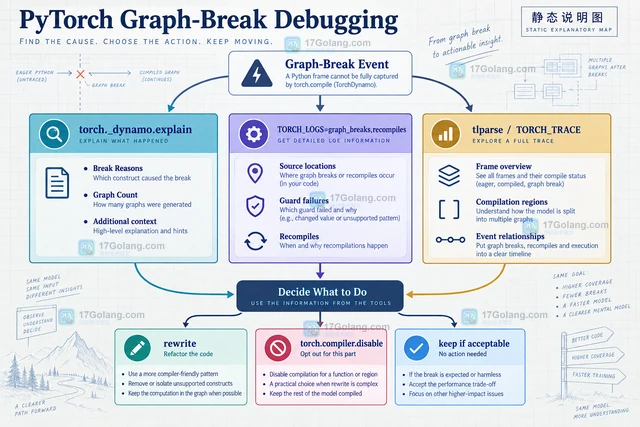 torch.compile 出现 graph break 时,先用 fullgraph=True 暴露首个断点,再用 torch._dynamo.explain 和 TORCH_LOGS 分析原因,最后决定重写、隔离还是保留。478 收藏
-
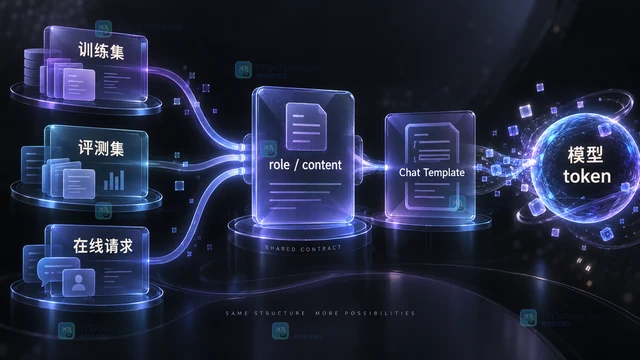 避免 Chat Template 角色格式不一致的关键,是让训练、评测和推理共享同一份 role/content 消息契约,并统一交给 tokenizer.apply_chat_template 序列化。本文给出参数区别、重复特殊 token 的规避方法和集中封装示例。477 收藏
-
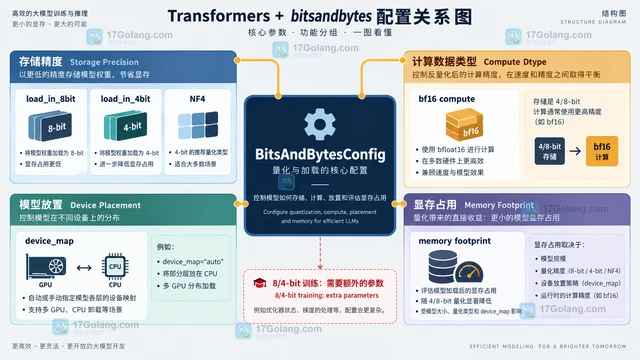 Transformers 量化配置选择的关键不只是显存大小,还要看推理、QLoRA 微调、精度容忍度和硬件后端。本文用 BitsAndBytesConfig 对比 int8 与 int4 的适用边界,并给出检查清单。113 收藏
-
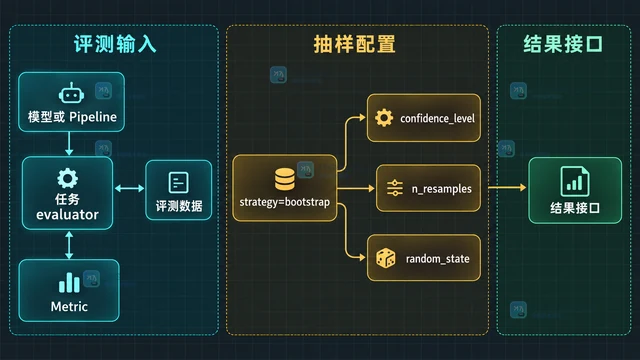 介绍 Hugging Face Evaluate 使用 bootstrap 策略计算指标置信区间的方法,解释 confidence_level、n_resamples、random_state 以及结果中的标准误。438 收藏
-
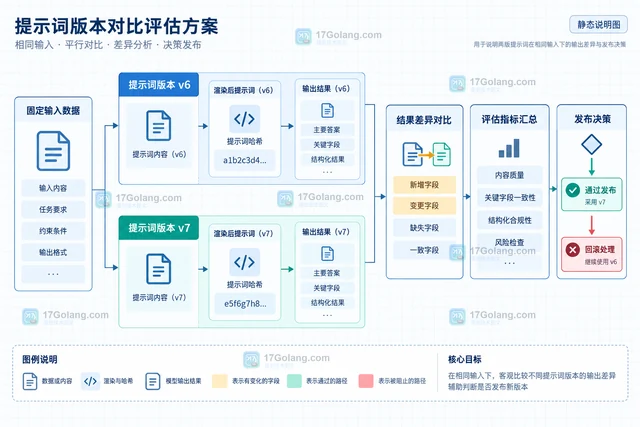 Prompt 变化不能只靠复制文本和人工回忆。本文用模板、变量、模型配置、输入集和输出指标五类记录,搭建可重放、可比较、可回滚的版本流程。412 收藏
-
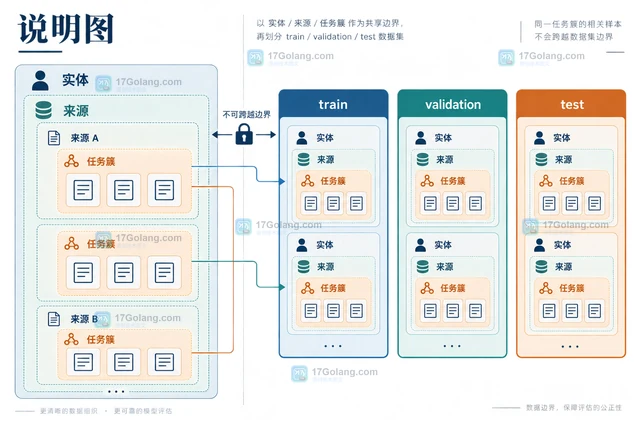 按实体和来源拆分训练、验证和测试,使用稳定的任务簇键避免评测集泄漏,让模型指标更接近真实泛化能力。233 收藏
-
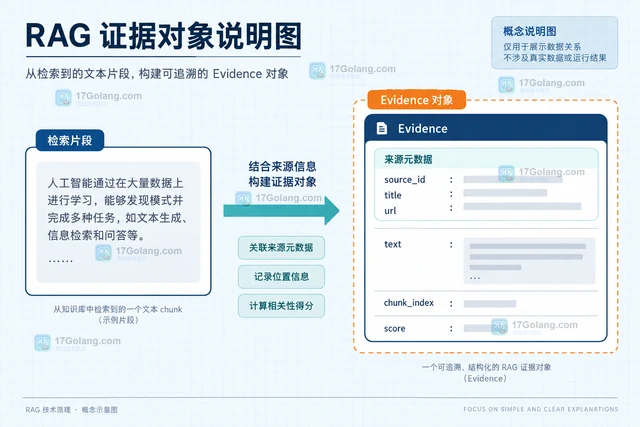 RAG 应用不要只返回一串链接。本文用 source_id、答案段落和引用集合建立可校验的对齐关系,并给出无证据、多来源冲突与前端展示的处理方式。354 收藏
-
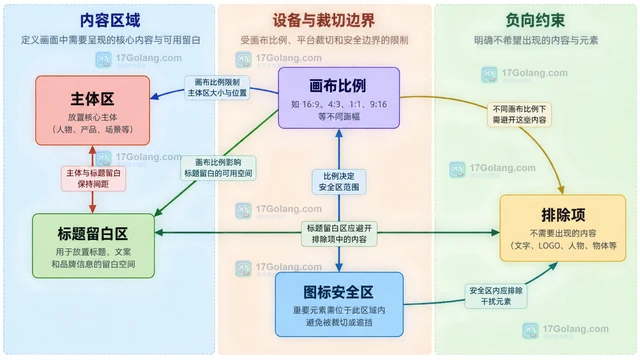 图像生成提示词不要只堆风格词。本文把任务目标、主体、位置、留白、画幅和排除项拆成可复用结构,说明如何让生成结果更贴近文章配图、海报或手机画布的版式要求。394 收藏
-
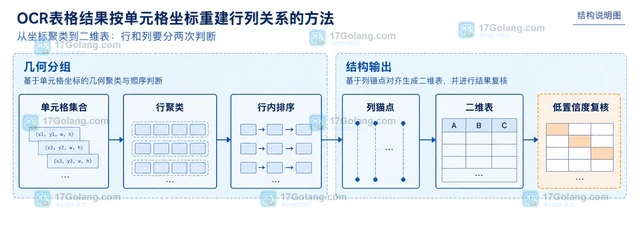 OCR 通常先返回文本、坐标和置信度,不会直接给出可用的二维表。通过统一坐标、按垂直重叠聚类行、按横坐标排序并推断列锚点,可以重建表格关系,同时保留低置信度单元格供复核。385 收藏
-
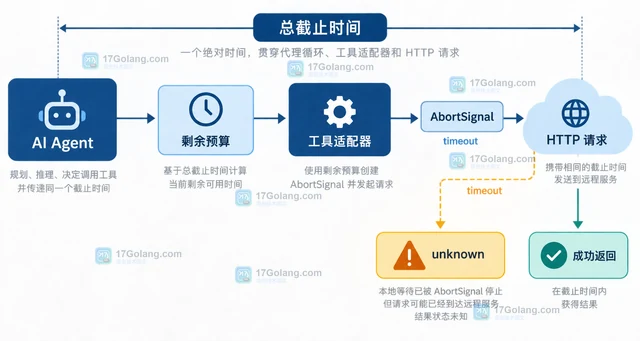 AI Agent 调用外部工具时,超时只解决等待上限,幂等键才解决重复副作用。本文用统一 deadline、幂等账本和结果分类,给出可落地的调用边界与排查清单。305 收藏
-
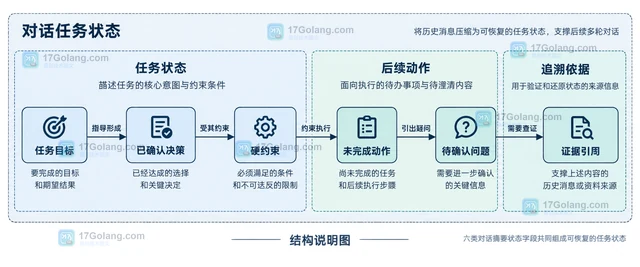 多轮对话压缩不能只追求文本变短。本文用任务目标、已确认决策、硬约束、未完成动作、待确认问题和证据引用六类字段设计提示模板,并说明如何组合状态摘要与最近原文,减少上下文丢失和任务返工。278 收藏
-
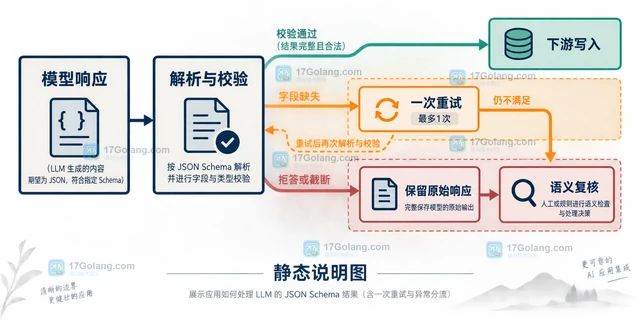 LLM输出能解析不代表字段完整。本文从JSON Schema最小契约、响应状态归一化、字段缺失有限重试和上线观测四个方面,给出结构化输出的处理方案。364 收藏
-
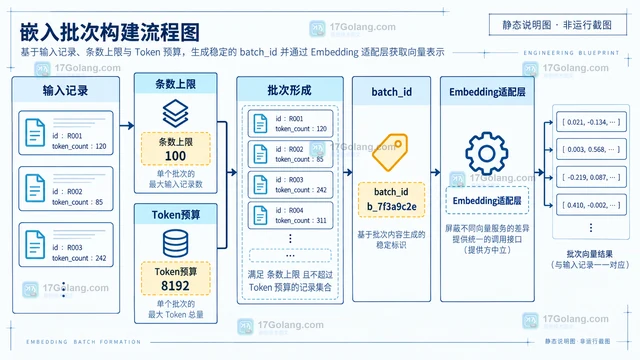 从批次边界、吞吐控制、错误分流和幂等写入四个层面,说明 Embedding 批量生成如何稳定处理长文本、429、超时和进程重启。387 收藏
-
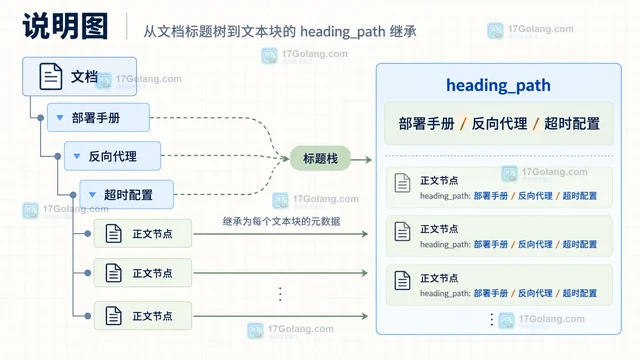 长文档做RAG时,先解析标题树并把标题路径、来源位置和版本写入chunk metadata,再按语义边界切分和重建上下文,减少检索片段丢失章节语境的问题。170 收藏
-
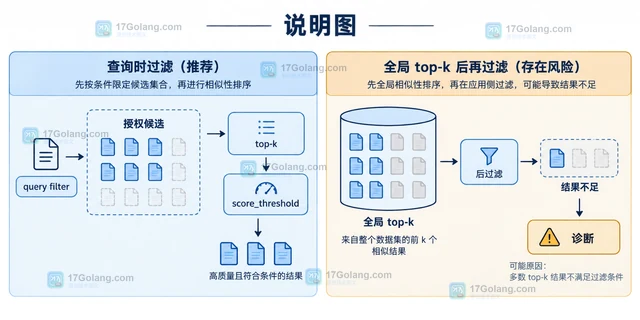 向量检索不要等拿到 top-k 后才做租户和权限判断。本文用 Qdrant payload filter 说明如何把元数据过滤放进召回边界,并处理索引、相似度阈值、空结果和隔离验收。183 收藏