-
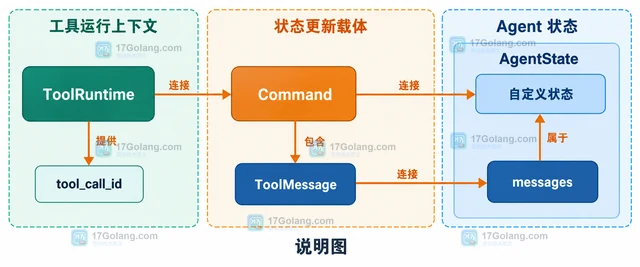
LangChain 的工具调用不是把返回值自动塞进任意列表,而是要用 AIMessage 中的调用记录和匹配的 ToolMessage 组成连续消息历史;工具还需要改状态时,再通过 Command 同时写回 messages 和自定义状态。
-
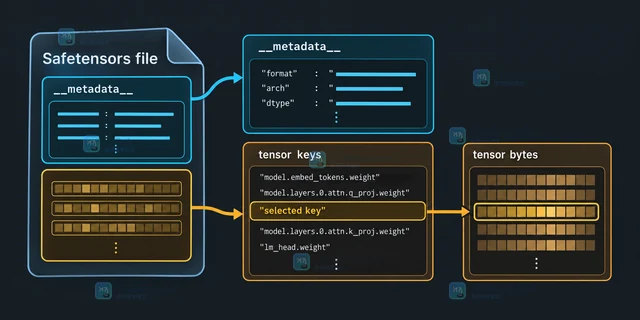
Safetensors 文件可以先通过 safe_open 查看权重键和文件级元数据,再按目标键读取单个张量。本文说明 get_tensor、get_slice、metadata 的分工,并处理缺键、空元数据和分片模型边界。
-
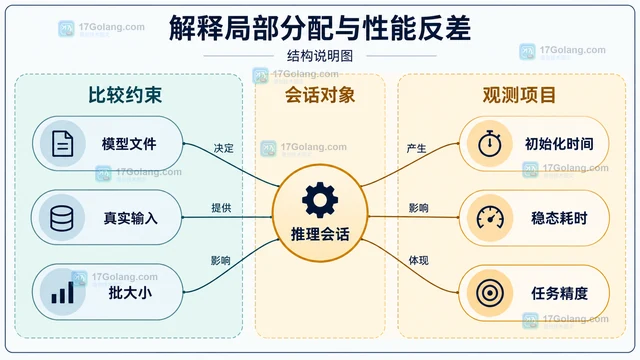
ONNX Runtime 的执行提供者应结合硬件、依赖、算子覆盖与模型形状选择。本文说明 CUDA、TensorRT、OpenVINO、DirectML 和 CoreML 的候选范围,提供注册顺序与性能比较示例,区分可用、注册和实际分配。
-
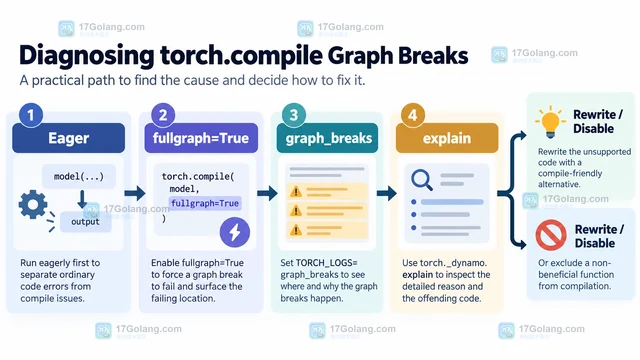
torch.compile 变慢或日志出现多个 FX 图时,先用 eager 基线排除代码错误,再用 fullgraph=True、TORCH_LOGS=graph_breaks 和 torch._dynamo.explain 定位断点。本文按值班手册给出改写、隔离和回退路径。
-
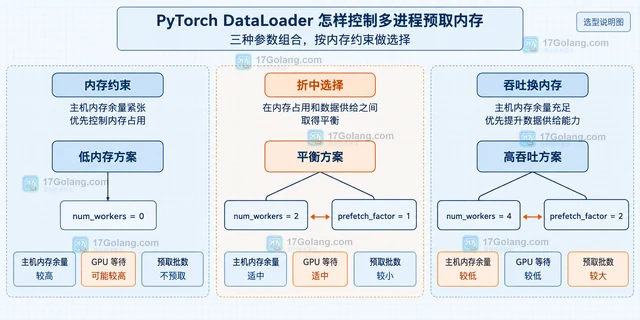
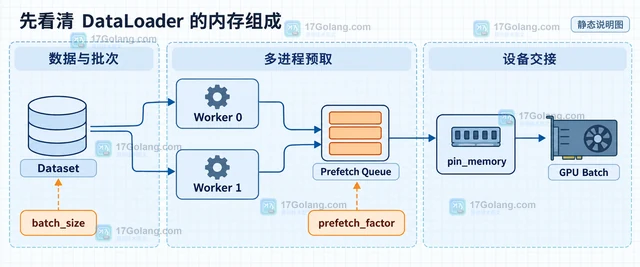
PyTorch DataLoader 的多进程内存主要受单批大小、num_workers 和 prefetch_factor 共同影响。本文用预取批次数估算主机侧占用,并比较低内存、平衡吞吐和高吞吐配置,同时说明 pin_memory、persistent_workers 与 IterableDataset 的边界。
-
OpenAI Realtime API 断线后不会替应用自动恢复业务上下文,稳定做法是把连接与会话状态分开保存,重连后重新配置 session,再按确认点重放摘要和未确认输入,最后只对完整的新输入触发 response.create。
-
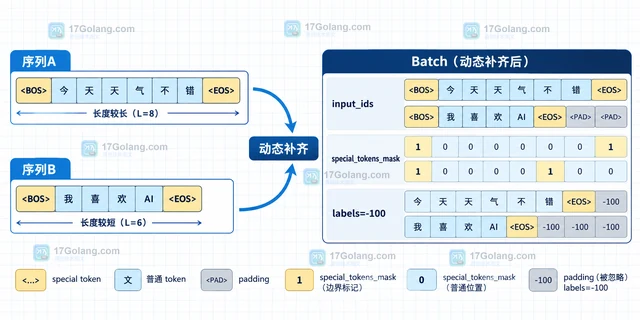
用 DataCollatorForLanguageModeling 组织语言模型训练批次,掌握 mlm、mlm_probability、padding 与 labels=-100 的对应关系。
-
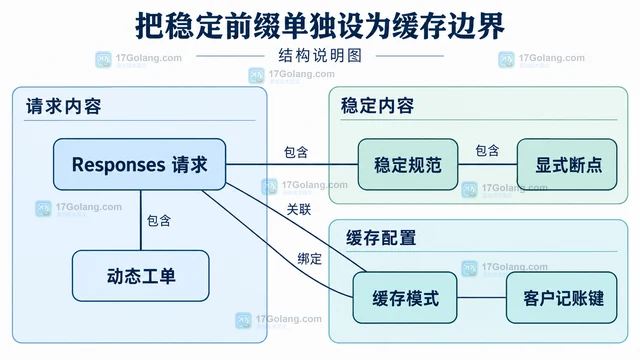
OpenAI API 提示词缓存需要稳定前缀与适用模型配置。通过显式缓存边界、读取和写入用量记录及完整请求组算例,判断重复输入是否真正降费,并区分旧模型参数。
-
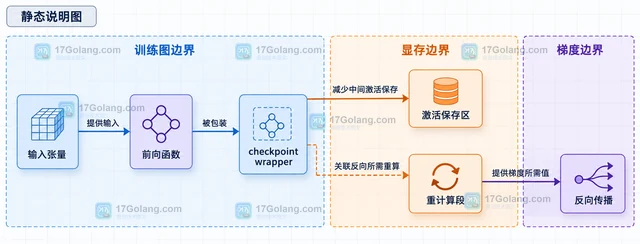
PyTorch activation checkpointing 用减少前向激活保存、反向阶段重计算来换取训练显存。本文围绕 torch.utils.checkpoint、use_reentrant=False、随机状态和 early_stop,说明适用边界与生产检查要点。
-
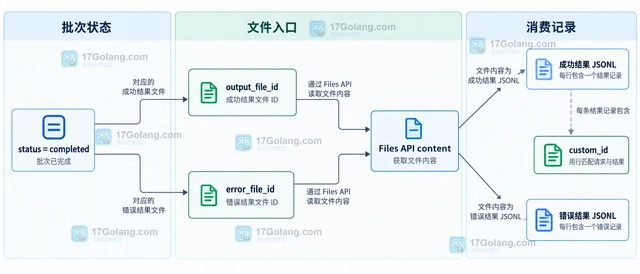
OpenAI Batch API 的 output_expires_after 怎样设置?本文说明 created_at 锚点、seconds 的合法范围,以及如何区分批次完成窗口、输出文件和错误文件的读取时机。
-
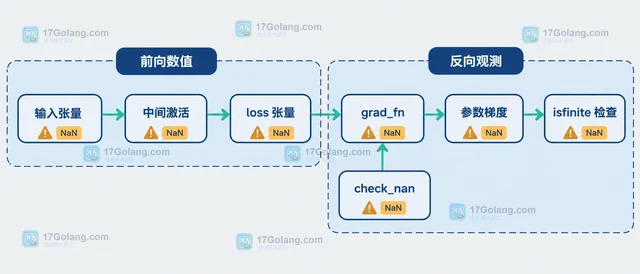
训练在 loss.backward() 阶段出现 NaN 或 Inf 梯度时,可以用 PyTorch autograd anomaly detection 保存前向 traceback,并结合 check_nan、isfinite 和梯度检查把范围收窄到具体算子与输入。
-
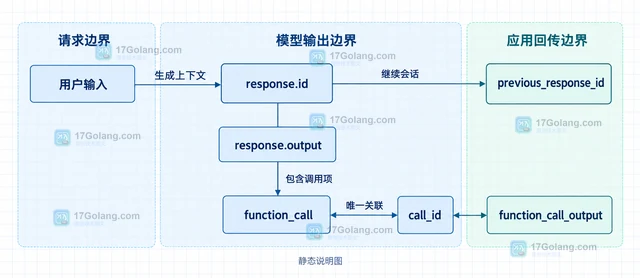
Responses API 的 tool call 不是把一段文本塞回对话,而是用 response.output、function_call、call_id 与 function_call_output 维持调用关联。本文从安全边界、回传控制和审计记录说明状态怎样串联。
-
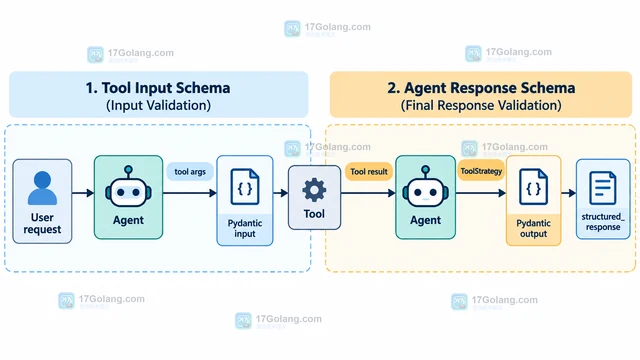
LangChain 的工具参数 schema 和 agent 最终 structured_response 不是同一个边界。本文用 Pydantic 与 ToolStrategy 固定返回结构,并说明 handle_errors、工具组合和 provider-native 输出的适用条件。
-
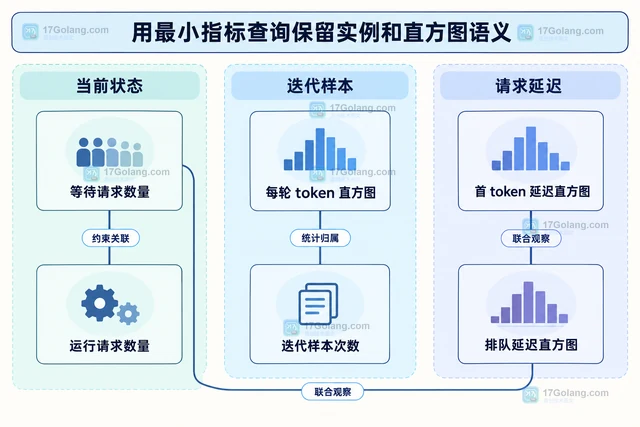
观察 vLLM continuous batching 时,将等待队列、运行请求、每轮 token、KV 缓存和延迟分开统计,说明旧指标迁移、PromQL 查询口径及调度参数的取舍。
-
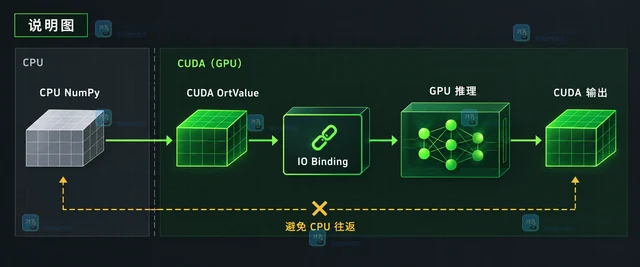
说明 ONNX Runtime Python 推理中 IO Binding 的设备驻留方式:用 CUDA OrtValue 绑定输入、在 GPU 上绑定或分配输出,并判断何时应该回传 CPU。
