-
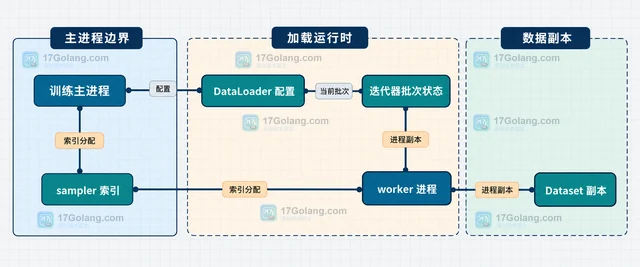
本文说明 PyTorch DataLoader 的 persistent_workers 如何影响 worker 进程、迭代器和 Dataset 副本的生命周期,给出跨 epoch 复用的最小配置,并说明内存、状态管理、IterableDataset 分片和调试边界。
-
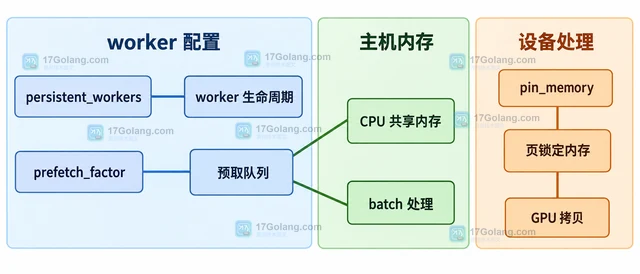
PyTorch DataLoader 的多进程预取会同时受到 num_workers、prefetch_factor 和 batch_size 影响。本文给出按共享内存预算限制预取批次的配置方法,并区分 worker 生命周期、pin_memory 与真实内存瓶颈。
-
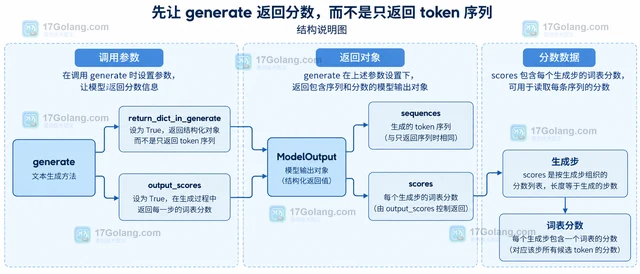
Transformers generate 默认主要返回生成序列。本文说明如何打开 return_dict_in_generate 与 output_scores,使用 compute_transition_scores 对齐每个生成 token 的分数,并区分 decoder-only、encoder-decoder 与 beam search 的边界。
-
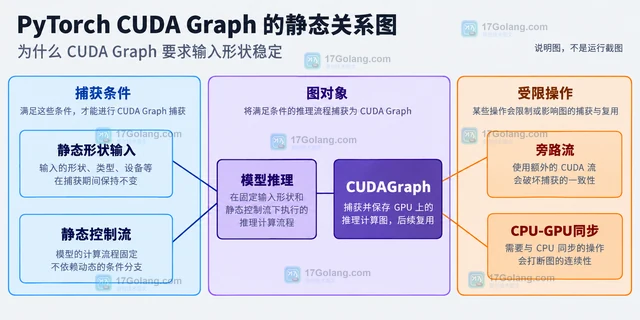
PyTorch CUDA Graph 适合重复执行、输入形状稳定且 CPU 调度开销明显的推理路径。本文用静态输入、旁路流预热、捕获和 replay 说明怎样固定形状复用流程,以及变长请求应该怎样分桶或回退。
-
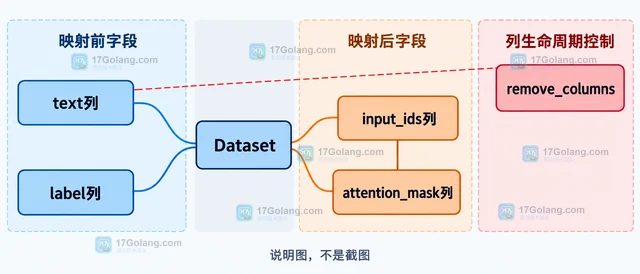
Hugging Face Datasets 的 map 在 batched=True 时按列传入一批样本。本文用一个可复用的 Python 示例说明怎样新增处理列、保留原始列,并用 remove_columns 控制最终字段。
-
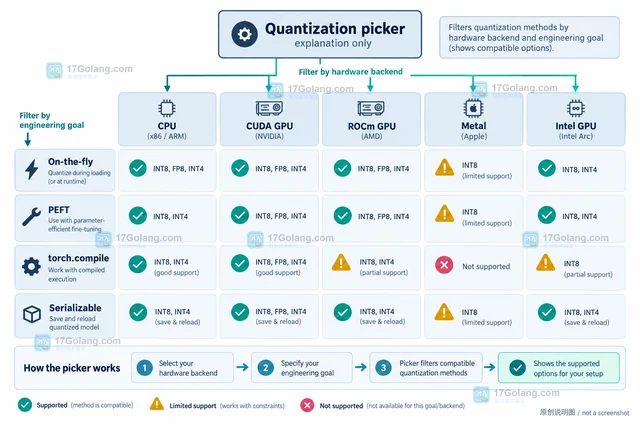
Transformers quantization picker 不是按 4-bit 或 8-bit 盲选,而是结合硬件后端、显存、KV cache、在线量化、PEFT 和编译目标筛出可行方法。本文给出一套按硬件落地的选择步骤与最小验证代码。
-
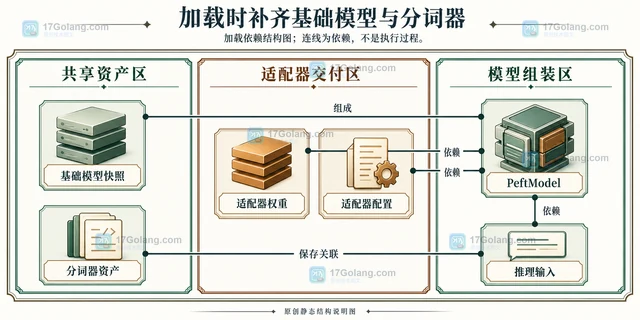
通过 PeftModel.save_pretrained 导出 LoRA 适配器,说明额外训练模块、嵌入层、基础模型依赖与训练断点的区别,并提供参数体积推算和文件统计写法。
-
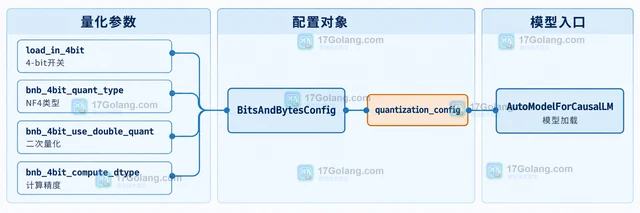
QLoRA 配置中,NF4 决定 4-bit 权重的数据类型,double quant 对量化常量再次量化,compute dtype 决定计算时使用的精度。本文用 BitsAndBytesConfig 给出一份适合 4-bit 训练的配置,并说明显存、训练和推理场景下的取舍。
