
人工智能技术文章
-
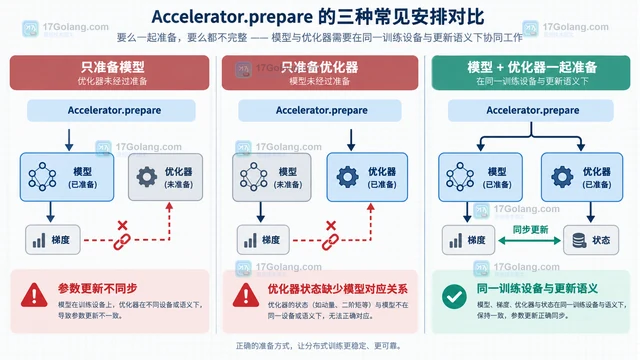 Accelerator.prepare 不只是把模型搬到设备上;训练时模型包装、参数位置、优化器参数组和状态必须保持一致,所以通常要把模型与优化器一起交给 Accelerate 准备。本文用最小训练骨架说明对象顺序、调度器和推理场景的边界。386 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · Hugging Face Datasets streaming IterableDataset Dataset.shuffle shuffle buffer
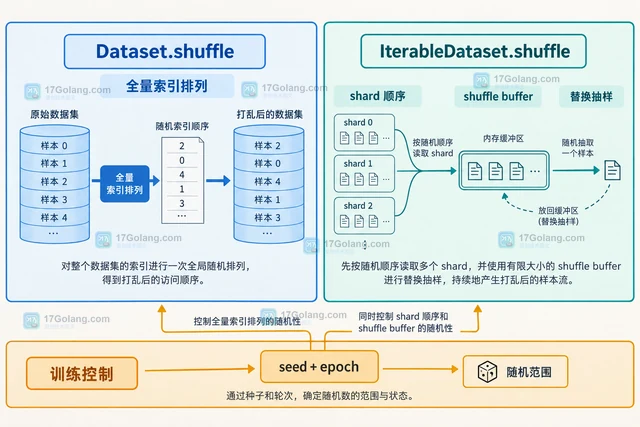 Hugging Face Datasets 的 Dataset.shuffle 会为内存数据集建立全量索引映射,IterableDataset.shuffle 则通过 shard 顺序和有限 shuffle buffer 做近似随机。本文解释两者的访问模型、随机范围、性能代价与训练参数选择。130 收藏
-
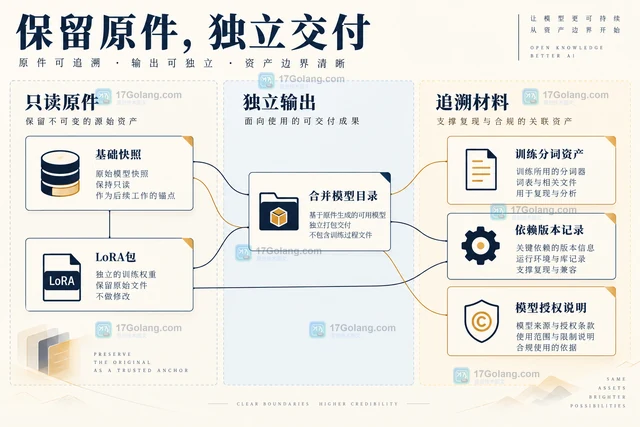 从文件职责、配置来源和参数命名区分LoRA适配器与基础模型,说明单适配器合并的适用范围、独立输出目录及回滚材料,避免把适配器误当完整模型交付。174 收藏
-
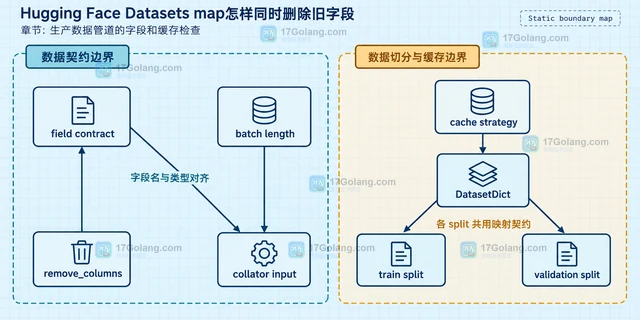 Hugging Face Datasets 用 map 转换样本时,可以通过 remove_columns 一次删除多个旧字段。本文说明单条与批量映射、同名覆盖、DatasetDict 和缓存边界。421 收藏
-
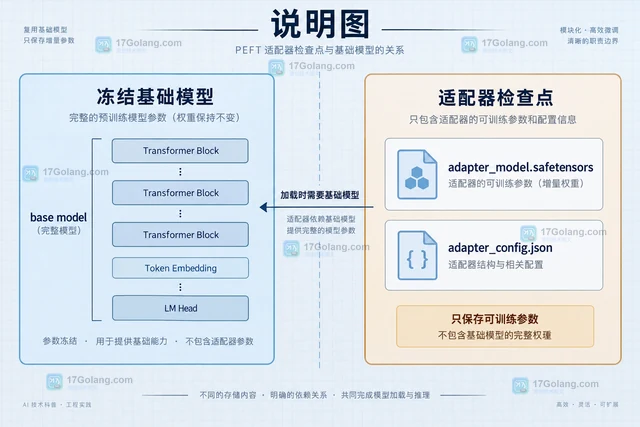 使用 Hugging Face PEFT 训练适配器后,检查点通常只包含适配器权重和配置,不会复制完整基础模型。本文从目录现象出发,说明保存设计、恢复加载、继续训练与合并导出的区别。301 收藏
-
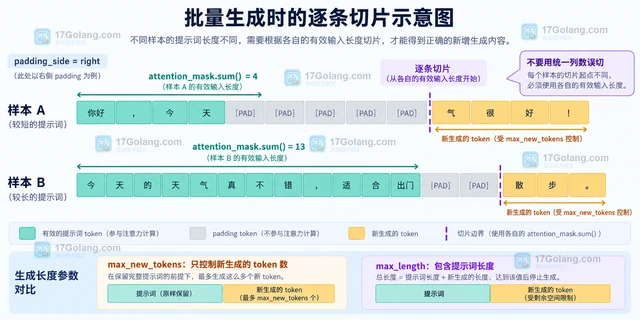 Transformers 的 generate 返回完整序列时,GPT 类 decoder-only 模型会把输入提示词和新增 token 一起返回。本文用 token 长度切片、批量 padding 和 max_new_tokens 说明如何稳定取出真正生成的文本。111 收藏
-
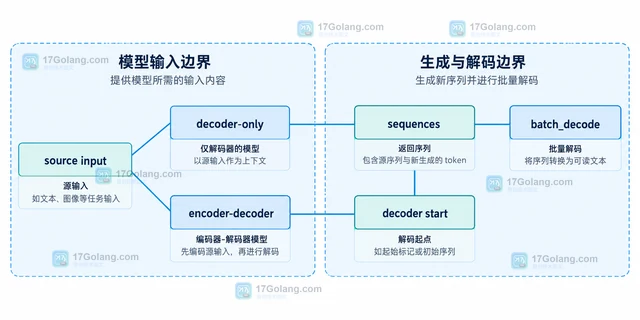 讲清 Transformers generate 返回完整序列的原因,分别处理 decoder-only 与 encoder-decoder 模型,用输入长度切出新生成 token,并给出批量解码、特殊 token 和空结果的处理方式。461 收藏
-
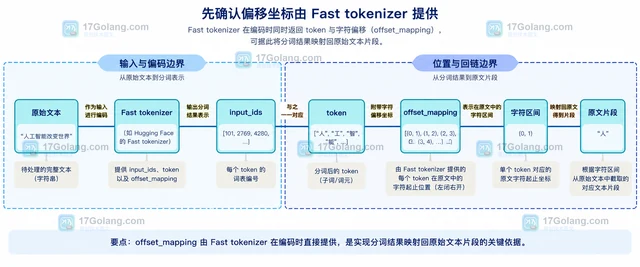 使用 Transformers Fast tokenizer 的 offset_mapping 把 token 位置还原为原始文本片段,并处理特殊 token、批量溢出、成对输入与预分词边界。330 收藏
-
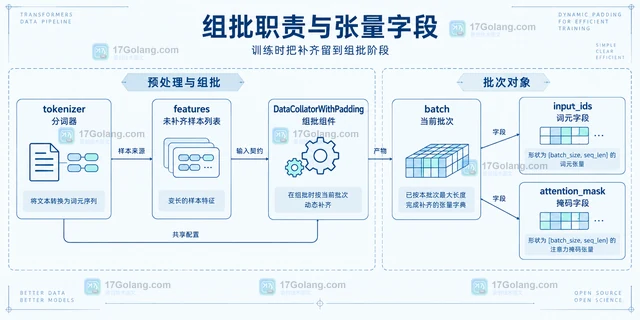 比较Transformers批次分词的动态补齐与固定长度补齐,说明截断上限、collator组批职责和部署形状约束,并给出可复制代码与实际观测指标。153 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · Transformers DataCollatorForSeq2Seq label_pad_token_id loss mask seq2seq
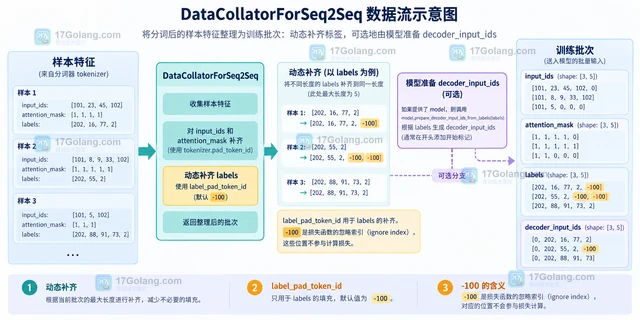
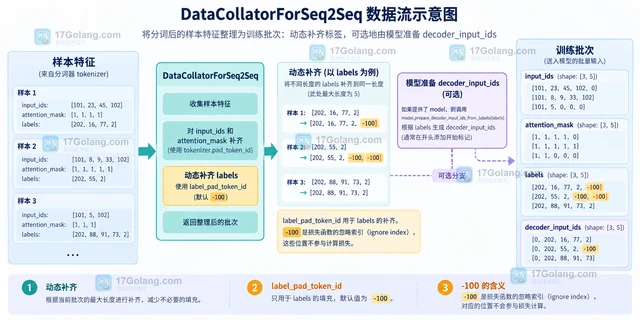 训练翻译或摘要模型时,DataCollatorForSeq2Seq 的 label_pad_token_id 会决定补齐标签是否进入 loss。本文从 -100 的忽略语义、动态补齐和 decoder_input_ids 准备三条链路拆开排查。176 收藏
-
 围绕 Hugging Face Datasets 的 map(batched=True) 讲清返回列长度契约、remove_columns 的作用和最小诊断方法,帮助定位预处理函数中的扩行与错配问题。213 收藏
-
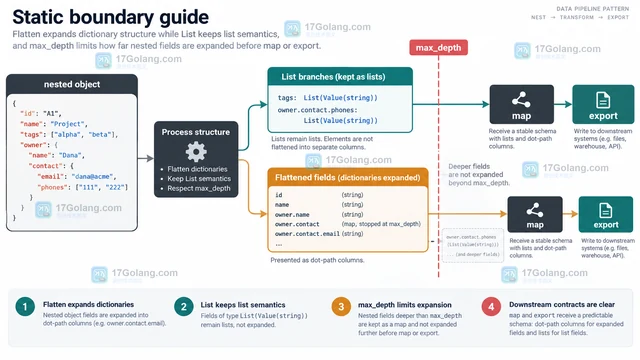 Hugging Face Datasets 的 flatten 会把嵌套字典字段展开为点号路径列,同时保留 Features 对字段类型的描述。本文用嵌套 struct、List 和 max_depth 说明如何安全接入后续 map 处理。455 收藏
-
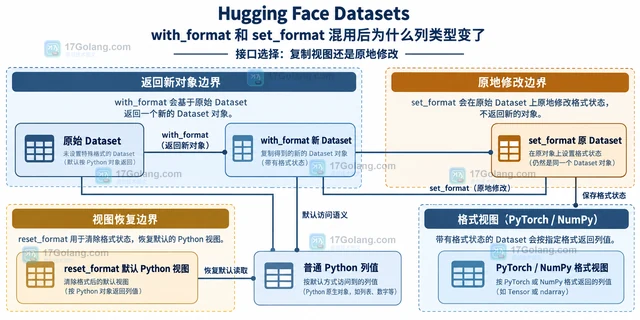 Hugging Face Datasets 的列定义没有因为 with_format 或 set_format 自动改变;真正变化的是 __getitem__ 的读取视图。本文拆解两者的返回新对象与原地修改差异,并给出恢复默认格式和隔离训练视图的写法。228 收藏
-
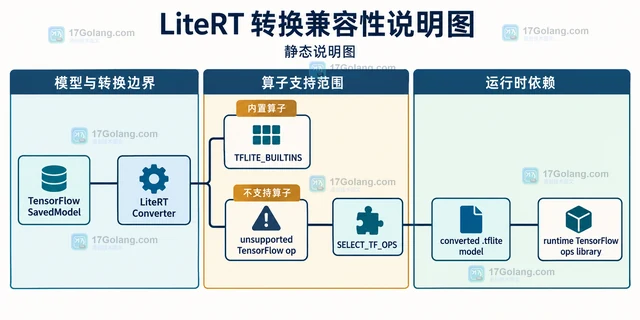 LiteRT 转换遇到不支持算子时,不是看到报错就直接打开 Select TF Ops。本文从转换器错误边界、模型体积、目标平台运行时依赖和验收清单四个方面,说明什么时候启用、什么时候优先替换算子。226 收藏
-
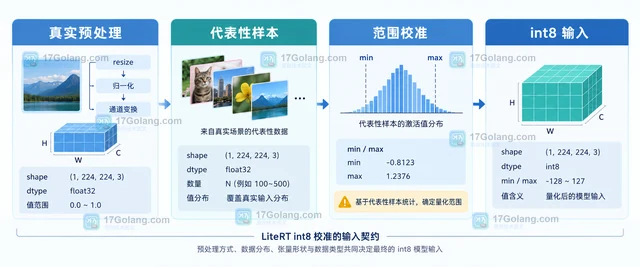 LiteRT int8 量化结果异常时,先检查代表性数据集是否复用了真实推理的预处理、shape、dtype 和数值分布。本文按输入契约拆解多输入签名、校准范围与样本覆盖的排查方法。348 收藏