
人工智能技术文章
-
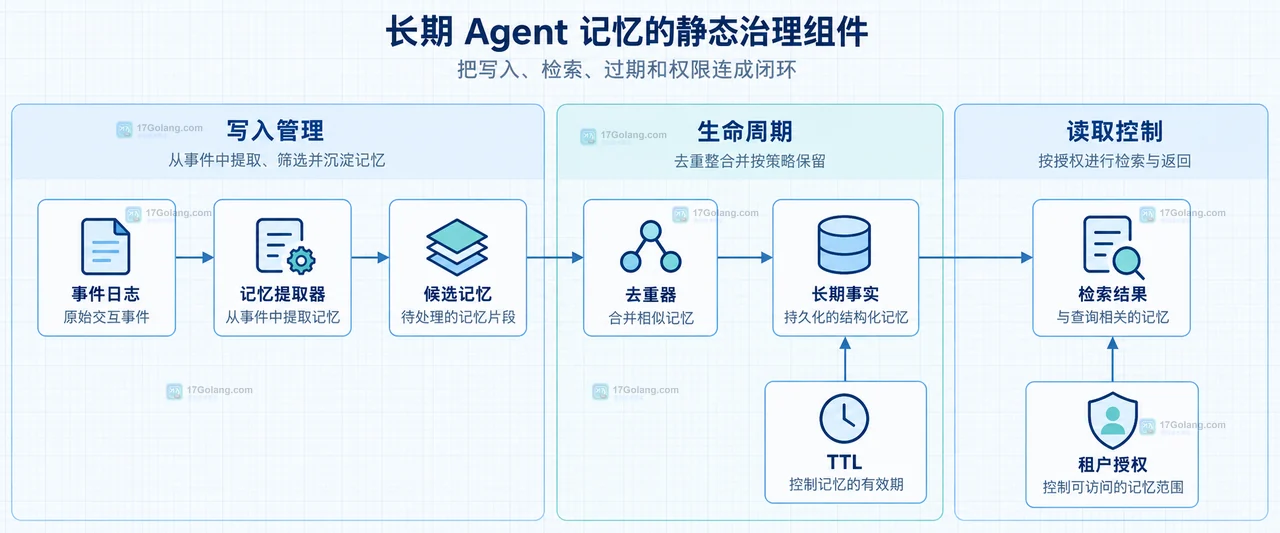 AI Agent 的短期上下文负责当前线程,长期存储负责跨会话复用。本文从边界、数据类型、写入检索和权限保留四个方面给出一套可落地的记忆设计方法。155 收藏
-
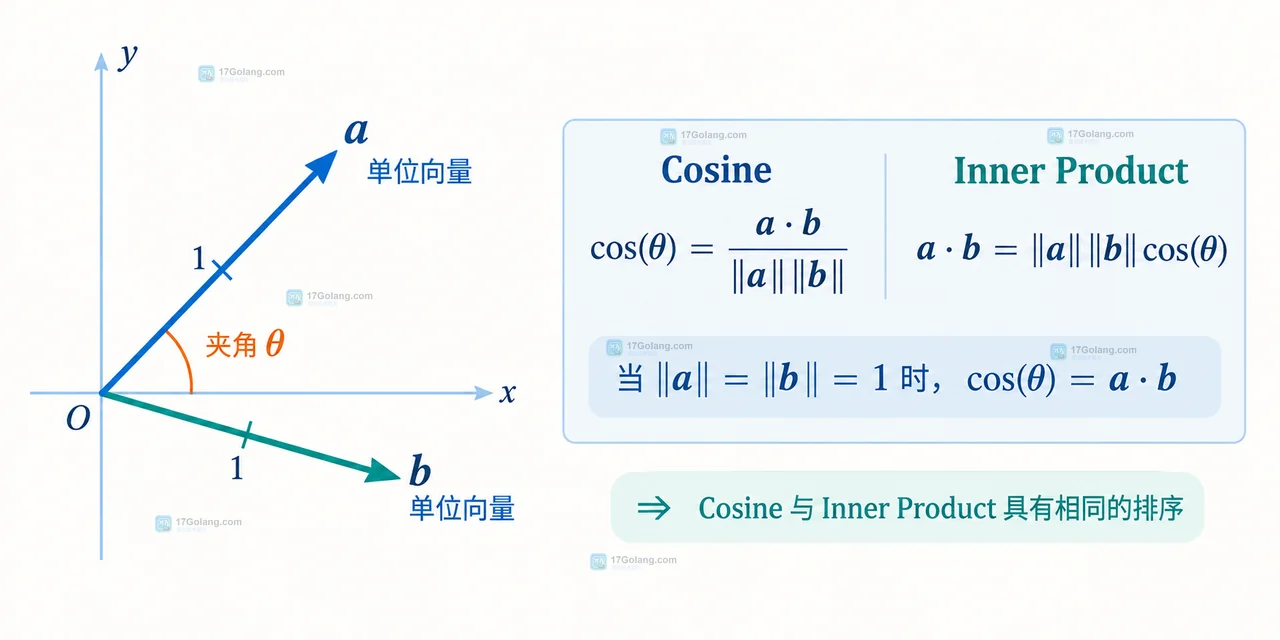 向量搜索选余弦距离还是内积,取决于 embedding 模型是否归一化,以及向量长度是否承载业务信息。本文用公式、Python 示例和选择表说明两者边界,并提醒区分相似度与数据库距离。260 收藏
-
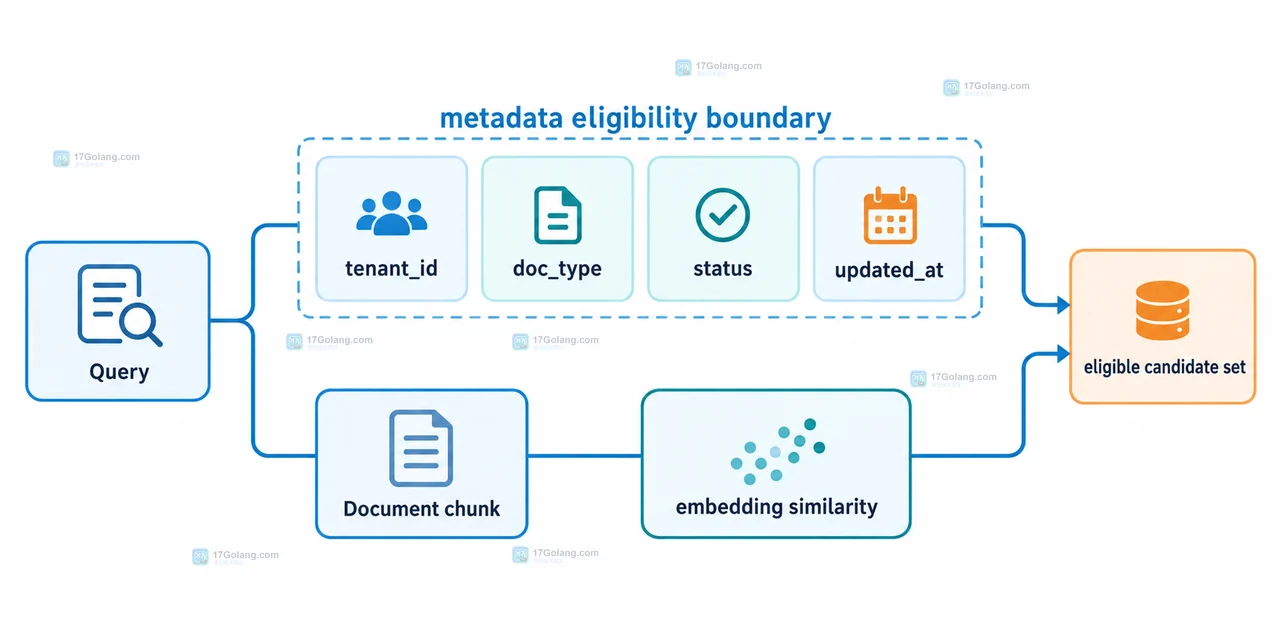 RAG 检索结果太多时,不要只提高 top_k 再把无关片段塞给模型。本文用租户、文档类型、状态和更新时间说明如何先做元数据过滤,再做向量或混合检索,并根据过滤选择性调整召回策略。437 收藏
-
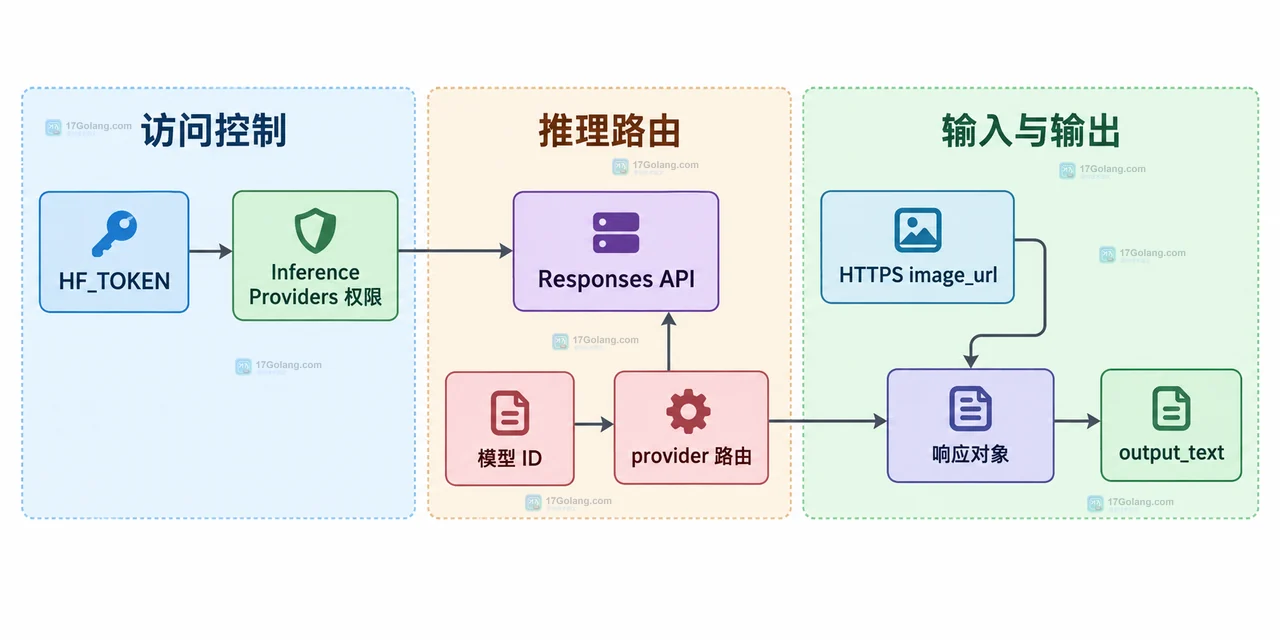 Hugging Face Responses API 可以在同一个 input 数组中组合 input_text 与 input_image。本文用 Python 和 OpenAI SDK 说明请求结构,并按令牌权限、模型路由、图片 URL 和输出字段拆解常见失败原因。392 收藏
-
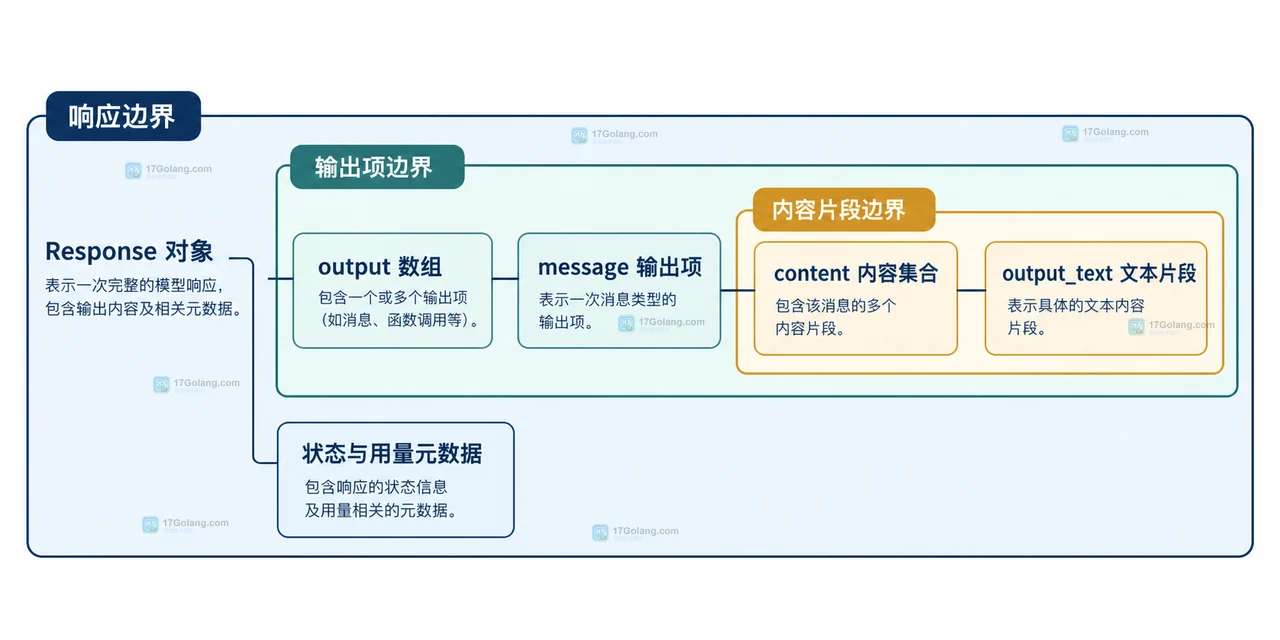 讲清 OpenAI Responses API 中 output_text 便捷文本与 output 完整输出项的区别,覆盖展示、结构化处理、工具调用、标注和流式读取等常见场景。277 收藏
-
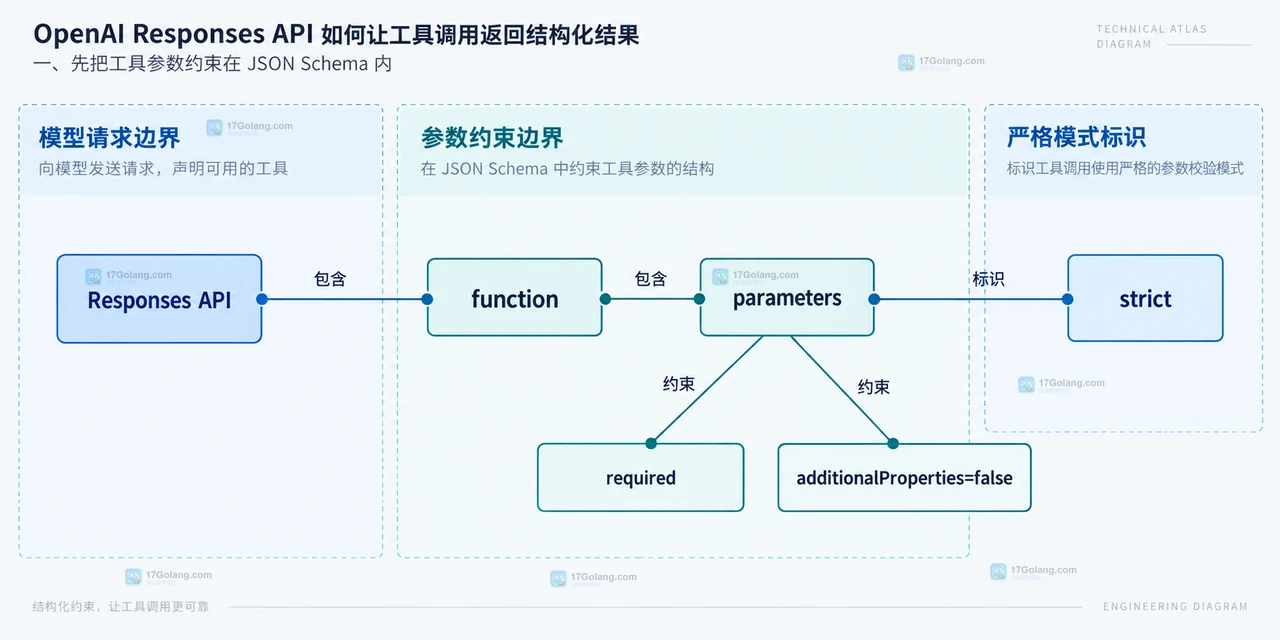 用 Responses API 的 strict JSON Schema 约束工具参数,再通过 function_call_output 回传可解析结果,并说明如何单独约束最终 JSON 回复。274 收藏
-
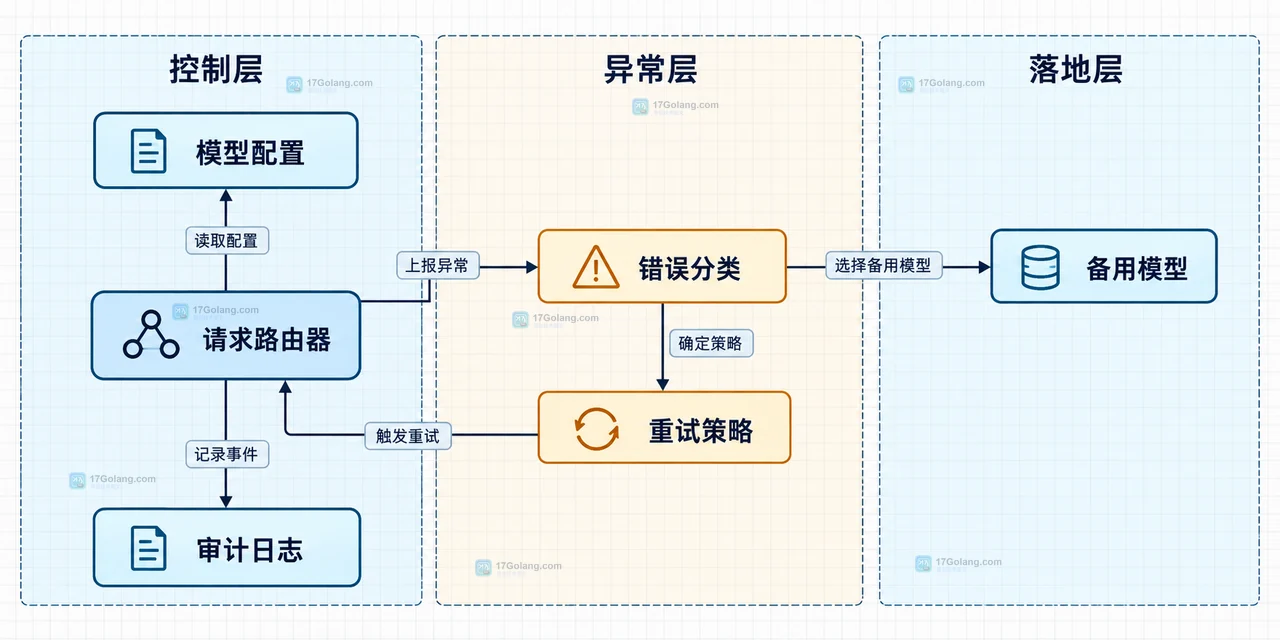 GPT-6 Astra API 限量开放期间,应用应区分访问资格、参数错误与 429/5xx 临时故障,再按能力档案选择备用模型,并记录实际模型与降级原因。192 收藏
-
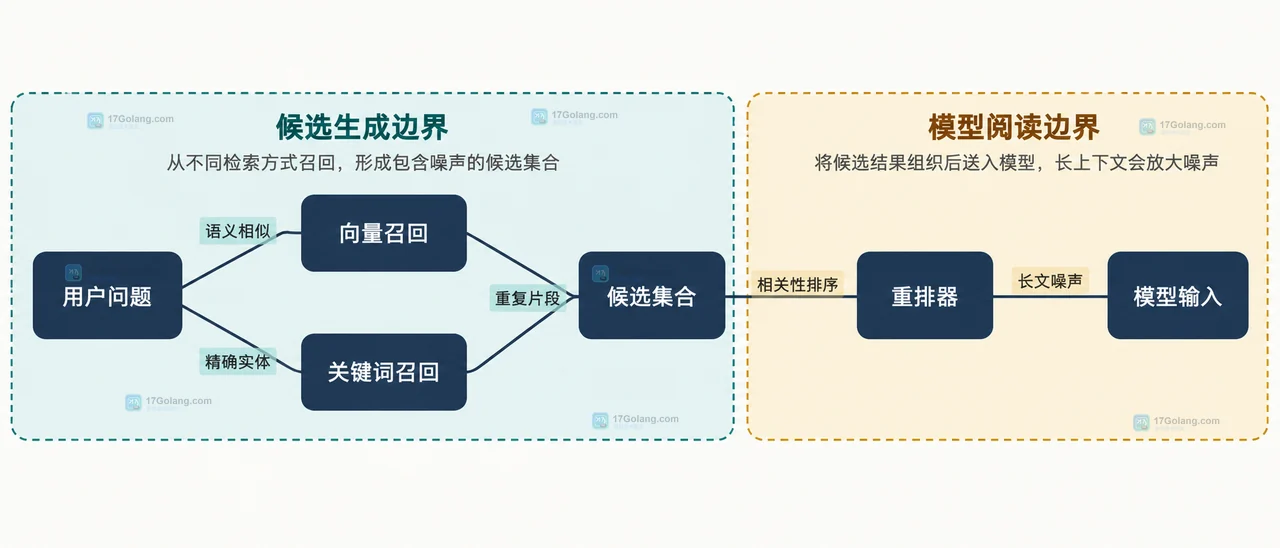 模型能接收更长输入,不代表它会更稳定地使用检索结果。本文从位置效应、候选重复和长文噪声解释原因,并给出混合召回、重排、去重与 token 预算的收敛做法。386 收藏
-
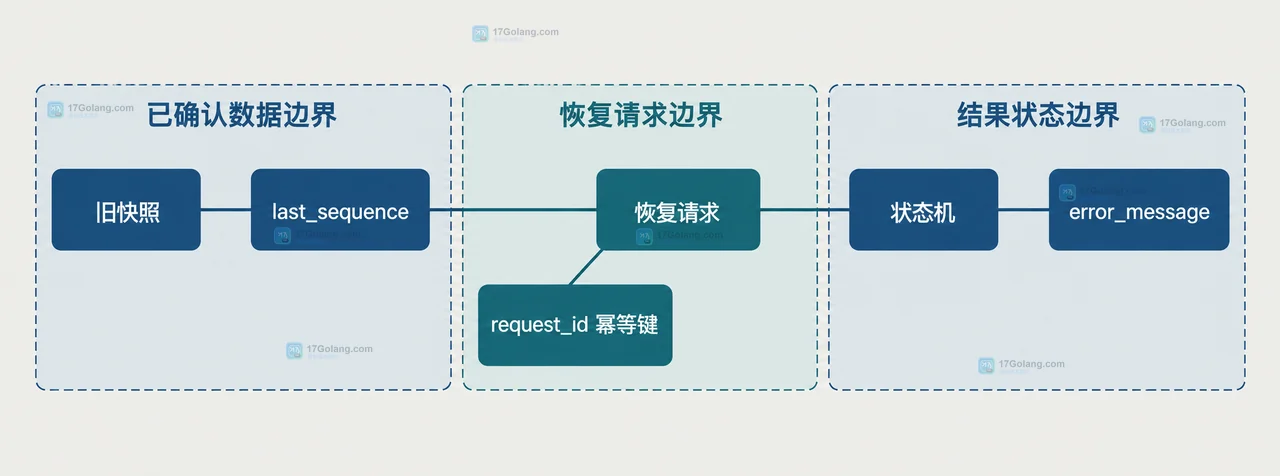 AI 流式输出中途断开时,不要等完整响应才落库。应以请求唯一标识和片段序号保存增量快照,区分 partial、completed、interrupted 状态,并在重连时用幂等键避免重复拼接。278 收藏
-
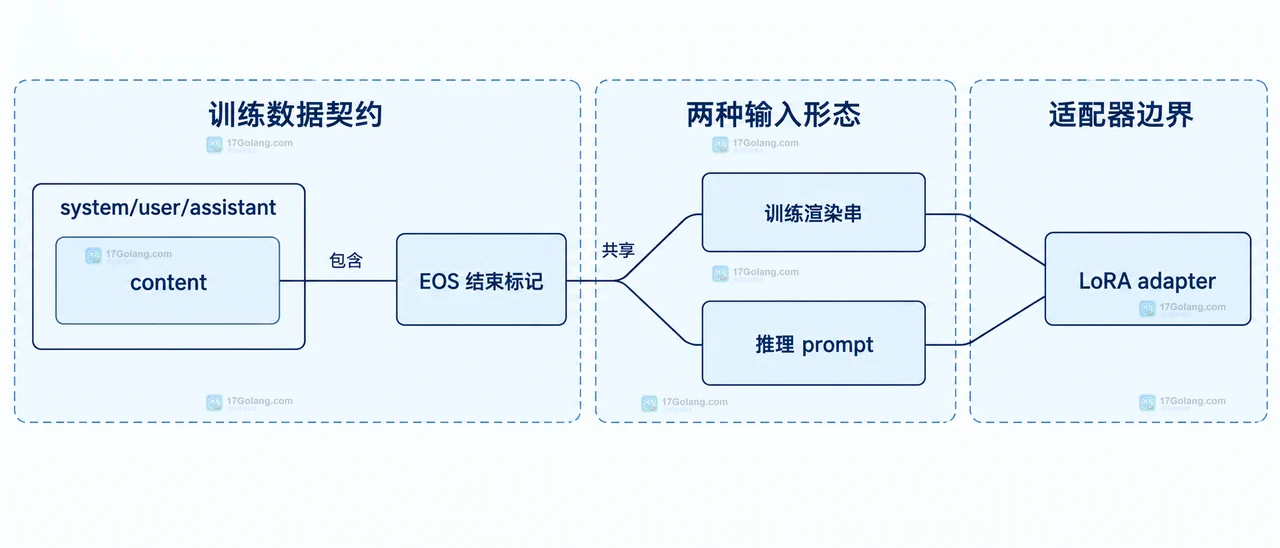 LoRA 微调效果不只取决于 rank 和学习率,训练样本的角色、模板、结束标记与推理入口也必须保持一致。本文用 messages 示例说明如何固定这份格式契约。426 收藏
-
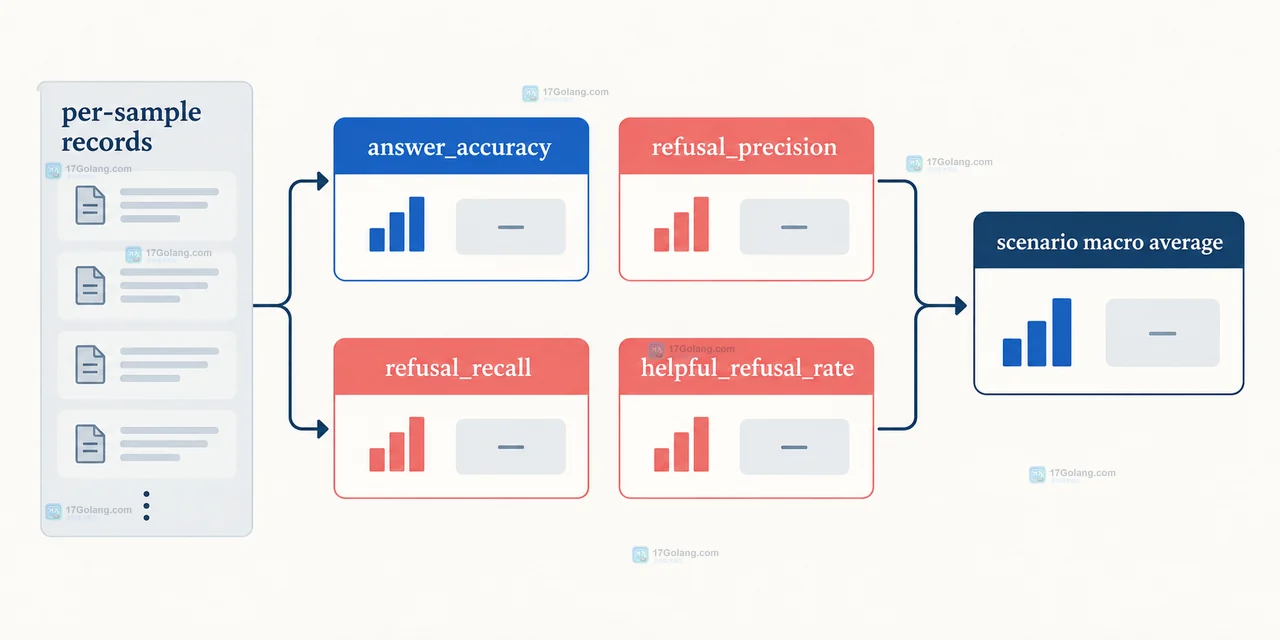 AI 评测集不要只放标准答案。把应答、应拒答和边界样本分开,记录 expected_action、拒答理由、人工标注和安全替代建议,再分别计算准确率、漏拒答率与拒答帮助度。385 收藏
-
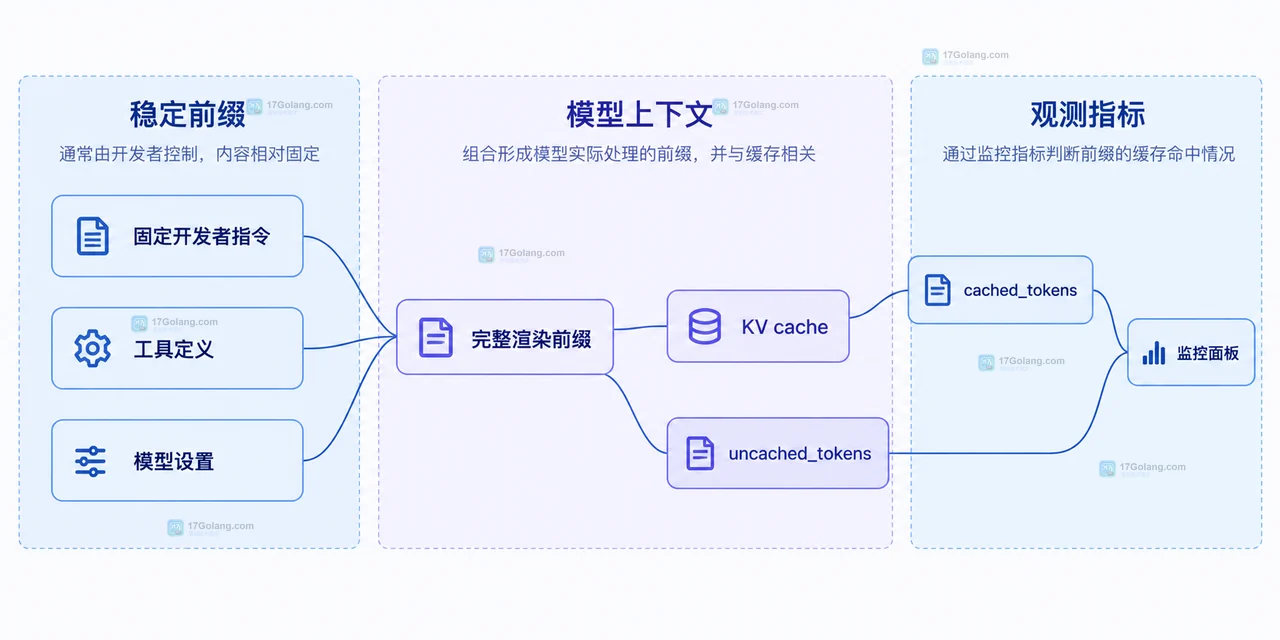 Prompt 缓存命中率下降时,先比较最终渲染前缀而不是源模板。本文用 cached_tokens、prefix hash、模型设置和动态字段边界给出一套可复查的排查方法。487 收藏
-
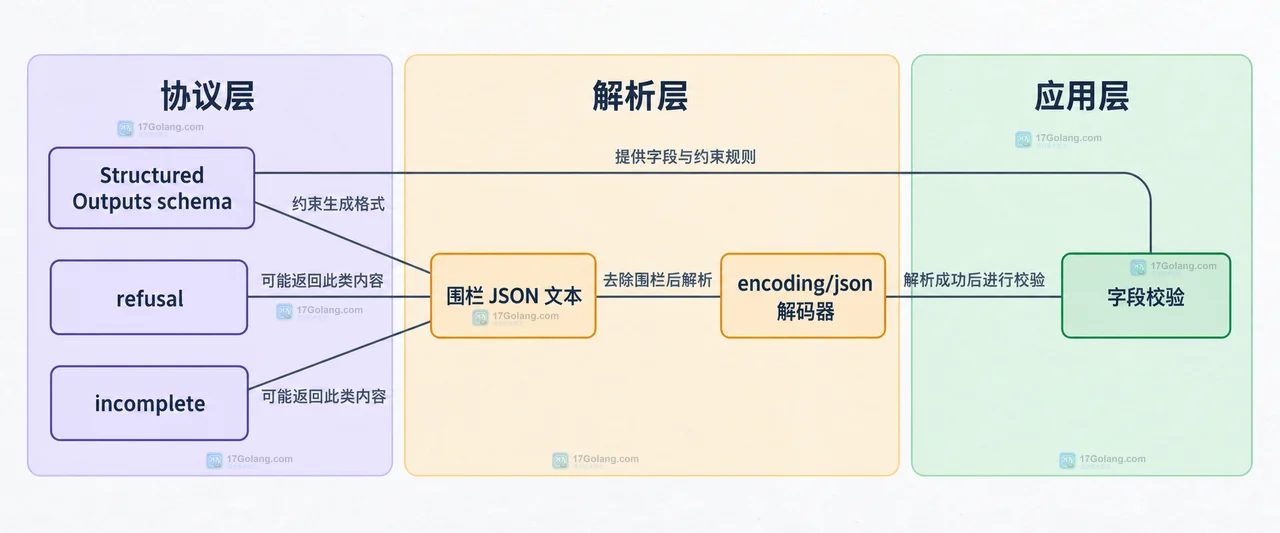 模型输出 JSON 偶尔带有 Markdown 围栏时,先判断拒答和截断状态,再只清理首尾围栏,最后用 encoding/json 解码并执行字段级业务校验。398 收藏
-
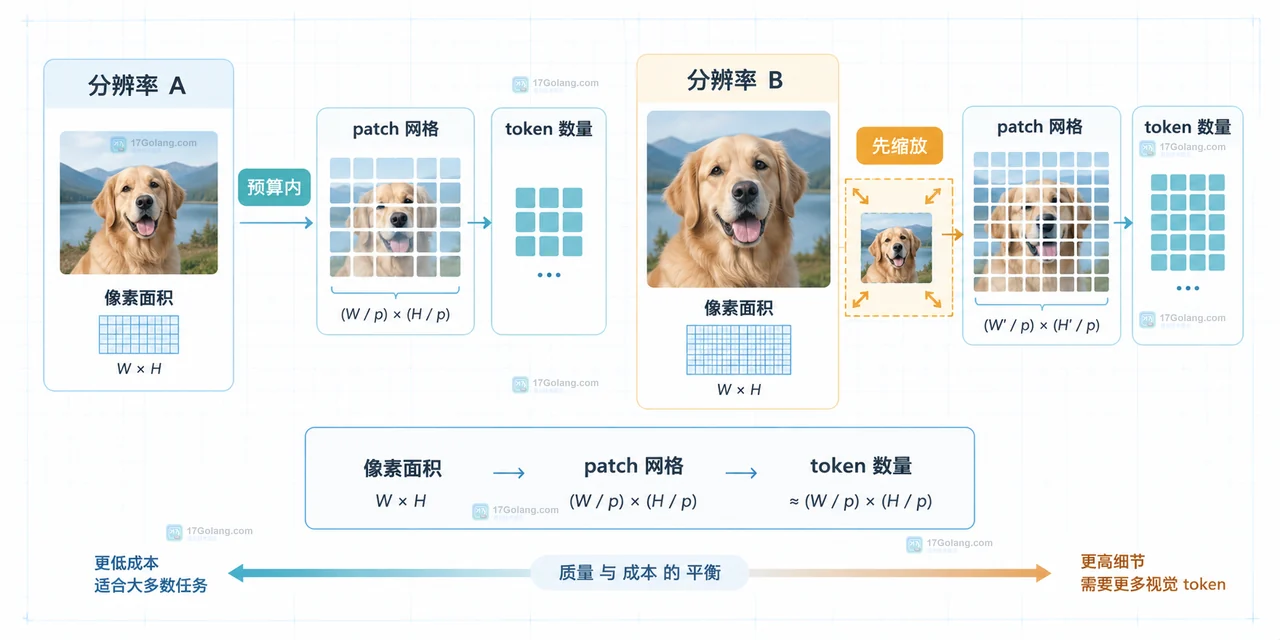 多模态模型的图片成本不只取决于文件大小,还取决于处理器如何把像素切成视觉 token。本文以 Hugging Face Transformers 的 processor 为参照,说明服务端怎样读取 min_pixels、max_pixels,按像素预算等比例缩放,再决定压缩、裁剪和监控字段。259 收藏
-
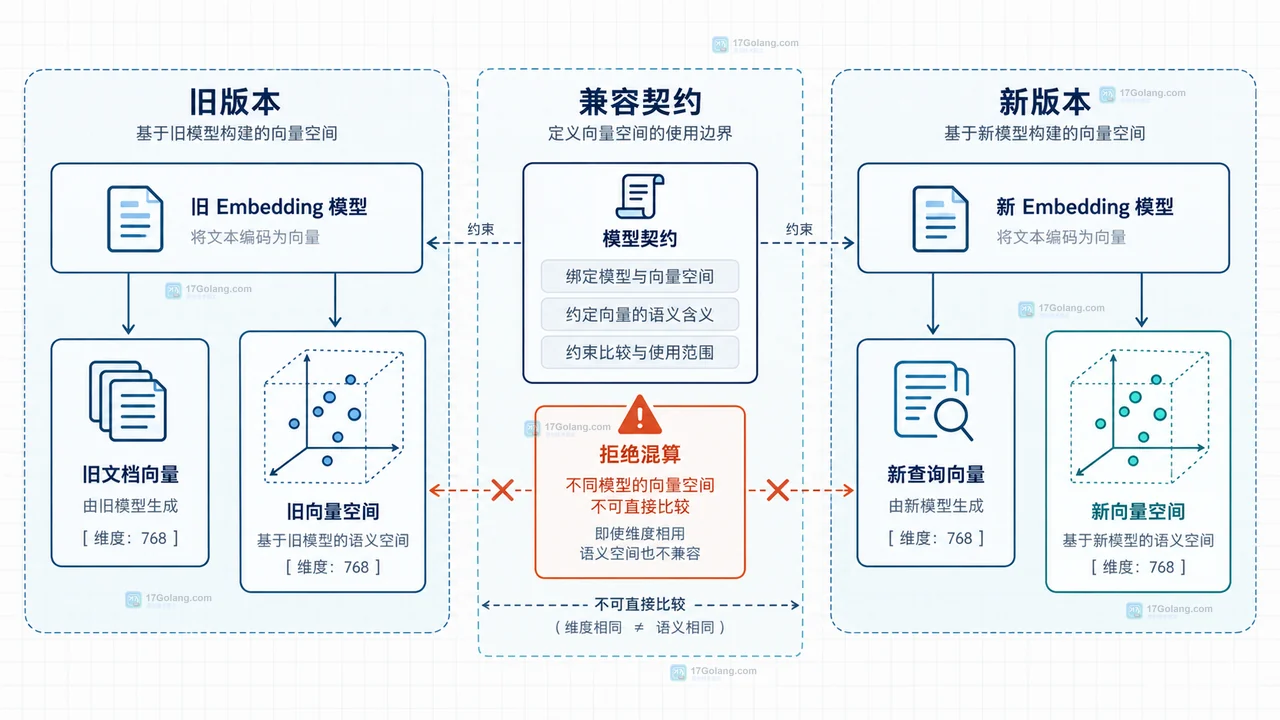 Embedding 模型更换后,旧文档向量与新查询向量可能不在同一个向量空间;即使维度相同,语义方向、归一化和提示词约定也可能不同。本文给出双写、全量回填、离线验收、别名切换和回滚方案。259 收藏