-
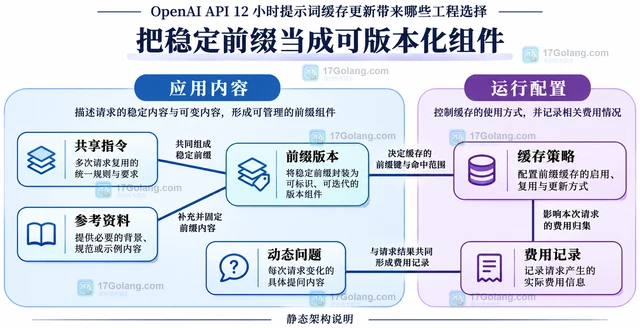
解读 OpenAI API 12小时提示词缓存更新,从长间隔复用、写入成本和稳定前缀版本管理出发,比较缓存寿命选择与工程落地边界。
-
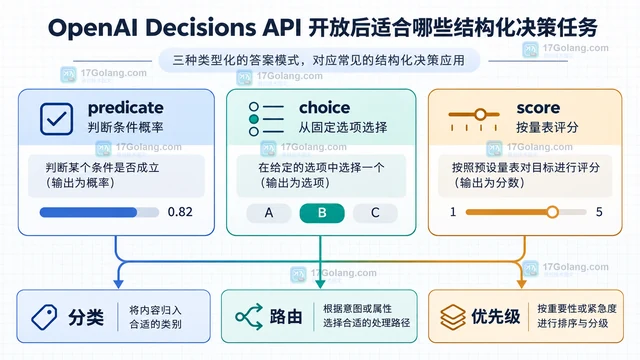
OpenAI Decisions API 正式开放后,最适合处理答案空间受限的判断:判断条件是否成立、从固定选项中选路由、按量表给输入评分。本文结合文本、图片和原生 JSON 输入,说明它适合哪些结构化决策任务,以及何时应该继续使用 Responses API 或函数调用。
-
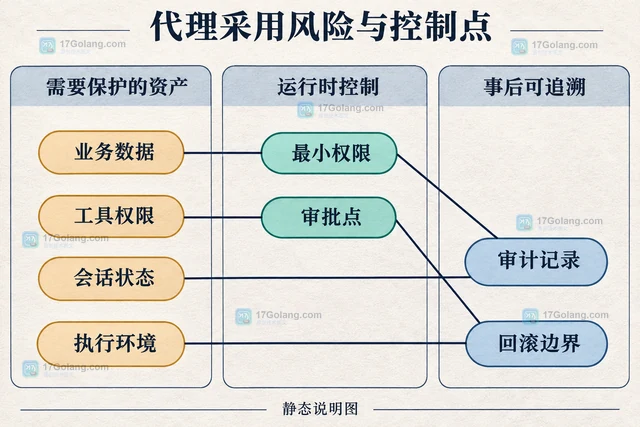
OpenAI DevDay 2026 对 Agents API 的变化,不只是多了几个工具,而是把代理应用的运行时、工具层、分发面和云部署边界重新拆开。本文按托管运行时、SDK/API 分层、Computer Use、AWS 集成和安全风险说明如何判断采用路径。
-
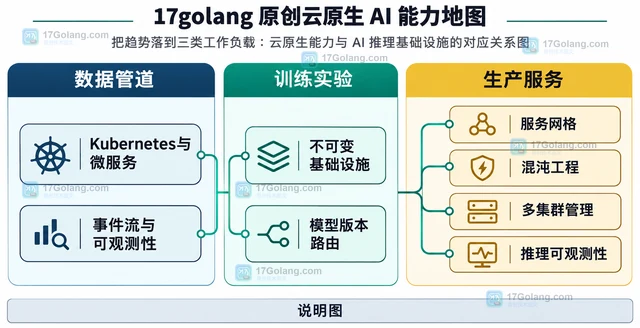
CNCF 2026 年云原生报告显示,Kubernetes 生产使用已较普及,但 AI 模型持续部署仍处于早期。本文按数据管道、训练实验和生产服务拆解推理基础设施趋势。
-
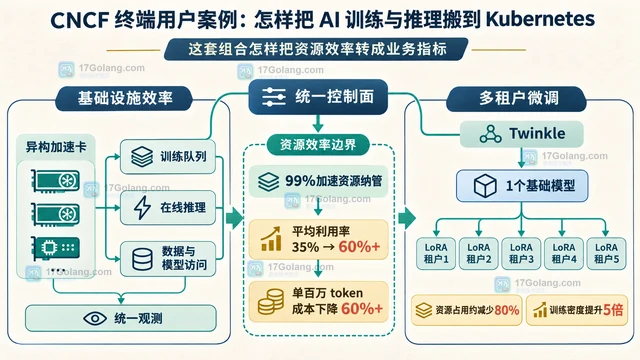
CNCF 公布的招商银行终端用户案例,把 AI 训练、微调和在线推理放进统一 Kubernetes 控制面。本文拆解 Kueue、KEDA、Prometheus、HAMi、Fluid 与 Twinkle 的分工,并解释资源利用率、成本和训练密度指标。
-
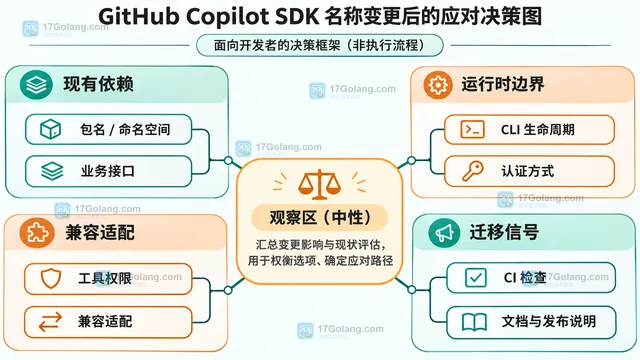
GitHub Copilot SDK 正在分阶段转向 Microsoft Copilot SDK。本文把品牌变化、包与命名空间迁移、Copilot CLI 运行时边界拆开,帮助开发者决定继续观察、先加适配层,还是启动正式迁移。
-
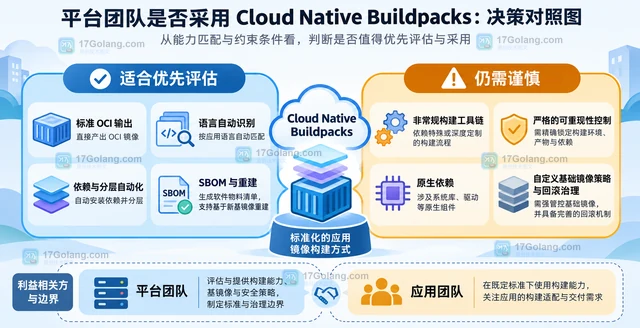
Cloud Native Buildpacks 从 CNCF 孵化项目毕业,意味着它在生产采用、厂商中立治理和安全实践上达到新的成熟度。本文把这条消息拆成源码到 OCI 镜像的构建链路、一次隔离试用和平台团队的采用边界,帮助你判断它是否适合现有交付流程。
-
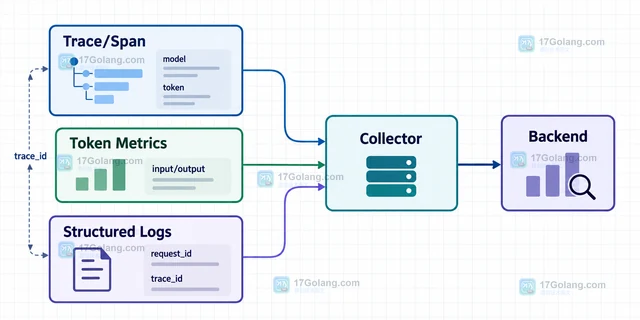
用 OpenTelemetry 的 trace、metric 和结构化日志记录 AI 应用的 token 用量与请求追踪信息,并比较日志、Collector 和厂商 SDK 的适用边界。
-
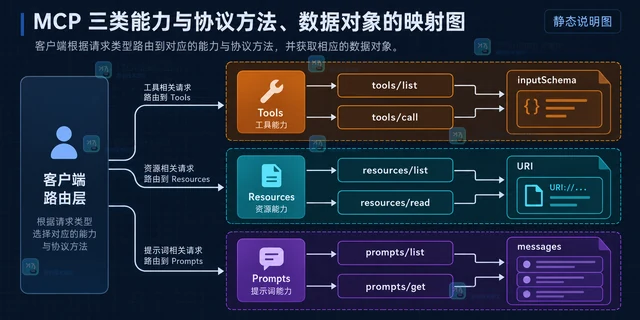
MCP 客户端不要靠名称猜对象类型,而应先读取初始化响应中的 tools、resources、prompts 能力,再按 tools/list、resources/list、prompts/list 等方法路由。本文用统一目录、交互模型和安全指标拆开三类能力的边界。
-
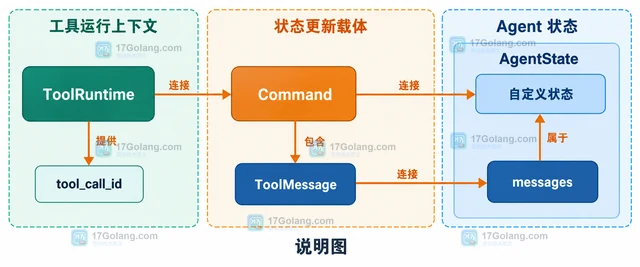
LangChain 的工具调用不是把返回值自动塞进任意列表,而是要用 AIMessage 中的调用记录和匹配的 ToolMessage 组成连续消息历史;工具还需要改状态时,再通过 Command 同时写回 messages 和自定义状态。
-
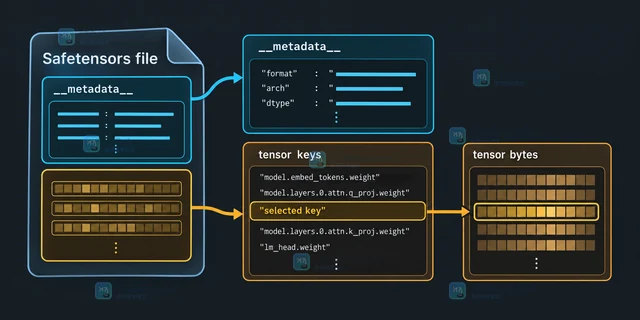
Safetensors 文件可以先通过 safe_open 查看权重键和文件级元数据,再按目标键读取单个张量。本文说明 get_tensor、get_slice、metadata 的分工,并处理缺键、空元数据和分片模型边界。
-
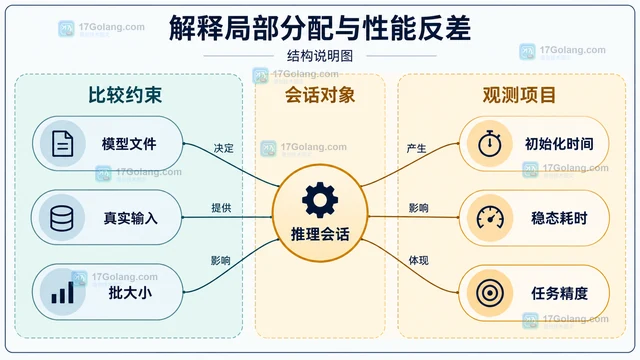
ONNX Runtime 的执行提供者应结合硬件、依赖、算子覆盖与模型形状选择。本文说明 CUDA、TensorRT、OpenVINO、DirectML 和 CoreML 的候选范围,提供注册顺序与性能比较示例,区分可用、注册和实际分配。
-
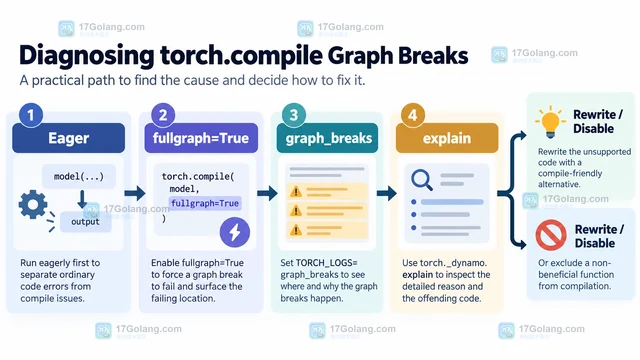
torch.compile 变慢或日志出现多个 FX 图时,先用 eager 基线排除代码错误,再用 fullgraph=True、TORCH_LOGS=graph_breaks 和 torch._dynamo.explain 定位断点。本文按值班手册给出改写、隔离和回退路径。
-
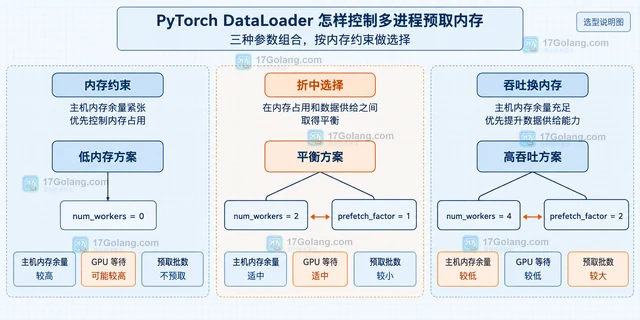
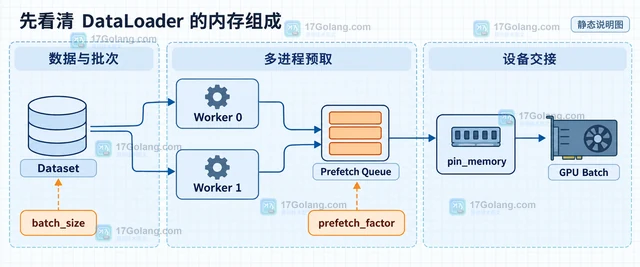
PyTorch DataLoader 的多进程内存主要受单批大小、num_workers 和 prefetch_factor 共同影响。本文用预取批次数估算主机侧占用,并比较低内存、平衡吞吐和高吞吐配置,同时说明 pin_memory、persistent_workers 与 IterableDataset 的边界。
-
OpenAI Realtime API 断线后不会替应用自动恢复业务上下文,稳定做法是把连接与会话状态分开保存,重连后重新配置 session,再按确认点重放摘要和未确认输入,最后只对完整的新输入触发 response.create。
