
人工智能技术文章
-
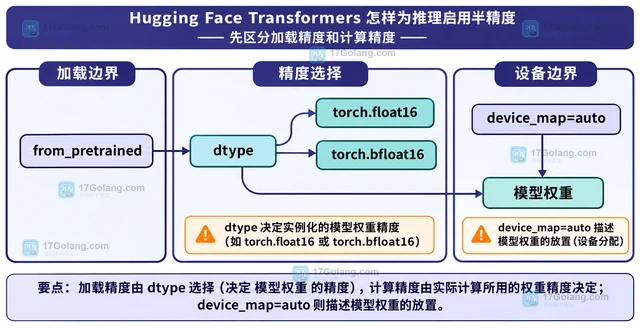 用 Transformers 做推理时,dtype 负责权重加载精度,autocast 负责前向计算精度。本文给出 float16、bfloat16 与 float32 的选择方法、代码示例和兼容性检查清单。212 收藏
-
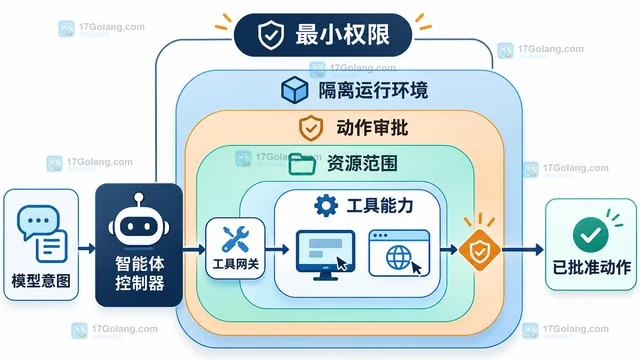 Holo4 这类计算机使用代理可以跨桌面、网页和移动端执行长流程任务,但不应该只用一个总开关管理权限。本文按工具能力、资源范围、动作审批和隔离运行环境四层拆解权限,并给出浏览器、文件系统与 Shell 的策略示例。212 收藏
-
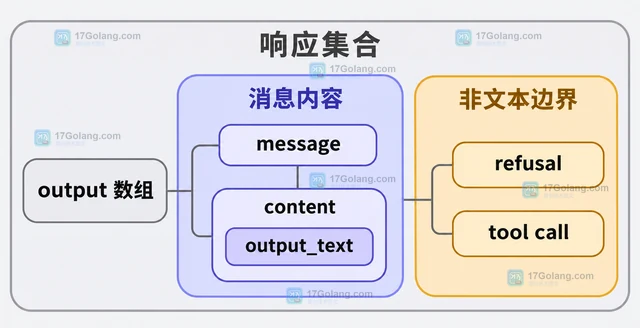 Responses API 只展示文本时可用 SDK 的 output_text 便捷字段;涉及工具调用、拒答、注释或完整响应记录时,应遍历 output 并按 type、content 类型解析,不能假设 output[0] 一定是最终文本。212 收藏
-
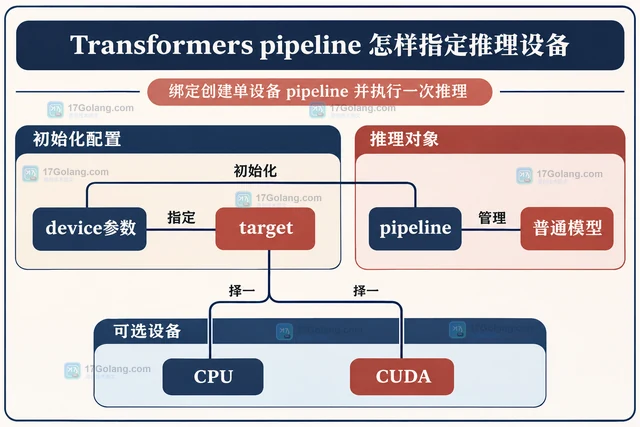 Transformers pipeline 在初始化时用 device 指定 CPU 或 CUDA 等设备。本文说明本地模型示例、输入张量移动、单设备检查,以及 device 与 device_map 不应混用的原因。212 收藏
-
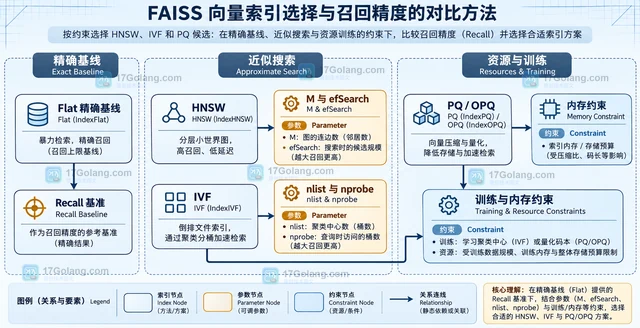 用 IndexFlat 建立精确基线,再比较 HNSW、IVF 与 PQ 组合的 Recall@K、查询延迟和内存占用,给出可复现的 FAISS 索引选型方法。212 收藏
-
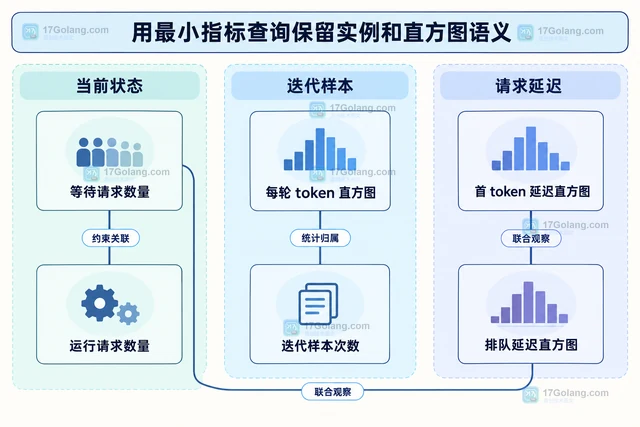 观察 vLLM continuous batching 时,将等待队列、运行请求、每轮 token、KV 缓存和延迟分开统计,说明旧指标迁移、PromQL 查询口径及调度参数的取舍。211 收藏
-
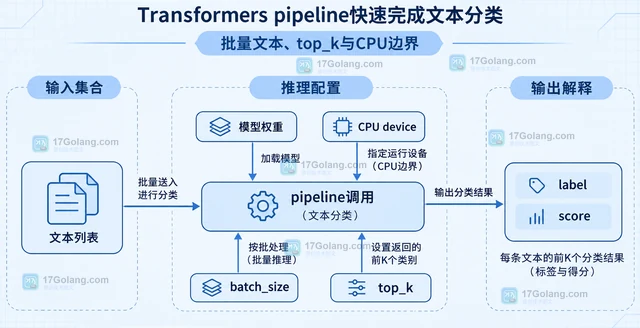 用 Transformers pipeline 接入已经微调好的文本分类模型,完成单条与批量文本推理,解释 label、score、top_k、batch_size 和 CPU 设备参数的边界。211 收藏
-
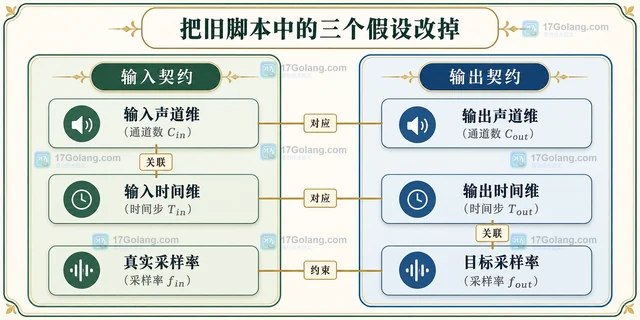 torchaudio多声道重采样应保留声道维并沿最后一维处理。结合48kHz到16kHz的张量示例,说明旧脚本迁移、采样率标签、核缓存及设备精度的配套修改。210 收藏
-
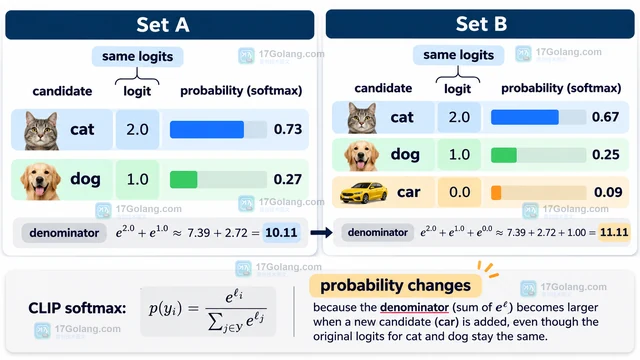 CLIP 增删候选标签后,已保留标签的概率也会变化,根因是 softmax 的归一化分母变了,而不是模型重新理解了图像。本文从 logits_per_image、分母和工程阈值三个层面说明如何正确比较结果。210 收藏
-
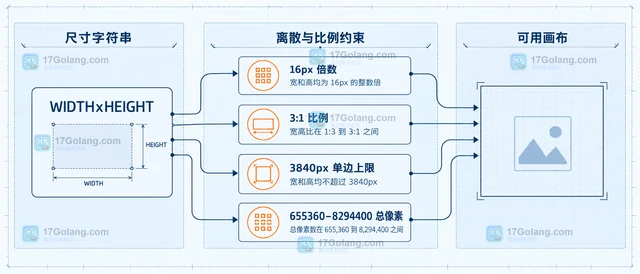 讲清 Image API 的 size、quality、输出格式与自定义尺寸边界,给出 Python 请求示例和尺寸检查方法。208 收藏
-
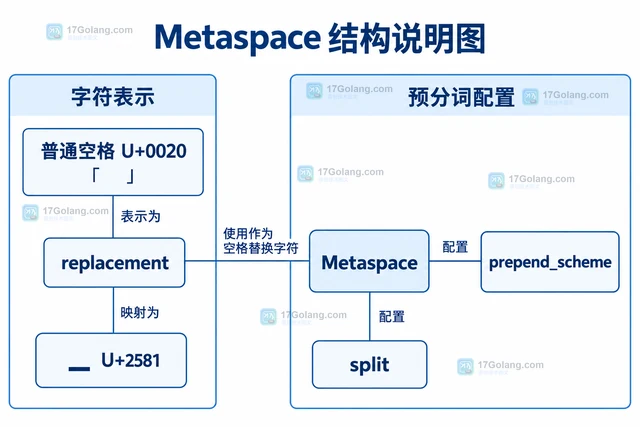 Tokenizers Metaspace 用可见标记表示空格。本文解释 replacement、prepend_scheme、split 的区别,给出片段观察示例,并说明迁移旧参数时应保留模型的词表与解码约定。208 收藏
-
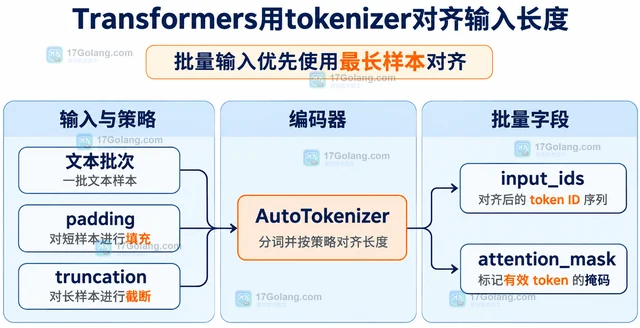 Transformers 中的 tokenizer 可以用 padding 补齐短文本、用 truncation 截断长文本,再通过 max_length 或 pad_to_multiple_of 对齐批量输入。本文用最小 Python 示例说明批内最长、固定长度和硬件倍数三种场景,并解释 input_ids 与 attention_mask 如何配合检查结果。207 收藏
-
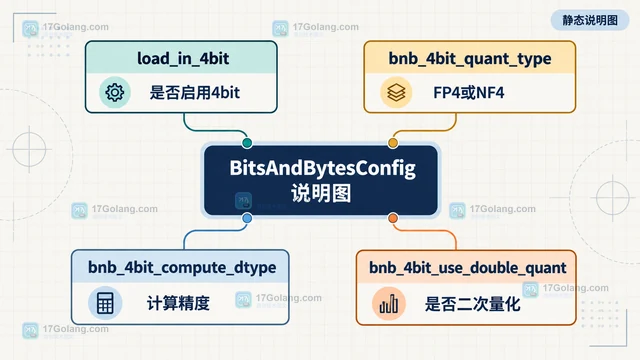 通过 BitsAndBytesConfig.to_dict() 和 model.config.quantization_config 读取 4bit 量化配置,重点区分 load_in_4bit、nf4/fp4、计算 dtype 与双重量化字段。205 收藏
-
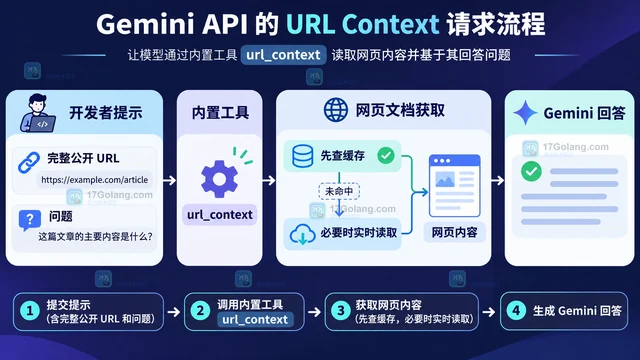 本文围绕 Gemini API 内置 URL Context,说明如何提交公开网页、如何读取 URL 引用与检索状态,以及 20 个 URL、34MB、登录墙和私有网络等输入边界。204 收藏
-
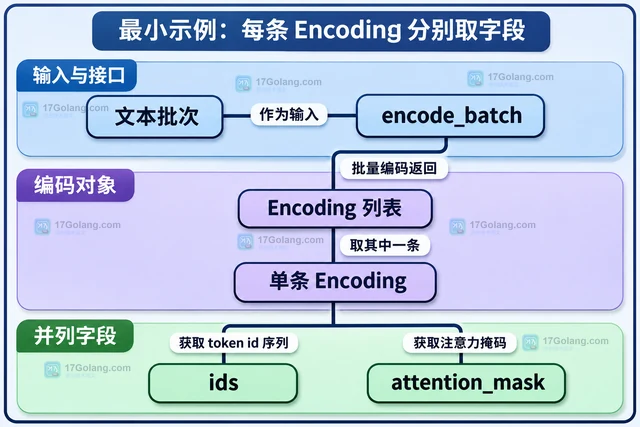 以 Tokenizers 0.20.3 Python API 为例,展示 encode_batch 返回 Encoding 列表后读取 ids 与 attention_mask 的写法,并说明填充、截断、输入资源限制及模型配套配置。204 收藏