
人工智能技术文章
-
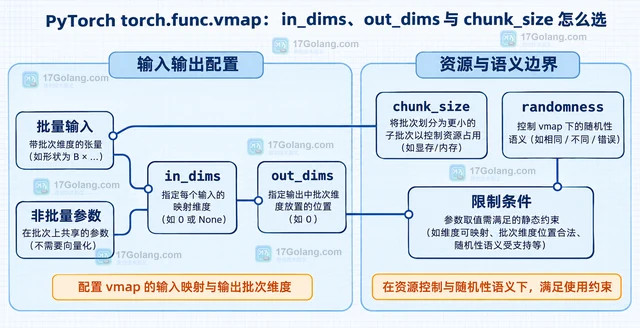 把单样本函数改成批量处理时,不必先手写一层 for 循环。PyTorch 的 torch.func.vmap 可以沿指定输入维度提升函数,同时用 in_dims、out_dims 和 chunk_size 控制维度与显存边界。230 收藏
-
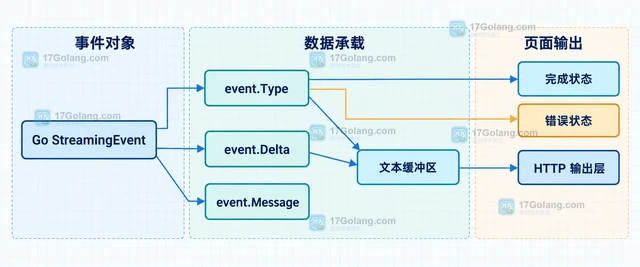 用 OpenAI Responses API 的语义事件搭建一个 Go SSE 转发服务:把增量文本、完成信号和错误信号分别映射到消息区、按钮状态和错误提示,避免页面把所有流式事件混成普通文本。228 收藏
-
科技周边 · 人工智能 | 1星期前 | python · Hugging Face Datasets Dataset.filter with_indices input_columns load_from_cache_file num_proc
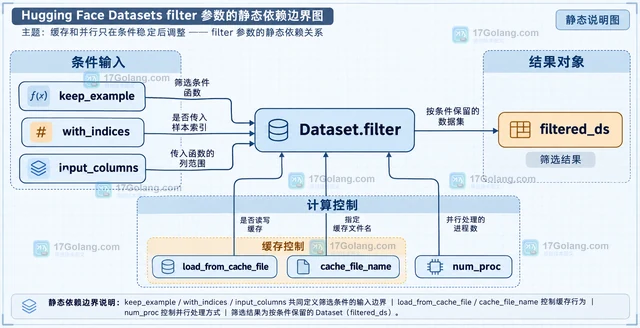 Hugging Face Datasets 的 Dataset.filter 按条件返回新的数据集对象。本文用 Python 说明条件函数、with_indices、input_columns、缓存和 num_proc 的边界,并整理行数、字段与空结果的检查方法。225 收藏
-
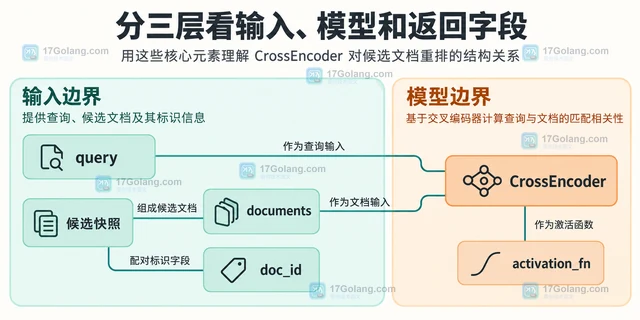 用CrossEncoder重排候选文档,保留corpus_id与业务ID映射,并区分召回缺失、分数含义、语言不匹配和长文本截断问题。224 收藏
-
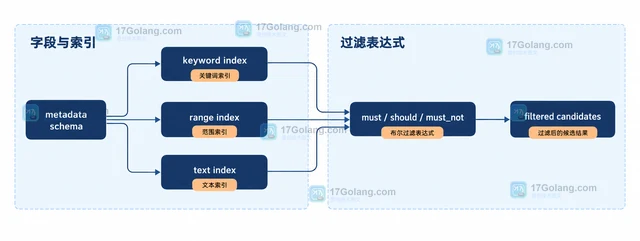 RAG 元数据过滤要先定义字段和权限边界,再把条件放进向量检索请求。本文用 Qdrant 风格示例说明字段类型、过滤组合、索引和空结果排查。223 收藏
-
科技周边 · 人工智能 | 3星期前 | 人工智能 · 工具调用 · 自定义函数 OpenAI Responses API Function Calling function_call_output strict function_call
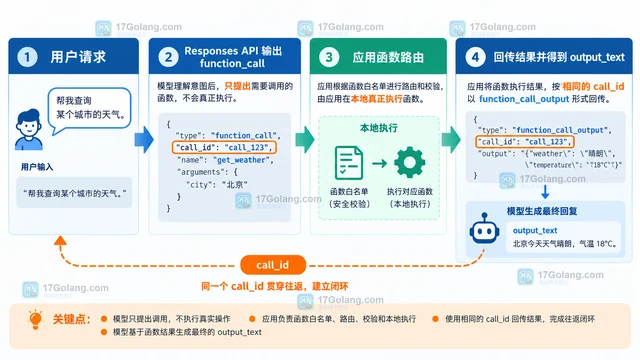 在 Responses API 中注册自定义函数工具,读取模型返回的 function_call,执行本地业务函数,再用原始 call_id 回传 function_call_output。本文用一个完整 JavaScript 片段讲清工具契约、调用闭环、strict 和并行调用边界。223 收藏
-
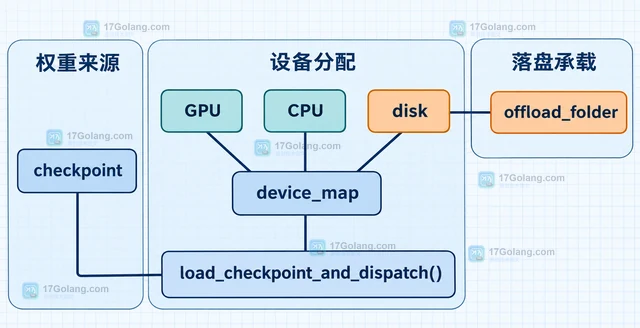 说明 Accelerate disk_offload 如何把模型权重映射到本地目录,区分已加载模型的 offload_dir 与检查点加载时的 device_map、offload_folder,并解释 execution_device、推理边界和磁盘性能影响。223 收藏
-
科技周边 · 人工智能 | 3星期前 | 性能优化 · Hugging Face Datasets IterableDataset flatten_indices indices mapping Arrow
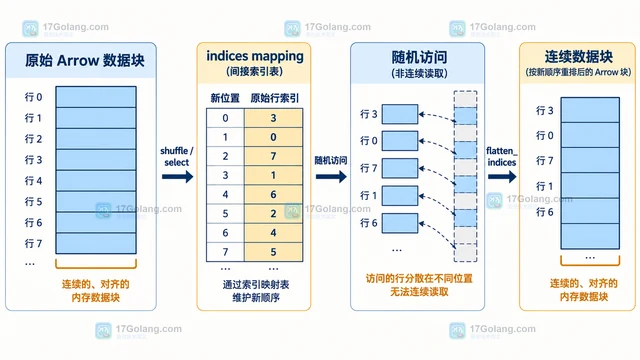 Hugging Face Datasets 在 shuffle、select 等操作后可能带有 indices mapping,导致访问不再连续。本文用 flatten_indices 重写数据,说明缓存、批量写入、并行和 IterableDataset 的选择边界。222 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · 深度学习 · PyTorch DataLoader Accelerate 多进程训练 split_batches dispatch_batches
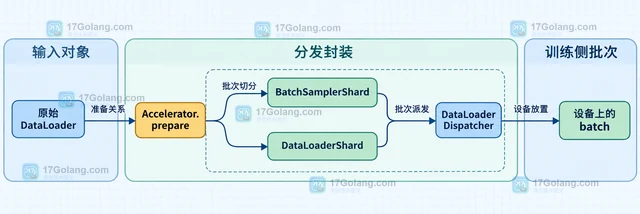 本文围绕 Accelerator.prepare() 说明如何把 PyTorch DataLoader 接入多进程训练,重点解释 split_batches、dispatch_batches、even_batches 的批次分发、设备放置和尾部样本边界。222 收藏
-
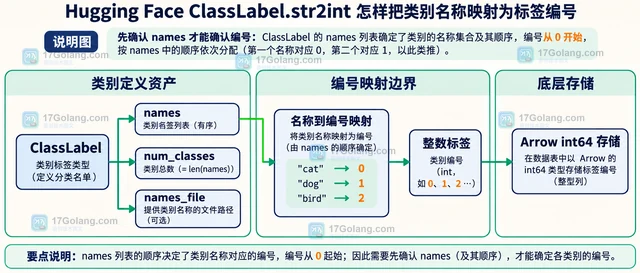 用 Hugging Face Datasets 的 ClassLabel.str2int 把类别名称转换成整数标签,说明 names 顺序、单值与批量返回、空白和数字字符串处理,以及非法标签的边界。222 收藏
-
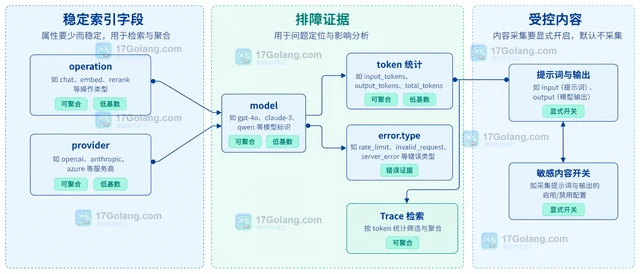 给 AI 应用的入口、模型调用和工具调用补上可关联的 OpenTelemetry trace,说明 span 边界、GenAI 语义属性、错误记录和敏感内容控制,帮助判断问题究竟慢在哪一层。219 收藏
-
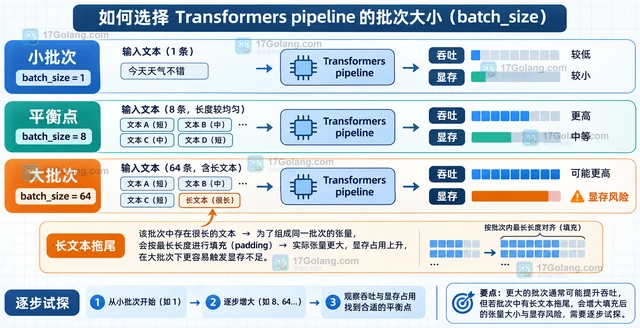 Transformers pipeline 支持列表、Dataset 和生成器输入。本文用文本分类场景说明如何设置 batch_size,解释 padding 与长文本造成的显存风险,并给出从小批次开始、同时记录吞吐和峰值显存的可回退配置方法。218 收藏
-
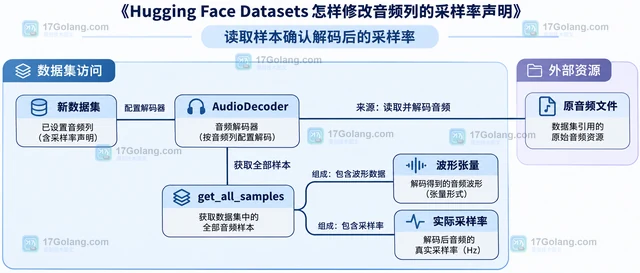 Hugging Face Datasets 可用 cast_column 和 Audio 设置音频列目标采样率。通过本地文件示例区分特征声明、按需解码重采样与原文件导出,并说明新旧返回接口的差异。215 收藏
-
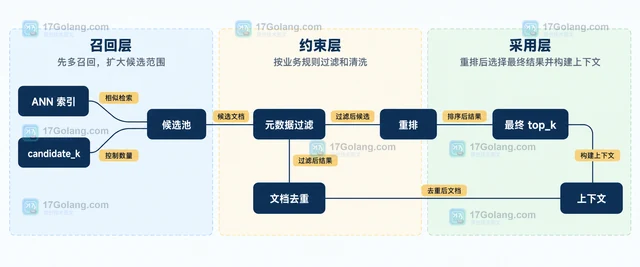 向量检索里的 top-k 不是越大越好,也不是相似度阈值。本文从接口契约出发,说明如何区分 top_k、候选过取、分数阈值、过滤和去重,并给出适合小数据集与大规模索引的参数设计。214 收藏
-
科技周边 · 人工智能 | 2星期前 | 性能优化 · 人工智能 · 深度学习 · PyTorch CUDA SDPA scaled_dot_product_attention Flash Attention
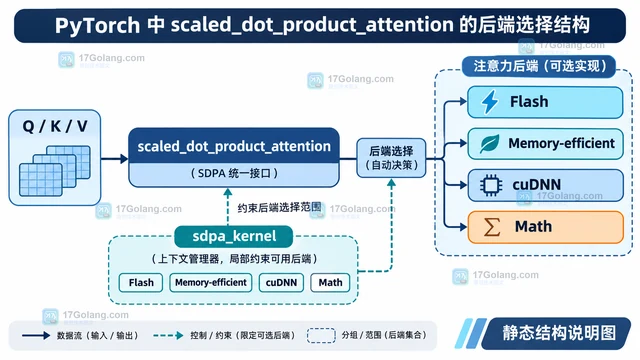 PyTorch 的 scaled_dot_product_attention 默认会根据输入和设备选择可用实现。本文用 sdpa_kernel 说明如何做局部后端约束,并从 CUDA、dtype、mask、dropout、GQA 和数值精度几个条件判断 fused kernel 为什么回退。214 收藏