-
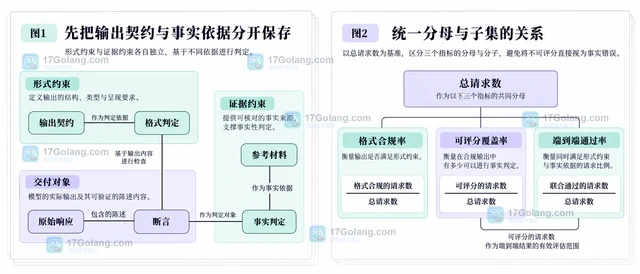
AI评估应分别记录事实依据与格式合规。本文用同一组示例说明断言支持、字段约束、不可评分项及报告分母,避免用格式正确代替事实正确。
-
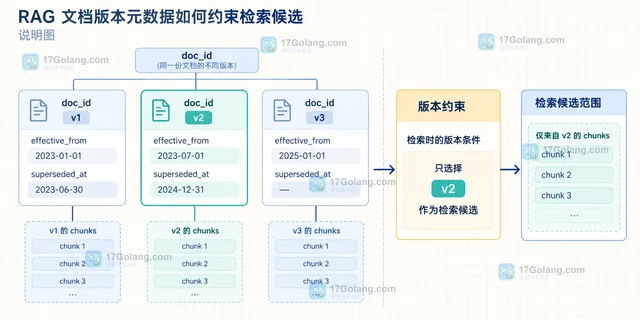
RAG 多版本文档不要只靠向量相似度区分新旧内容。本文用版本元数据、检索前过滤、索引和压测指标,给出一套可落地的候选过滤方案。
-
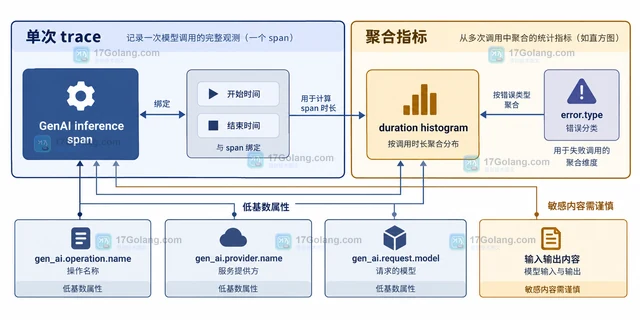
把模型客户端请求包在一个覆盖完整响应生命周期的 OpenTelemetry GenAI span 中,trace 会自动记录这次调用的持续时间;再用稳定语义属性和 histogram 做聚合延迟,注意流式响应、异常取消、敏感内容和重复埋点边界。
-
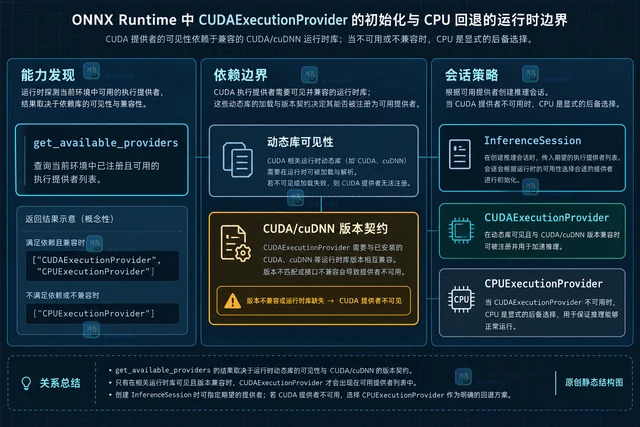
说明 ONNX Runtime 如何根据硬件、安装包和运行库选择 CPU 或 CUDA provider,给出可用能力判断、CUDA 优先回退 CPU 的 Python 写法,并梳理 CUDA 与 cuDNN 的兼容边界。
-
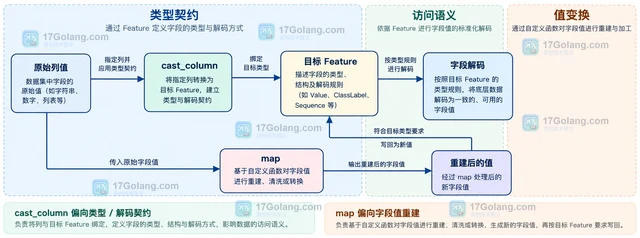
本文围绕 Hugging Face Datasets 的 cast_column,说明如何查看 features、把列映射到目标 Feature,以及何时应该改用 map 重建字段值。
-
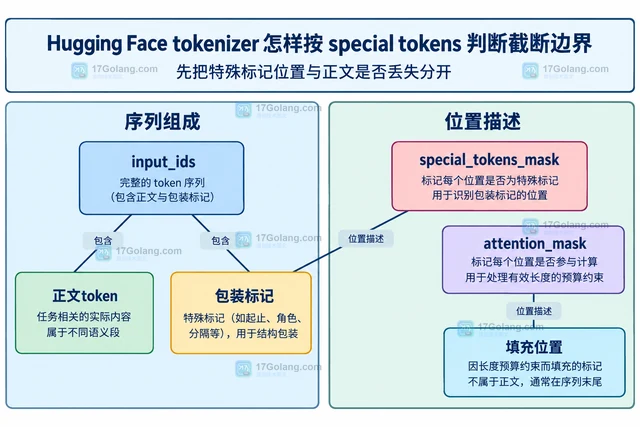
结合未截断编码、special_tokens_mask和模型包装开销,判断Hugging Face tokenizer的截断边界;解释文本对only_second、sequence_ids及SEP/EOS不能证明正文完整的原因。
-
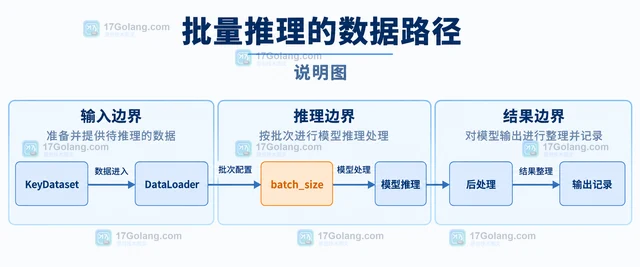
Hugging Face pipelines 的 batch_size 适合在可批处理的数据集推理中逐步调节。本文说明参数放在哪里、GPU 与 CPU 的边界、sequence_length 对显存的影响,以及如何记录吞吐、延迟和 OOM 风险。
-
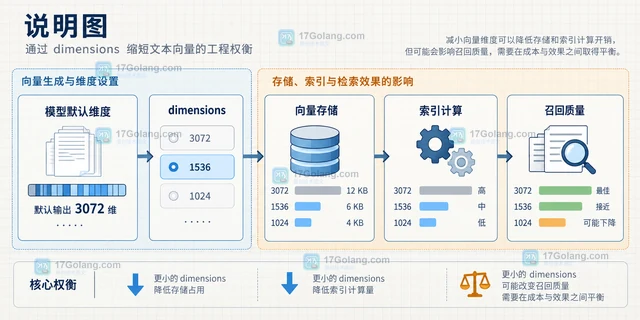
OpenAI embeddings 的 dimensions 不是越大越好。本文从默认维度、向量库限制、检索质量、存储与回滚几个方面,说明 text-embedding-3-small 和 text-embedding-3-large 怎样选择维度缩减参数。
-
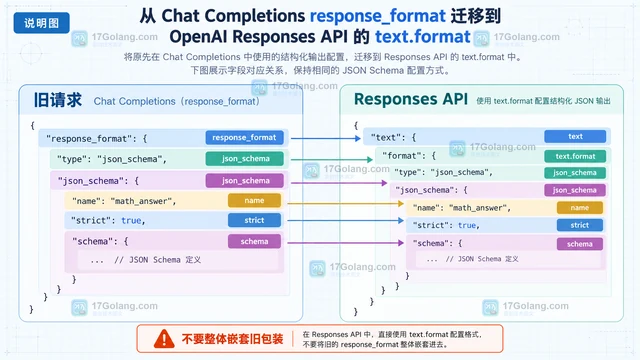
Responses API 的结构化输出要放在 text.format 中,用 json_schema 和 strict:true 约束 JSON 形状。本文从 Chat Completions 迁移差异、Schema 设计、JavaScript 调用和拒答/不完整响应处理四个方面整理可执行写法。
-
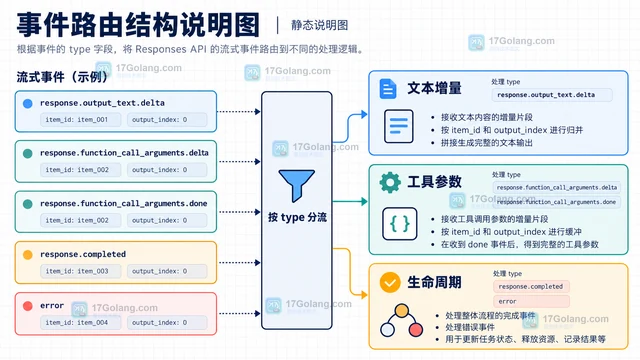
OpenAI Responses API 的流式响应会同时发送文本增量、工具参数片段和生命周期事件。本文按 type 分流,说明 response.output_text.delta、function_call_arguments.delta 与 done 事件的处理边界,以及工具执行前的白名单、参数校验和状态收束。
-
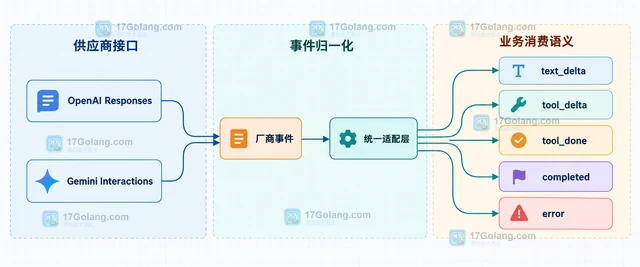
AI 流式接口会同时发送文本增量、工具调用参数和生命周期事件。本文用事件类型建立统一分流规则,说明 OpenAI Responses 与 Gemini Interactions 的差异,以及工具参数何时才适合解析。
-
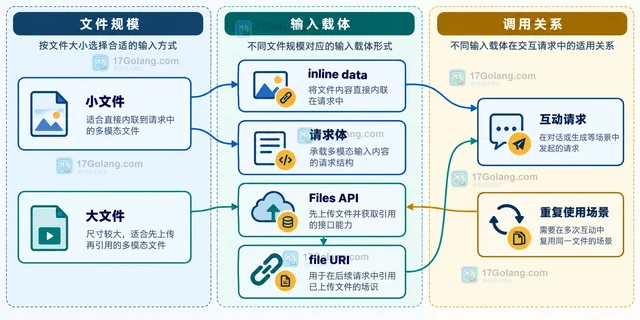
处理图片、音频、视频和 PDF 时,先把文件转换成可信的 MIME 类型,再映射到 image、audio、video 或 document 内容对象;小文件单次调用可用内联数据,较大或需要复用的文件应使用 Files API。本文用一套路由层说明输入对象、PDF 边界和文件 URI 的选择。
-
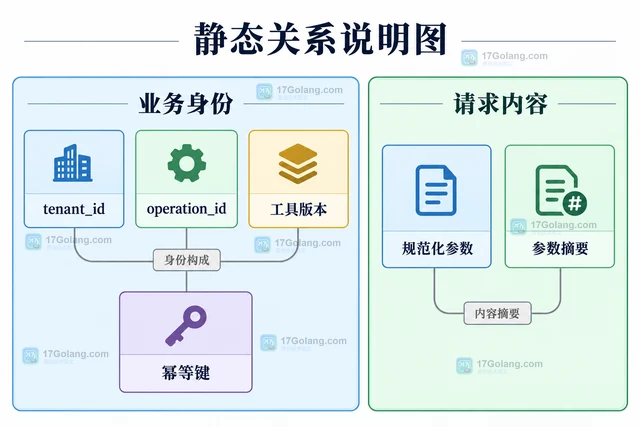
AI 工具调用的幂等键应绑定一次已授权的业务操作,配合原子占位、参数摘要和结果复用。本文用最小决策代码解释重复执行、参数冲突及远程超时后的不确定状态。
-
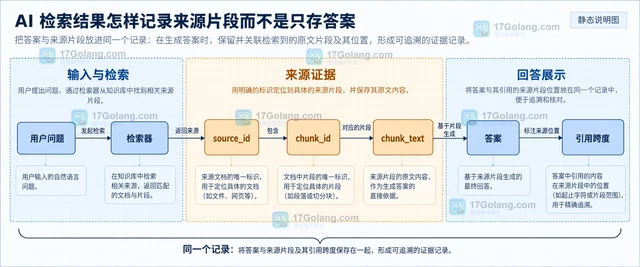
AI 应用不要只保存最终答案。本文用检索增强的常见数据模型说明如何保存 source_id、chunk_id、chunk_text、回答片段和支持关系,并结合 Gemini groundingMetadata 的 groundingChunks 与 groundingSupports 设计可追溯记录。
-
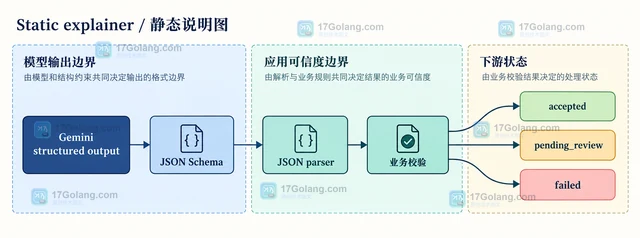
AI 结构化输出并不等于业务数据已经可信。本文用 Gemini API 演示如何区分接口失败、JSON 解析失败和语义校验失败,并把不可用结果安全降级到待审核流程。
