
人工智能技术文章
-
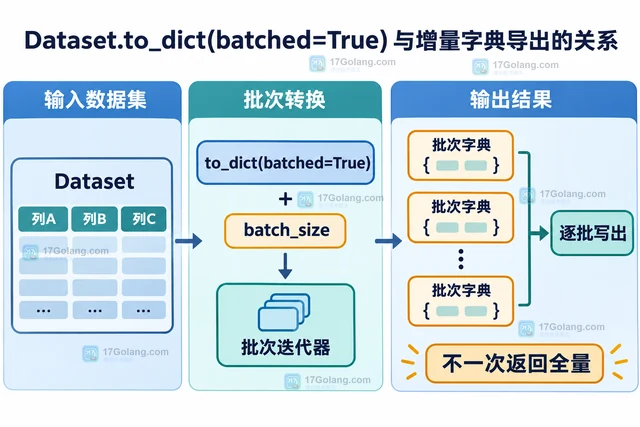 用 Dataset.to_dict(batched=True) 按 batch_size 分批导出列式字典,并对比 to_json、行式记录和 IterableDataset 的使用边界,避免一次聚合全量数据。241 收藏
-
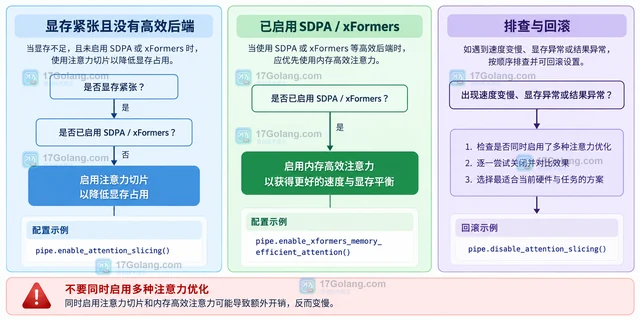 讲清 Diffusers attention slicing 与 SDPA、xFormers 等高效注意力后端的关系,说明为什么重复开启可能变慢,并给出选择与回滚配置。240 收藏
-
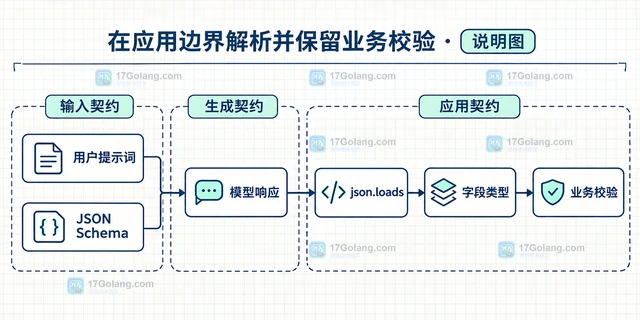 本文用一个工单分类示例说明 vLLM OpenAI 兼容服务如何通过 structured_outputs.json 接收 JSON Schema,约束字段、类型和枚举值,并在应用层继续完成 JSON 解析与业务校验。240 收藏
-
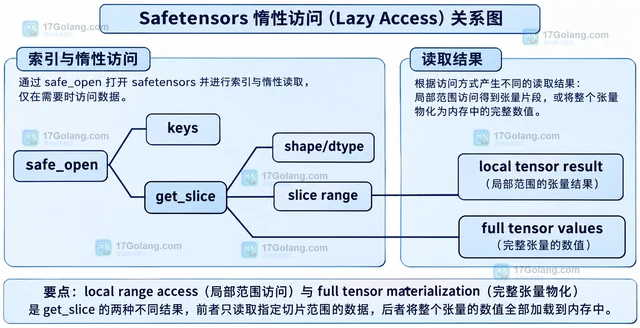 用 safe_open 读取 Safetensors 的张量名、dtype、shape 和文件 metadata,并用 get_slice 按需访问局部数据,避免查看模型结构时加载全部权重。240 收藏
-
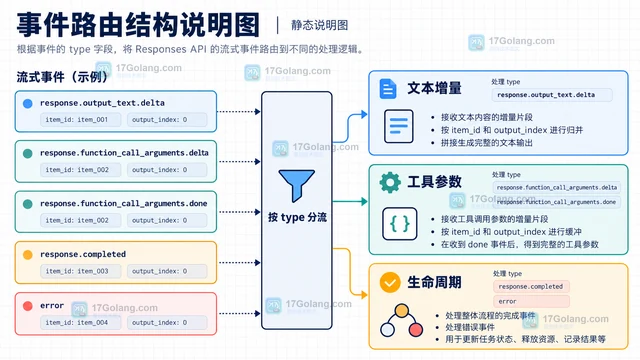 OpenAI Responses API 的流式响应会同时发送文本增量、工具参数片段和生命周期事件。本文按 type 分流,说明 response.output_text.delta、function_call_arguments.delta 与 done 事件的处理边界,以及工具执行前的白名单、参数校验和状态收束。239 收藏
-
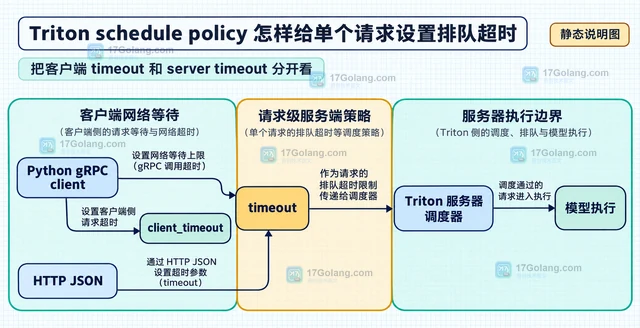 Triton 的 schedule policy 可以把 timeout 放进单个推理请求,让动态批处理队列按微秒值处理等待边界。本文说明模型队列策略、HTTP parameters.timeout、Python gRPC timeout 与 client_timeout 的区别。239 收藏
-
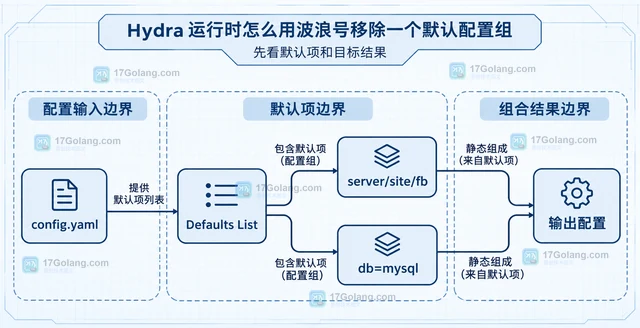 本文用 Hydra 命令行的波浪号覆盖临时删除 Defaults List 配置组,说明 ~group、~group=option 和完整路径的写法,以及删除后最终配置的变化。239 收藏
-
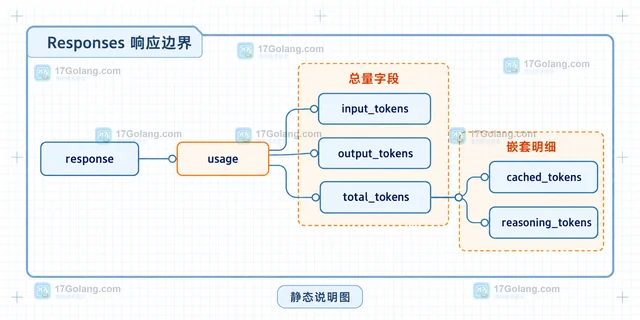 OpenAI API 的 usage 字段位于响应对象中。本文区分 Responses API 与 Chat Completions 的字段命名,演示读取输入、输出、总量及缓存/推理明细,并说明流式响应为什么可能拿不到最终 usage。234 收藏
-
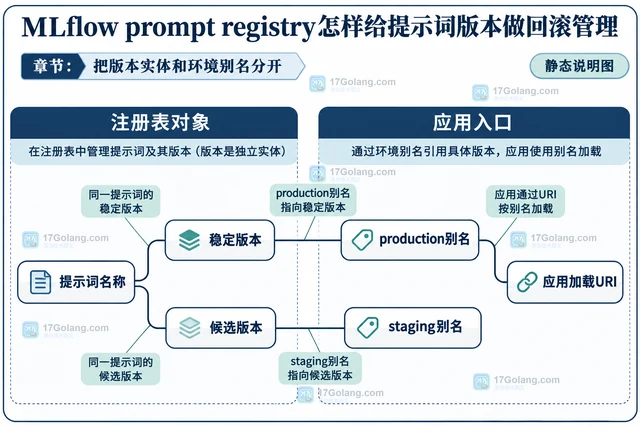 MLflow Prompt Registry如何把production别名切回稳定版本,通过load_prompt处理缓存和应用重载,并记录实际版本、模板变量与发布依赖。234 收藏
-
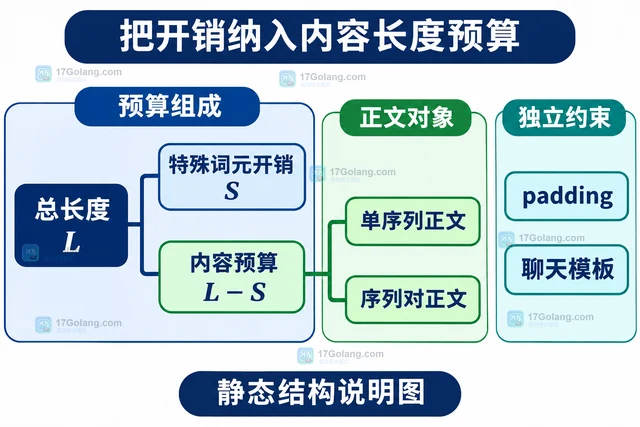 分别读取单序列与序列对的特殊词元开销,结合已确认的总输入长度计算内容预算,并区分正文分词、padding、聊天模板和重复扣减问题。233 收藏
-
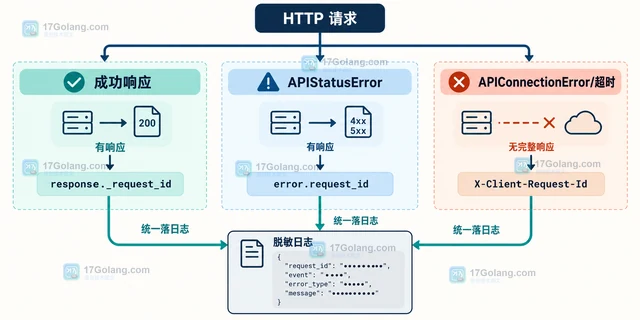 OpenAI API 的 x-request-id 是定位单次请求的重要线索。本文按成功响应、SDK 异常和网络超时三种场景,说明如何读取服务端请求 ID、设置 X-Client-Request-Id,并用脱敏日志保留可复查证据。231 收藏
-
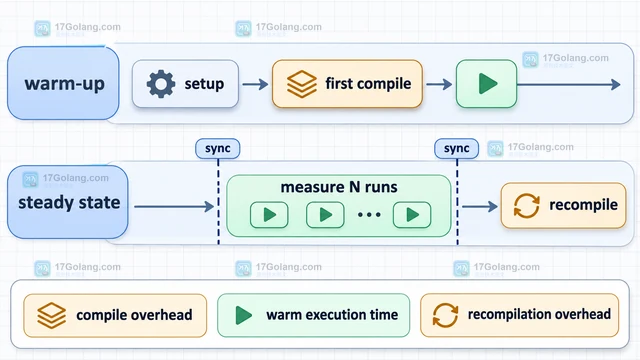 PyTorch torch.compile 的第一次调用可能包含图捕获、编译和缓存建立,不能直接与后续调用比较。本文用分阶段计时、设备同步、预热循环和 guards 日志,区分首次编译、缓存命中与输入变化触发的重新编译。231 收藏
-
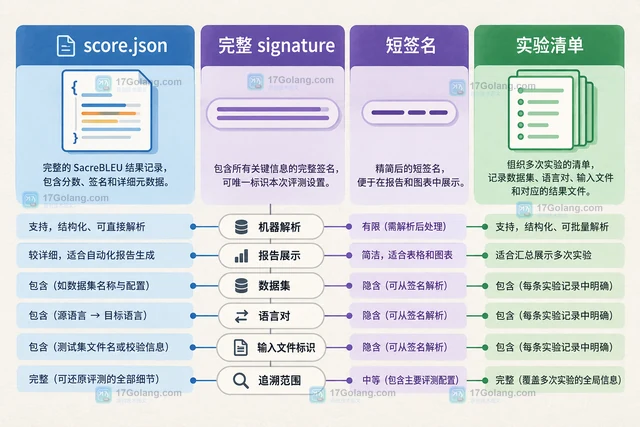 SacreBLEU 的分数不能脱离 tokenizer、大小写、平滑方式和版本单独保存。本文比较 JSON 完整记录、短签名和自有清单三种归档方式,给出可复用的命令与选择建议。230 收藏
-
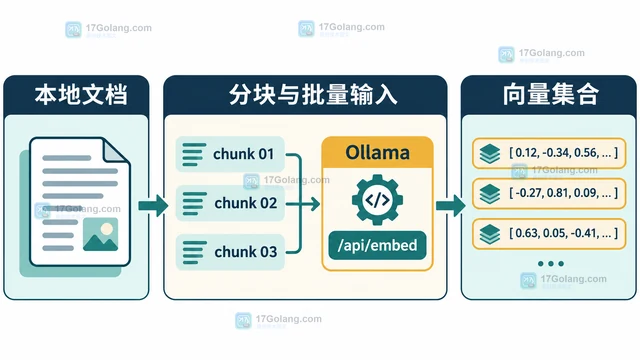 用 Ollama 的 /api/embed 把本地文档切成片段并批量转换为向量,保留文本、模型和元数据映射,再用同一模型生成查询向量完成语义检索。230 收藏
-
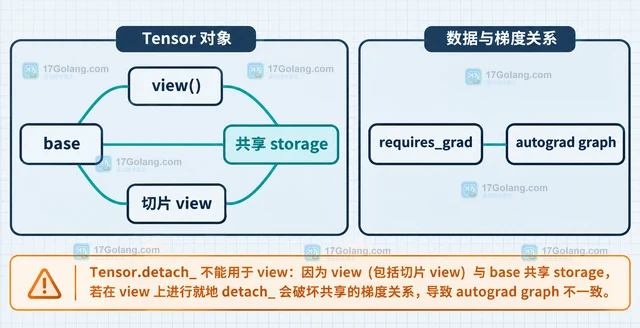 PyTorch 的 Tensor.detach_ 是原地切断计算图的方法,但 view 不能使用它。本文从共享底层数据的关系出发,说明 detach_、detach 和 clone().detach() 的选择边界。230 收藏