
人工智能技术文章
-
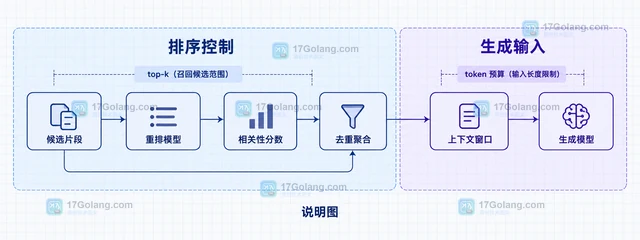 RAG 检索结果很多却答不准时,先区分召回缺失、候选过杂和上下文丢失,再从语义切块、混合召回、元数据过滤、重排和固定评测集逐层改进。208 收藏
-
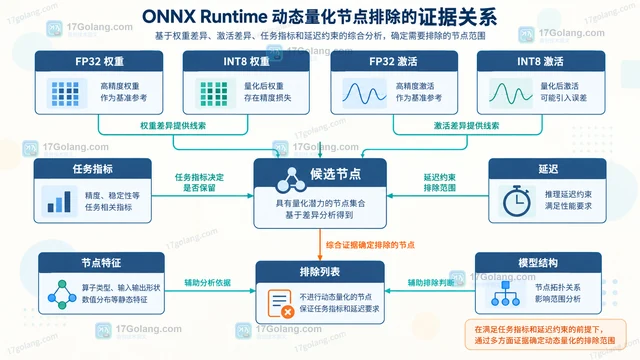 ONNX Runtime 动态量化中的 nodes_to_exclude 应按节点名称精确控制。本文给出节点清单、全量量化基线、差异定位、逐组复测和配置冻结的方法。377 收藏
-
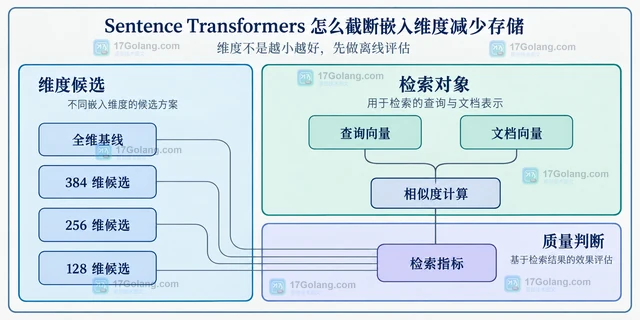 本文介绍如何用 Sentence Transformers 的 truncate_dim 与 truncate_embeddings 缩短嵌入向量,计算理论存储节省,并通过离线检索指标选择维度,说明 Matryoshka 模型、归一化、索引迁移和推理性能的边界。165 收藏
-
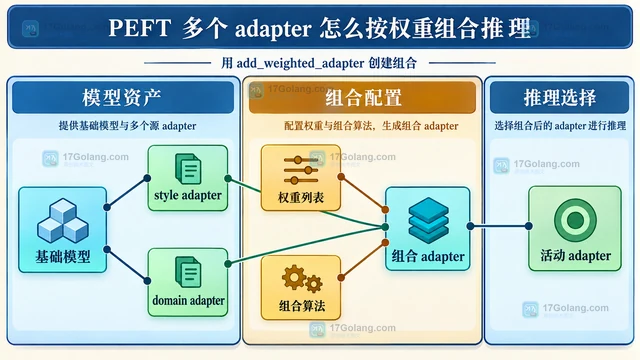 本文演示 PEFT 多个 LoRA adapter 的命名加载、加权组合与推理激活,说明 linear、cat、SVD、TIES 和 DARE 的选择边界及评测方法。454 收藏
-
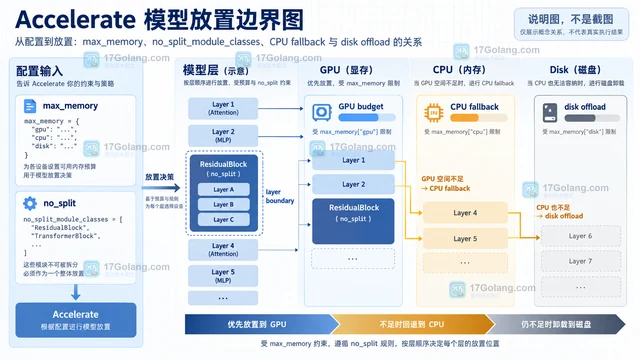 本文说明 Accelerate 如何用 device_map=auto 将大模型按显存分配到多块 GPU,并讲清 max_memory、不可拆分层、CPU 与磁盘回退以及多卡推理的性能边界。358 收藏
-
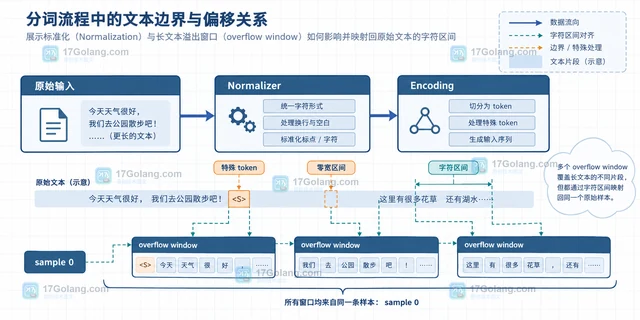 Tokenizers 的 offset mapping 本质是 token 到原始文本的半开字符区间。本文用 Fast Tokenizer 说明 return_offsets_mapping、特殊 token、空白、规范化和溢出窗口的定位方法。328 收藏
-
科技周边 · 人工智能 | 1个月前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
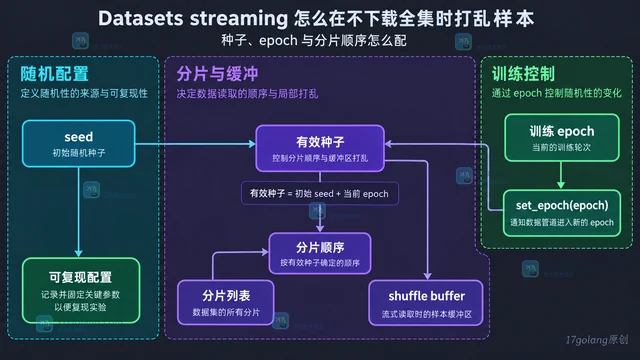 Hugging Face Datasets 的 streaming 模式可用 IterableDataset.shuffle 在有限缓冲区内随机采样,无需下载完整数据集。本文说明 buffer_size、seed、set_epoch、分片顺序以及 take/skip 的调用边界。470 收藏
-
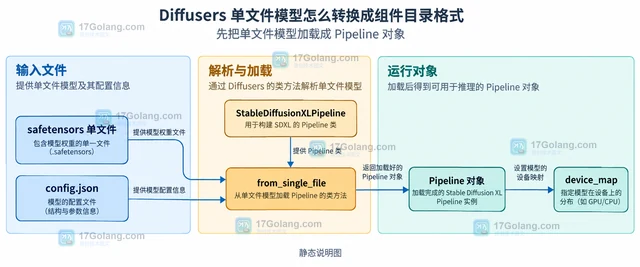 Diffusers 单文件模型不能靠改后缀变成组件目录。正确做法是用匹配的 Pipeline.from_single_file() 读取权重,再用 save_pretrained() 保存配置、组件子目录和权重文件;配置推断失败时显式提供 config。308 收藏
-
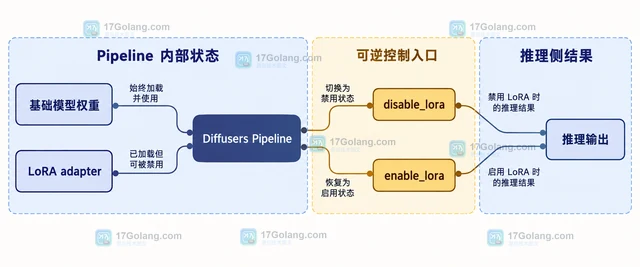 Diffusers 临时禁用 LoRA 不需要卸载权重,调用 disable_lora() 可回到基础模型推理,随后用 enable_lora() 恢复;本文同时区分卸载、删除和多适配器场景。309 收藏
-
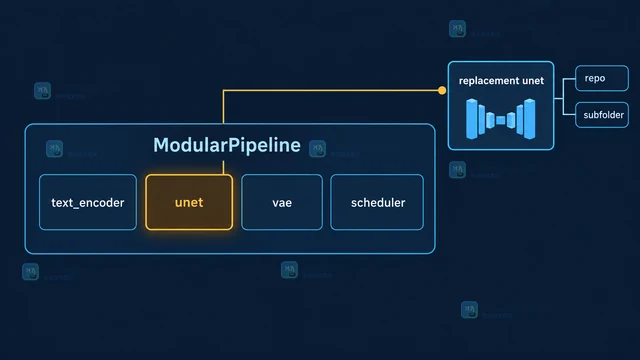 Diffusers ModularPipeline 替换单个模型组件时,应先取得组件规格并加载兼容对象,再用 update_components 更新同名槽位。本文说明两种替换写法、加载顺序、配置型组件区别和排错清单。175 收藏
-
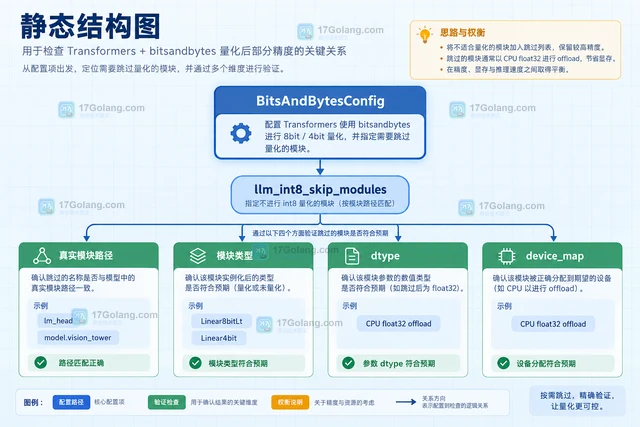 讲清 Transformers 使用 bitsandbytes 进行 8-bit/4-bit 量化时,如何用 llm_int8_skip_modules 保留指定模块,并区分跳过量化、dtype 与 CPU float32 offload。359 收藏
-
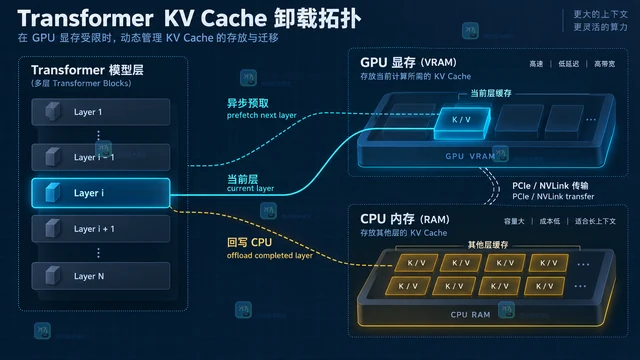 本文说明 Transformers 在显存不足时如何启用 KV cache 卸载,并给出直接配置、OOM 回退、方案选择与风险检查清单。499 收藏
-
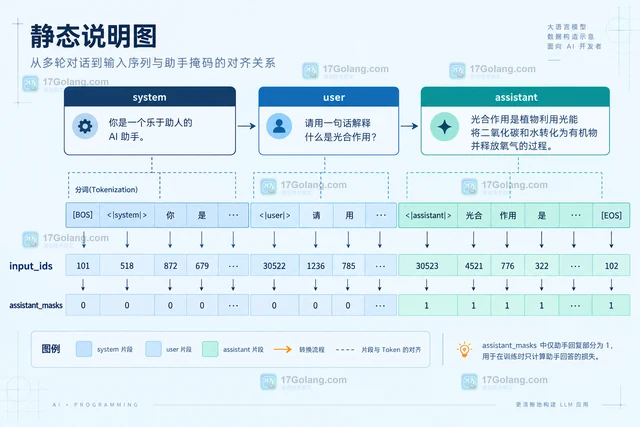 Transformers 的 apply_chat_template 可以通过 generation 块记录 assistant 内容,并返回与 input_ids 对齐的 assistant_masks。本文说明参数组合、模板写法、训练标签转换和全零掩码排查边界。164 收藏
-
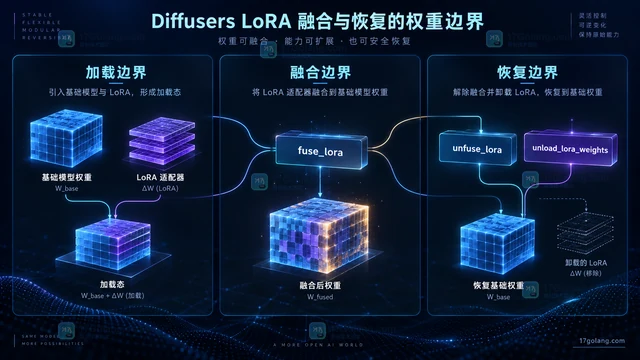 Diffusers 单个 LoRA 融合后可先 unfuse_lora 恢复基础权重,再卸载适配器;多 LoRA 或已保存重载的融合模型应重新加载原始基础模型。291 收藏
-
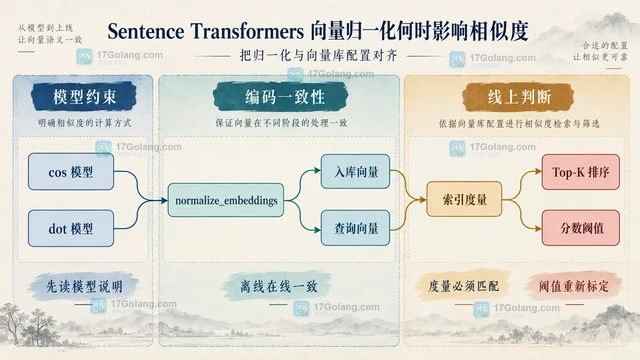 Sentence Transformers 的 L2 归一化不会改变余弦方向,但会改变原始点积和部分距离。本文用对照实验说明何时开启 normalize_embeddings。372 收藏