
人工智能技术文章
-
科技周边 · 人工智能 | 4星期前 | JSON · python · 人工智能 · 工程实践 · 结构化输出 · Pydantic JSON Schema AI 结构化输出 模型重试 兜底解析 大模型工程
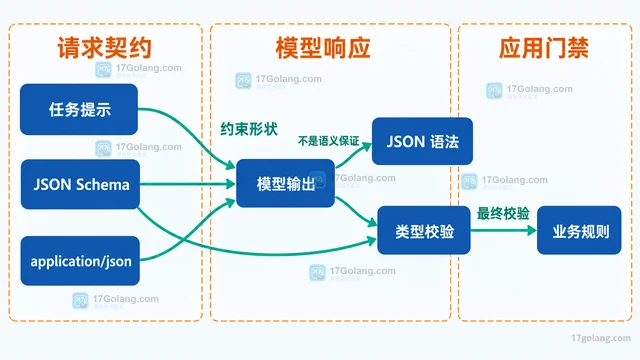 模型稳定输出 JSON 不能只靠提示词。本文用 JSON Schema、Pydantic 校验、分类重试与受控兜底解析,搭建一条可观测的结构化输出链路。250 收藏
-
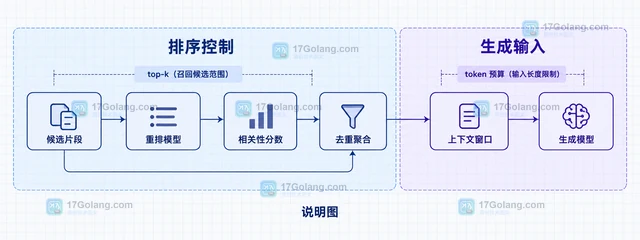 RAG 检索结果很多却答不准时,先区分召回缺失、候选过杂和上下文丢失,再从语义切块、混合召回、元数据过滤、重排和固定评测集逐层改进。208 收藏
-
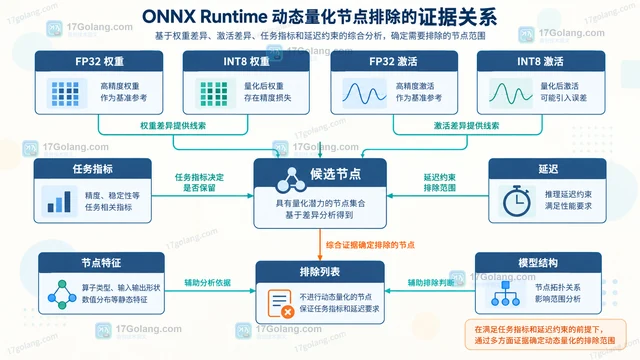 ONNX Runtime 动态量化中的 nodes_to_exclude 应按节点名称精确控制。本文给出节点清单、全量量化基线、差异定位、逐组复测和配置冻结的方法。377 收藏
-
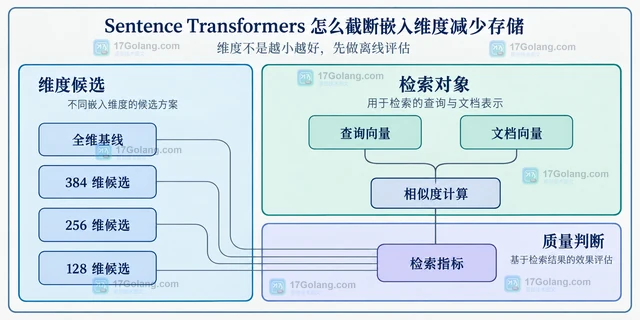 本文介绍如何用 Sentence Transformers 的 truncate_dim 与 truncate_embeddings 缩短嵌入向量,计算理论存储节省,并通过离线检索指标选择维度,说明 Matryoshka 模型、归一化、索引迁移和推理性能的边界。165 收藏
-
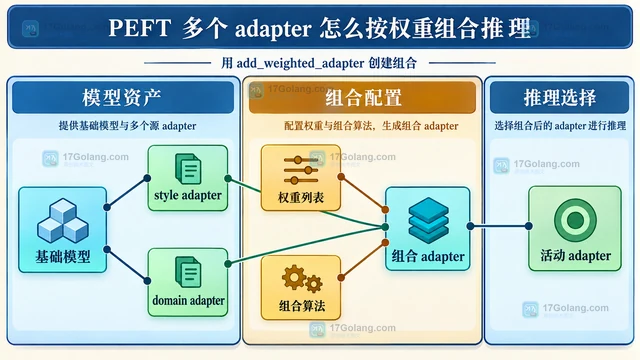 本文演示 PEFT 多个 LoRA adapter 的命名加载、加权组合与推理激活,说明 linear、cat、SVD、TIES 和 DARE 的选择边界及评测方法。454 收藏
-
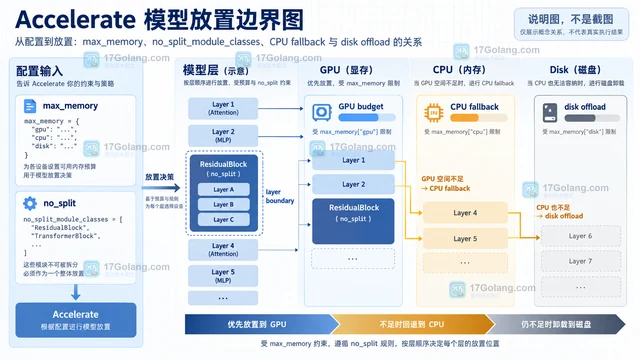 本文说明 Accelerate 如何用 device_map=auto 将大模型按显存分配到多块 GPU,并讲清 max_memory、不可拆分层、CPU 与磁盘回退以及多卡推理的性能边界。358 收藏
-
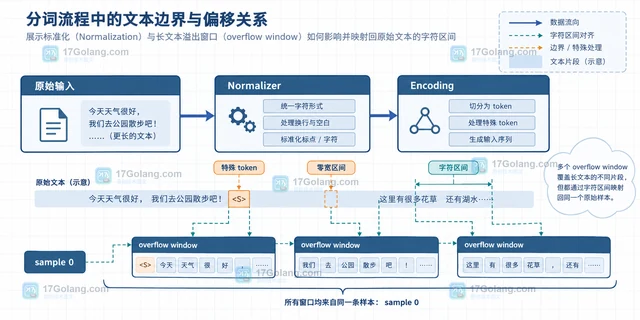 Tokenizers 的 offset mapping 本质是 token 到原始文本的半开字符区间。本文用 Fast Tokenizer 说明 return_offsets_mapping、特殊 token、空白、规范化和溢出窗口的定位方法。328 收藏
-
科技周边 · 人工智能 | 4星期前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
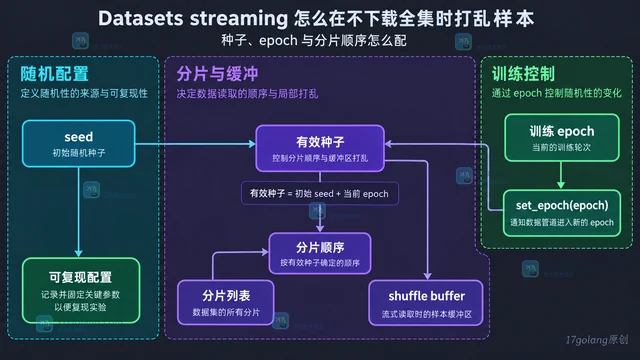 Hugging Face Datasets 的 streaming 模式可用 IterableDataset.shuffle 在有限缓冲区内随机采样,无需下载完整数据集。本文说明 buffer_size、seed、set_epoch、分片顺序以及 take/skip 的调用边界。470 收藏